Week 1: PyTorch의 기술적인 배경
PyTorch + NPU 온라인 모임 #1 | 2024-12-04
소개
이 강의는 PyTorch + NPU 랩의 첫 번째 온라인 모임으로, PyTorch의 기술적 배경을 다룹니다.
랩장은 리벨리온에서 SW를 개발하고 있으며, 컴파일러 연구/개발을 오랫동안 해왔습니다. 리벨리온 NPU를 PyTorch에 붙이는 일과 PyTorch Foundation에서 리벨리온을 대표하는 일을 하고 있고, PyTorch KR의 PyTorch Core SIG를 만들어 관심 있는 분들과 함께 커뮤니티 활동도 해볼 계획입니다.
랩 1기 목표
랩 차원의 목표로는 PyTorch internal에 관심 있는 사람들을 모으고, 함께 공부하고 성장하며, 공부한 결과를 강의자료로 정리하여 더 많은 사람들이 PyTorch internal을 쉽게 공부할 수 있도록 공유하는 것입니다. 개인적인 목표로는 공부한 내용을 바탕으로 리벨리온 NPU를 PyTorch에 더 잘 붙여보고, 많은 분들이 PyTorch upstream에 기여하여 한국이 PyTorch upstream에서 큰 지분을 가져갈 수 있기를 바랍니다.
ML Framework이란
ML Framework은 AI Ecosystem에서 다음과 같은 역할을 합니다:
- OS이자 - AI 가속기를 추상화된 computing resource로 제공
- Programming Language이자 - Model을 쉽게 작성할 수 있도록 API 제공
- Compiler - 작성된 모델을 computing resource로 mapping
이처럼 ML Framework에는 다양한 기술적인 background가 혼재되어 있습니다.
PyTorch, TensorFlow, JAX 같은 ML Framework은 모델을 기술하는 데 그치지 않고, GPU 같은 AI 가속기에서 모델을 효율적으로 실행해야 합니다. 프로그래밍 언어적 성격으로 모델을 직접 작성하고 제공하며, 컴파일러 역할로 AI 가속기에 그대로 매핑하는 대신 트랜스포메이션 과정을 통해 하드웨어 타겟에 최적화합니다.
ML Framework의 발전은 이전 연구와 산업적 성과가 축적된 결과입니다. 서로 다른 분야에서 발전한 기술적 흐름이 합쳐져 지금의 ML Framework를 구성하고 있습니다.
Q: PyTorch의 경우, ML 컴파일러의 이름이 있을까요?
PyTorch 1.x에도 TorchScript/JIT라는 컴파일 스택이 있었으며,
torch.jit.trace나torch.jit.script를 통해 모델을 컴파일할 수 있었습니다. 다만 일반적인 사용 방식은 연산을 즉시 실행하는 eager mode가 중심이었습니다. PyTorch 2.0에서는 **torch.compile()**을 통해 기존 Python 코드에 적은 수정만으로 컴파일 최적화를 적용할 수 있게 되었습니다. 내부적으로 TorchDynamo가 연산 그래프를 추출하고, AOTAutograd가 역전파 그래프까지 준비하며, 기본 컴파일러 백엔드인 TorchInductor가 그래프를 최적화하고 실행 코드를 생성합니다. GPU 코드 생성에는 주로 도메인 특화 언어(DSL)이자 컴파일러인 Triton을 활용합니다.
오늘 다룰 주제들
이 강의에서는 ML Framework의 기술적 배경과, 프레임워크들이 공통적으로 부딪혀온 설계 딜레마를 다룹니다.
ML Framework의 배경 기술:
- Heterogeneous computing with GPU - Graphics에서 GPGPU로의 발전
- Graphics: OpenGL (1992), DirectX (1995)
- GPGPU: HLSL (2002), CUDA (2007), OpenCL (2008), HSA (2012)
- Supercomputing - BLAS, MPI 등 고성능 컴퓨팅 기술
- Fast multiplication - BLAS (1979), cuBLAS (2007), CUTLASS (2018)
- Distributed programming - MPI (1994)
- ML compiler
- XLA (Google), TensorRT (NVIDIA), Apache TVM (OctoAI), Glow (Meta), etc
- Numerical Computing for Data Science - NumPy로 대표되는 도구 생태계
- Matlab (1970s), R (1993), NumPy (2005)
ML Framework 설계의 딜레마(Design Space):
- Two (or three) language problems
- Eager vs. graph mode: “define-by-run” vs. “define-and-run”
- Interpretation vs. JIT(Just in Time)/AOT(Ahead of Time) compilation
PyTorch에 통합된 기술: 앞에서 소개한 기술들이 PyTorch의 실행 및 컴파일 구조에 어떻게 반영되었는지 살펴봅니다.
ML Framework의 배경 기술
ML Framework은 서로 다른 뿌리를 가진 네 가지 기술적 흐름 위에서 만들어졌습니다. Heterogeneous computing, supercomputing, ML compiler, numerical computing을 하나씩 살펴봅니다.
Heterogeneous Computing with GPU
Heterogeneous Computing은 CPU와 GPU를 함께 활용하여 더 빠르게 계산할 수 있도록 해주는 시스템입니다. 일반적으로 CPU가 수행하던 계산 중 일부를 GPU에게 offloading하여 성능을 향상시키는 방식입니다.
ML Framework은 GPU 같은 AI 가속기를 써야 하므로, CPU와 AI 가속기를 함께 쓰는 Heterogeneous Computing 위에서 동작합니다.
Graphics에서의 시작
GPU 기반 heterogeneous computing은 GUI와 컴퓨터 게임을 위한 graphics 기술에서 발전했습니다.
- OpenGL (1992) - Silicon Graphics가 개발한 cross-platform Graphics API로, 이후 여러 운영체제와 산업용 그래픽스 소프트웨어에서 널리 사용되었습니다.
- DirectX (1995) - Microsoft가 개발한 Graphics API로, Windows PC와 게임 개발 환경에서 주요 표준으로 자리 잡았습니다. NVIDIA와 ATI(현재 AMD)는 이 시장의 성장과 함께 주요 GPU 업체로 성장했습니다.
Shader Programming의 등장 (2000년대 초)
2000년대 초에는 GPU 프로그래밍에 큰 변화를 가져온 Shader Programming이 등장했습니다. 이전에는 GPU가 fixed function만 수행할 수 있었지만, 이제 개발자가 GPU를 프로그래밍 가능한 디바이스로 활용할 수 있게 되었습니다.
- NVIDIA GeForce 3 (2001) - 최초로 Shader Programming을 지원한 GPU로, 하드웨어적으로 셰이더 기능을 도입했습니다.
- DirectX 9와 HLSL - Microsoft는 DirectX 9(2002)에서 High-Level Shading Language(HLSL)를 정의하여 개발자들이 고급 언어로 GPU를 프로그래밍할 수 있도록 지원했습니다.
Programmable shader의 도입으로 개발자가 GPU의 연산을 프로그램으로 기술할 수 있게 되었고, 이후 범용 GPU 계산으로 확장할 기반이 마련되었습니다.
GPGPU의 등장 (2007년)
2007년 NVIDIA는 CUDA(Compute Unified Device Architecture)를 발표해 GPGPU(General Purpose GPU) 프로그래밍의 사용 범위를 크게 확대했습니다.
- CUDA는 GPU를 위한 일반적인 parallel programming model로, 초기에는 High-Performance Computing(HPC) 시장을 타겟으로 했습니다. GPU의 성능이 슈퍼컴퓨터 수준에 가까워지면서, 이를 일반 개발자들이 활용할 수 있도록 CUDA를 도입한 것입니다.
- 이후 CUDA는 deep learning을 포함한 GPU 가속 워크로드에 널리 사용되었습니다.
이후 다른 플랫폼들도 등장했습니다:
- OpenCL (2008) - Apple이 주도
- HSA (2012) - AMD/ARM이 주도
OpenCL과 HSA도 heterogeneous computing을 지원하지만, NVIDIA GPU 기반 ML 및 HPC 환경에서는 CUDA가 가장 널리 사용됩니다. PyTorch도 CUDA backend를 통해 NVIDIA GPU를 지원합니다.
Supercomputing
슈퍼컴퓨팅은 매우 복잡한 계산을 처리하기 위한 고성능 컴퓨팅 기술입니다. 현재는 머신러닝도 대표적인 workload지만, 전통적으로 물리학 simulation, 천문학, 기후 modeling, 항공우주와 에너지 연구 같은 과학·공학 분야에서 사용되었습니다. 미국의 National Laboratory도 이러한 supercomputer로 대규모 과학 계산을 수행합니다.
슈퍼컴퓨팅과 인터넷 서비스의 차이
슈퍼컴퓨팅은 많은 수의 컴퓨터를 네트워크로 연결해 하나의 큰 계산을 분산 처리하는 방식으로 작동합니다. 구글의 데이터센터나 클라우드 기술도 유사한 구조를 가지고 있지만, 본질적인 차이가 존재합니다:
- 인터넷 서비스는 독립적이고 간단한 계산을 대량으로 처리하는 데 중점을 둡니다.
- 슈퍼컴퓨팅은 하나의 계산을 여러 컴퓨터에 분할하는 경우가 많아 작업 사이의 통신과 동기화가 필요합니다. 한 작업의 실패가 전체 job에 영향을 줄 수 있으므로 fault handling이 중요합니다.
머신러닝에서도 추론은 독립적인 작업이 많지만, 대규모 분산 학습은 하나의 작업이 매우 크기 때문에 fault 처리가 더 중요합니다.
병렬/분산 프로그래밍 모델
슈퍼컴퓨팅의 발전과 함께 다양한 병렬 및 분산 프로그래밍 모델이 등장했습니다:
- 개념적인 모델 - SIMD, SPMD, MIMD
- 구현 표준 - MPI, OpenMP
PyTorch의 torch.distributed는 MPI에서 널리 사용되는 rank, process, collective communication과 유사한 프로그래밍 모델을 제공합니다. 다만 PyTorch의 기본 분산 backend가 MPI 위에 구현된다는 의미는 아닙니다.
Matrix Multiplication
Matrix Multiplication은 과학 계산과 머신러닝에서 자주 사용되는 핵심 선형대수 연산입니다. BLAS는 matrix multiplication뿐 아니라 vector 및 matrix 연산을 함께 정의합니다.
행렬 곱셈의 연산량은 행렬 크기에 따라 N³에 비례하므로, 이를 얼마나 빨리 처리하느냐가 전체 시스템 성능을 크게 좌우합니다.
최적화 기술:
- Algorithmic efficiency 측면: Strassen algorithm, DeepMind의 AlphaTensor 등
표준 라이브러리 BLAS
- BLAS (Basic Linear Algebra Subprograms, 1979) - 다양한 linear algebra 문제에 적용할 수 있는 low-level API로, Matrix multiplication을 위한 GEMM(General Matrix Multiply)을 포함합니다.
- 각 HW vendor들은 자사 하드웨어에 최적화된 BLAS 구현을 출시합니다:
- NVIDIA:
- cuBLAS (2007, closed-source): NVIDIA GPU에 최적화된 BLAS 구현
- CUTLASS (2018, open-source): GEMM 등을 위한 고성능 GPU 커널을 구성하고 사용자 요구에 맞게 특수화할 수 있는 오픈소스 CUDA C++ 템플릿 라이브러리
- NVIDIA:
ML Compiler
ML Compiler는 정적인 graph로 전환된 ML model을 특정 hardware에 맞게 최적화해주는 컴파일러입니다.
Eager 방식의 ML Framework에서는 model의 연산이 실행 중에 결정됩니다. ML compiler를 적용하는 과정은 다음과 같습니다:
- model의 전체 또는 일부 연산을 graph로 표현하고
- 이를 ML compiler가 이해할 수 있는 중간 표현(IR)으로 변환하여
- 최종적으로 HW에서 실행할 수 있는 코드를 생성합니다.
On-Device AI에서의 활용
서버에서 GPU로 훈련된 모델을 On-Device AI 가속기에서 수행하기 위해 많이 쓰이며, Qualcomm Snapdragon, Samsung Exynos, Google Tensor 등이 대표적입니다.
서버에서의 활용 확대
서버용 가속기에서도 ML compiler를 씁니다:
| 하드웨어 | 프레임워크 | 컴파일러 |
|---|---|---|
| Google TPU | TensorFlow, JAX | XLA |
| NVIDIA GPU | TensorFlow, PyTorch | TensorRT (inference), XLA/Inductor 등 |
| Rebellions NPU | TensorFlow, PyTorch | RBLN Compiler |
PyTorch 2.0은 torch.compile을 통해 graph capture와 backend compilation을 기본 API에 통합했습니다.
PyTorch에서의 ML Compiler
PyTorch 1.x에서도 JIT Trace가 모델을 정적 형태로 변환해주는 역할을 했지만, 본격적인 ML 컴파일러로서의 역할은 제한적이었습니다.
PyTorch 2.0에서는 ML 컴파일러 기능이 대폭 강화되었습니다:
- Dynamo - JIT Trace를 대체하는 컴포넌트로, 컴파일러와 유사한 역할 수행
- Inductor - 본격적인 ML 컴파일러로, 모델 최적화 및 하드웨어 실행 효율화 담당
- Triton - 도메인 특화 언어(DSL)로, GPU를 위한 커널 최적화 작업에 활용
Numerical Computing for Data Science
Data science는 통계, 컴퓨터 과학, 수학 등의 도구를 활용하여 데이터를 분석하고 대상을 이해하는 융합 학문입니다. 많은 과학자/엔지니어들이 업무의 일부로 자연스럽게 data scientist 역할을 수행합니다.
Data Scientist가 선호하는 도구의 특성
Data scientist들은 특정 프로그래밍 언어 자체보다는, 이미 존재하는 데이터를 손쉽게 가공하고 필요한 정보를 얻어내는 데 더 관심을 둡니다. 그래서 다음과 같은 특성을 갖춘 도구를 선호합니다:
- Predefined math functions - 복잡한 수학 함수를 직접 구현하는 대신 활용할 수 있는, 미리 정의된 수학 함수들
- Interactive mode - 긴 코드를 작성하고 실행하는 대신, 데이터를 즉시 처리하고 결과를 확인하는 대화형 작업 방식
- Visualization - 시각화 도구
NumPy의 등장과 Python의 부상
SAS (1966), SPSS (1968), Matlab (1970s), R (1993) 등이 선구적인 역할을 했으나, NumPy (2005)의 등장과 함께 Python이 대세로 자리잡았습니다. SciPy, Matplotlib, pandas, scikit-learn 등의 생태계가 형성되었고, Jupyter의 등장으로 더욱 많은 사람들이 쉽게 접근할 수 있게 되었습니다.
ML Framework도 사용성에서 같은 길을 따랐습니다. TensorFlow와 PyTorch의 tensor API는 NumPy와 공통점이 많습니다.
NumPy API는 PyTorch의 tensor API 설계에 영향을 주었고, NumPy 창시자 Travis Oliphant가 설립한 Quansight도 PyTorch 2.x 개발에 기여했습니다. torch.compile은 일부 NumPy 프로그램을 TorchDynamo로 분석하고 PyTorch 연산으로 변환한 뒤 Inductor backend로 컴파일할 수 있습니다. NVIDIA GPU에서는 Inductor가 일반적으로 Triton kernel 등을 생성하며, 지원 범위는 사용하는 NumPy 연산에 따라 달라집니다.
ML Framework 설계의 딜레마(Design Space)
배경 기술을 하나의 프레임워크로 통합하는 과정에서, 모든 ML Framework은 공통적인 설계 선택지들과 마주쳤습니다. 언어 문제, eager vs. graph mode, 그리고 graph를 추출하는 방법을 중심으로 살펴봅니다.
Two (or More) Language Problems
Python은 사용하기 쉽지만 성능 문제가 있습니다. 이를 해결하기 위한 세 가지 접근법이 있습니다:
해결책 #1: 고성능 Python compiler를 개발
- Cython의 성능이 점점 좋아지고 있으며, PyPy같은 대안 프로젝트도 존재합니다.
해결책 #2: Python 언어를 증강
- Modular의 Mojo 프로젝트가 대표적인 시도입니다.
해결책 #3: 다른 언어로 작성된 모듈과 binding
- C/C++ 모듈을 Python에 연결하며, NumPy는 CPython C API를, PyTorch는 CPython C API와 pybind11을 함께 사용합니다.
- 추가로 AI 가속기로 offloading하여 성능을 극대화합니다.
Eager vs. Graph Mode
Eager mode
API 호출 시 operator가 곧바로 실행됩니다.
Graph mode
API 호출 시 graph를 점진적으로 생성합니다. Graph가 완성되면 목적에 맞게 변환을 적용한 후 수행합니다:
- Back propagation을 위한 backward graph 생성
- 성능 향상을 위한 최적화 수행 (예: op fusion)
Eager execution 중에도 graph 자료구조를 사용할 수 있습니다. 예를 들어 autograd가 활성화되면 forward 연산은 즉시 실행되면서 backward 계산에 필요한 동적 autograd graph가 함께 기록됩니다. 이후 backward propagation은 이 graph의 Function node를 따라 실행됩니다. 이 동적 autograd graph는 torch.compile의 JIT 방식으로 캡처하여 최적화·컴파일하는 연산 graph와는 목적과 역할이 다릅니다.
Graph mode를 접근하는 방법
TF1의 접근법 (define-and-run)
- 개발자가 graph를 명시적으로 구성한 뒤 실행
PyTorch, TF2, JAX의 접근법 (define-by-run)
- 개발자는 일반적인 코드로 model의 연산을 작성
- 프레임워크가 코드 분석이나 tracing을 통해 컴파일에 필요한 graph를 추출
TF2와 PyTorch는 Eager, Graph 모두 가능합니다. JAX도 기본적으로는 eager로 실행되지만, jax.jit으로 감싼 함수는 tracing을 거쳐 그래프로 컴파일됩니다.
TF1 vs. PyTorch 코드 비교
TF1
a = tf.constant([[3, 3]])
b = tf.constant([[2], [2]])
c = tf.matmul(a, b)

with tf.Session() as sess:
    print(sess.run(c))
TensorFlow 1.x에서는 tf.constant와 tf.matmul 같은 연산자들이 실제 계산을 수행하지 않고, 계산 과정을 그래프로 만듭니다. c를 평가하기 전까지는 실제 값을 알 수 없으며, Session을 생성한 뒤 sess.run(c)(또는 c.eval())를 호출해야 비로소 계산 결과를 얻을 수 있습니다.
PyTorch
x1 = torch.rand(2, 3)
x2 = torch.rand(2, 3)
y = x1 + x2
print(y)
PyTorch의 eager mode에서는 각 줄의 연산이 즉시 수행되고, y에는 +의 결과가 바로 들어 있습니다. 별도의 그래프 실행 단계는 없습니다.
Graph Capture: TF2와 PyTorch 비교
그래프 모드에서는 그래프를 어떻게 얻을지부터 정해야 합니다. TF1은 개발자가 그래프를 직접 구성하게 했고, TF2와 PyTorch는 eager 모드로 작성한 코드에서 프레임워크가 그래프를 추출합니다.
TF2
@tf.function
def foo(x, y):
    a = tf.sin(x)
    b = tf.cos(y)
    return a + b

x = tf.random.uniform((3, 4))
y = tf.random.uniform((3, 4))

foo(x, y)
TF2는 기본이 eager 모드이며, @tf.function 데코레이터를 붙인 함수를 처음 호출하는 시점에 함수 내부 연산이 trace되어 그래프로 캡처됩니다. 개발자는 eager 스타일로 코드를 작성하고, 프레임워크가 그래프 추출을 담당하는 define-by-run 구조입니다.
PyTorch 1 & 2
def foo(x, y):
    a = torch.sin(x)
    b = torch.cos(y)
    return a + b

x = torch.rand(3, 4)
y = torch.rand(3, 4)

# PyTorch 1
traced_foo = torch.jit.trace(foo, (x, y))
traced_foo(x, y)

# PyTorch 2
optimized_foo = torch.compile(foo)
optimized_foo(x, y)
PyTorch 1.x와 2.x 모두 eager execution을 기본 실행 방식으로 지원합니다. PyTorch 1.x에서는 torch.jit.trace로 graph를 생성할 수 있었고, PyTorch 2.x에서는 eager semantics를 유지하면서 선택적으로 적용하는 torch.compile을 도입했습니다. TorchDynamo는 Python bytecode를 분석해 컴파일 가능한 FX graph 구간을 생성합니다.
Interpretation vs. JIT/AOT Compilation
Eager vs. graph mode가 “graph를 만드는가”의 축이라면, 이 축은 “코드를 언제 기계어로 바꾸는가”의 축입니다. 두 축은 독립적이며, graph mode는 JIT로도 AOT로도 구현할 수 있습니다.
| 방식 | 컴파일 시점 | PyTorch 2.x | 얻는 것 | 치르는 것 |
|---|---|---|---|---|
| Interpretation | 없음. Python interpreter가 op을 하나씩 실행하고, 각 op은 미리 빌드된 kernel을 호출 | Eager mode | 디버깅, 동적 제어 흐름 | op마다 Python·dispatch 비용, op 간 최적화 불가 |
| JIT (Just in Time) | 첫 실행 시점. 실제 shape·dtype을 보고 컴파일 | torch.compile | 런타임 정보에 특화된 코드, 코드 수정 최소 | warmup 시간, guard 실패 시 재컴파일 |
| AOT (Ahead of Time) | 실행 전. 배포용 artifact를 생성 | torch.export로 graph를 얻고 AOTInductor(torch._inductor.aoti_compile_and_package)로 컴파일 | Python 없이 C++ runtime에서 실행, 시작 지연 없음 | 입력 shape 등 가정을 미리 고정해야 함 |
뒤의 “Backend Integration Points” 표는 이 구분을 전제로 hardware 연결 지점을 나눕니다.
Eager 프로그램에서 실행 그래프를 얻는 관련 기법
프로그램의 실행 경로와 데이터 의존성을 분석하고 활용하는 기법은 컴파일러와 하드웨어 양쪽에서 발전해 왔습니다.
- Trace scheduling for VLIW compiler (1981): 선택한 실행 경로를 중심으로 명령어를 정적으로 재배치
- Out-Of-Order Execution in Pentium Pro (1995): 데이터 의존성을 지키면서 준비된 명령어부터 실행
- Trace cache (1996): 실행 경로를 따라 나타나는 명령어열을 캐시에 저장
- Chrome V8 Engine (2008): 런타임 정보를 활용하는 최적화 JIT로 발전
Fisher, J.A. “Trace Scheduling: A Technique for Global Microcode Compaction” IEEE Trans. on Computers, 1981
PGO(Profile-Guided Optimization)는 프로그램의 동적인 특성을 컴파일 타임에 활용해 최적화를 수행하는 더 넓은 개념이며, 트레이스 스케줄링은 PGO에서 사용하는 특정 기법 중 하나입니다. 동적인 실행 경로(Trace)를 추출하여 브랜치 예측을 통해 자주 실행되는 경로를 추적하고, 이 경로에 최적화된 스케줄링을 수행합니다. 양질의 프로파일 데이터가 필요하며, 올바른 트레이스를 만들어 롤백 없이 효율적인 성능을 제공하는 것이 핵심입니다.
PyTorch에 통합된 기술
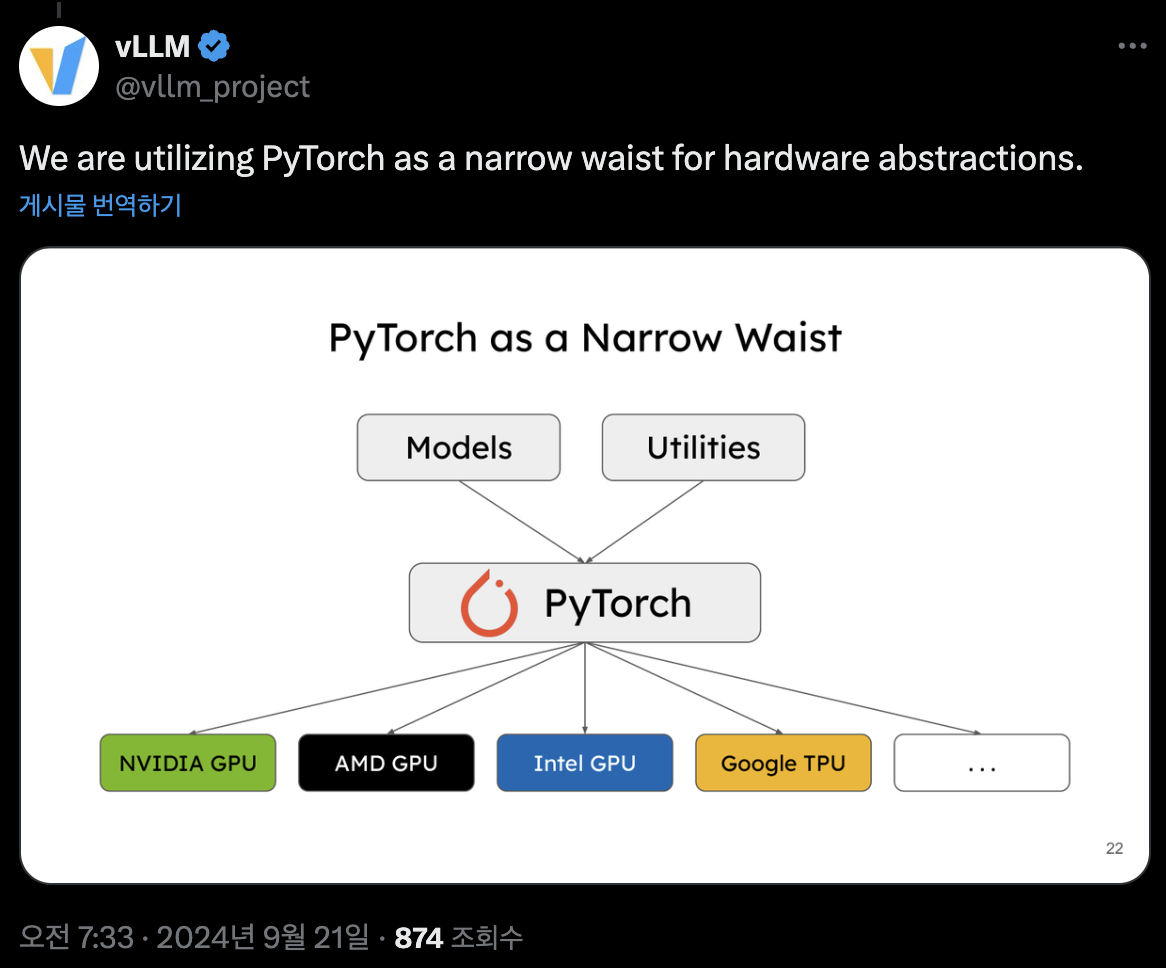
PyTorch는 앞에서 설명한 numerical computing API, heterogeneous execution, distributed communication, graph capture 및 compiler backend를 하나의 framework에서 제공합니다.
vLLM은 이러한 통합 구조를 활용하는 사례입니다. vLLM의 hardware plugin은 가능한 경우 device-specific 기능을 PyTorch backend와 custom operator로 제공하고, 상위 serving engine은 공통 PyTorch interface를 사용합니다. 이 구조에서 PyTorch는 여러 framework와 hardware backend 사이의 공통 interface, 곧 “Narrow Waist” 역할을 합니다.
PyTorch 2.0
PyTorch 2.0은 PyTorch 1.0의 특성을 거의 모두 계승(inherit)하면서, 앞서 다룬 여러 기술적 배경을 종합하여 구현된 프레임워크입니다.
핵심 특징:
- NumPy-like experience - 텐서 구조, 사전 정의된 수학 함수, 대화형 환경, Jupyter Notebook 호환성
- Heterogeneous computing as an underneath foundation - CPU와 GPU/NPU 같은 가속기를 함께 쓰는 실행 모델이 프레임워크의 토대. tensor가 device 정보를 가지며, 같은 op이라도 device에 따라 다른 구현이 실행되는 구조의 기반이 됨
- MPI-like distributed programming model - MPI에서 정립된 collective communication 스타일(broadcast, all-reduce 등)의 분산 프로그래밍을
torch.distributed로 기본 지원 - Integration with compute libraries / ML compiler - PyTorch 1.0부터 Eager mode에서는 컴퓨팅 라이브러리를 사용하고, PyTorch 2.0에서는 Graph mode에서 ML 컴파일러와의 통합을 핵심 과제로 다루고 있음
- Three language layers: Python → C++ → kernel language (예: CUDA, Triton) - 단순한 2개 언어가 아니라 제3 랭귀지 또는 멀티 랭귀지 솔루션 (Python API + C++ 구현 + CUDA/Triton kernel). 스크립팅은 Python으로 이루어지지만, 하위 레벨에서는 성능 최적화를 위해 C++로 전환되며, GPU/TPU/NPU 등의 하드웨어에서는 커널 레벨의 최적화 성능을 제공
- Define-by-run with graph capturing via TorchDynamo - Eager mode 중심으로 Graph mode를 부드럽게 지원
- Support both training and inference - Graph mode(컴파일) 경로가 inference뿐 아니라 training까지 쉽게 활용할 수 있게 된 것이 PyTorch 2.0에서 가장 크게 변화한 부분
Backend Integration Points
PyTorch에서 새 hardware backend를 연결하는 지점은 세 곳입니다:
| 접점 | 입력 단위 | 연결 층 |
|---|---|---|
| ① Eager mode | 개별 ATen op | ATen dispatcher의 새 dispatch target |
| ② Graph mode (JIT: torch.compile / AOT: torch.export) | FX graph (ExportedProgram) | TorchDynamo가 뽑은 graph를 받는 backend |
| ③ Graph mode (codegen) | Inductor의 loop-level IR | Inductor의 device별 code generator |
①은 2주차(dispatcher), ②는 3주차(Dynamo backend)에서 자세히 다룹니다.
Q&A
TorchScript와 Python/C++ 관계
Q: TorchScript는 Python과 C++ 사이에 위치해 있다고 봐도 되나요?
그렇게 보기는 어렵습니다. TorchScript는 Python과 C++ 사이의 binding layer가 아니라 PyTorch 프로그램을 직렬화 가능한 graph 형태로 변환하던 compilation 방식입니다. 현재 TorchScript는 deprecated 상태이며, 새로운 export 용도에는 torch.export 사용이 권장됩니다.
CUDA와 Triton의 차이점
Q: CUDA와 Triton은 어떻게 다른가요?
- 라이선스: CUDA는 proprietary, Triton은 오픈소스
- 설계 목적: CUDA는 범용 GPU 컴퓨팅, Triton은 고성능 텐서 연산 커널 개발
- 작성 방식: CUDA C++는 C++ 확장 문법으로, Triton은 Python 기반 DSL과 @triton.jit으로 커널을 작성
- 프로그래밍 모델: CUDA C++는 스레드 중심, Triton은 데이터 블록(타일) 중심
- 최적화 방식: CUDA C++는 세밀한 직접 제어, Triton은 컴파일러 자동화에 중점
Triton은 단순한 Python API가 아니라 Python syntax를 사용하는 kernel programming DSL입니다. PyTorch Inductor는 NVIDIA GPU용 kernel을 생성할 때 Triton을 주요 code generation backend 중 하나로 사용합니다. 이는 모든 PyTorch operator나 모든 hardware backend가 Triton을 사용한다는 의미는 아닙니다.