Week 7: CPU / GPU / NPU
PyTorch + NPU 온라인 모임 #7 | 2025-02-12
소개
지금까지의 강의는 주로 소프트웨어적인 측면(PyTorch, 컴파일러, 모델 최적화 등)을 다뤘습니다. 이번 시간은 시리즈 전체에서 처음으로 하드웨어에 초점을 맞추는 강의이며, 다음 주에는 그동안 다룬 내용들을 실무와 연결지으며 시리즈를 마무리할 예정입니다.
오늘 다룰 주제들
오늘 강의는 “CPU, GPU, NPU가 어떻게 다른가”라는 질문에서 출발합니다. “GPU가 병렬 처리에 좋다”는 수준의 답을 넘어 프로세서 설계 철학의 차이를 이해하는 것이 목표이며, 강의 전체를 관통하는 주제는 latency hiding - 느린 하드웨어 구간(특히 메모리 접근)을 감추며 throughput을 끌어올리는 방법 - 입니다. Pipelining의 단위를 instruction → loop → thread로 키워가며 이 질문에 답합니다.
- Processor stack - 개발자의 코드가 datapath까지 도달하는 구조, 그리고 “하드웨어 디테일을 어디까지 개발자에게 노출할 것인가”라는 설계의 핵심 질문
- Latency, throughput, latency hiding - 강의 전체를 관통하는 개념 정리
- Instruction-level pipelining - 5-stage pipeline과 branch prediction으로 보는 latency hiding의 첫 사례
- Loop-level pipelining - 같은 문제를 푸는 두 갈래의 등장
- OOO(Out-Of-Order) Processor: 하드웨어가 동적으로 스케줄링
- VLIW: 소프트웨어(컴파일러)가 정적으로 스케줄링
- Thread-level pipelining - OOO vs. VLIW의 대비가 그대로 이어지는 지점
- Multi-Core로 전환한 CPU를 거쳐, massive parallelism과 warp 스케줄링으로 latency를 하드웨어가 동적으로 숨기는 GPU(OOO의 갈래)
- 실행 계획을 컴파일러가 정적으로 미리 짜 두는 NPU(VLIW의 갈래)
- OOO : VLIW = GPU : NPU 비례식으로 이해하는, NPU가 GPU와 다른 프로그래밍 모델을 요구하는 이유
- Hopper·Blackwell GEMM kernel - TMA, Warp Specialization과 software pipeline을 이용한 명시적 Latency Hiding
다만 프로세서의 세계는 실제로는 훨씬 다양하므로, 이 강의의 CPU/GPU/NPU 구분은 절대적인 정답이 아니라 설계 철학을 이해하기 위한 하나의 큰 틀로 받아들이는 편이 좋습니다.
Processor Stack: 개발자에서 Datapath까지
프로세서의 동작을 이해하려면, 개발자가 작성한 코드가 실제 하드웨어에서 실행되기까지 거치는 계층 구조를 먼저 파악해야 합니다. 컴퓨터라는 큰 세계는 맨 밑의 트랜지스터부터 개발자가 바라보는 프로그래밍 언어까지 한 번에 직접 연결되어 있는 것이 아니라, 그 사이에 여러 단계의 추상화 레이어를 거치도록 구성되어 있습니다.


이 스택에서 Programming Language와 Compiler는 소프트웨어 영역에 해당하고, ISA(Instruction Set Architecture)와 Control Logic, Datapath는 하드웨어 영역에 해당합니다. 특히 Control Logic과 Datapath를 합쳐서 Microarchitecture라고 부릅니다.
프로세서 설계의 핵심 질문
프로세서마다 접근 방식은 다르지만 답하려는 질문은 같습니다. 맨 아래의 하드웨어를 개발자에게 어떻게 노출할 것인가입니다.
성능은 맨 아래 Datapath에서 결정됩니다. 그러나 트랜지스터 수준은 너무 낮고, Datapath의 디테일을 모두 개발자에게 노출할 수도 없습니다. 그래서 어느 계층에선가 추상화가 필요하고, 그 계층을 어디에 두느냐에 따라 프로세서 설계가 갈립니다.
추상화 수준에 따른 세 가지 접근 방식
이 질문에 대한 답은 크게 세 가지 접근 방식으로 나뉘며, 이들은 두 개의 큰 관점으로 묶어볼 수 있습니다. 위 그림의 우측에 있는 ①②③ 화살표가 각 접근 방식이 추상화를 어느 레이어까지 끌어올리는지를 보여줍니다.
관점 A: 개발자가 HW Detail을 알 필요가 없게. 추상화의 무게를 하드웨어 내부 또는 컴파일러에 두어, 개발자는 단순한 ISA만 보고 코드를 작성하면 되도록 합니다.
- Microarchitecture 수준의 최적화에 의존 (그림의 ①: Control Logic까지 추상화): 하드웨어의 복잡성을 하드웨어 내부에서 모두 추상화하고, 개발자에게는 간단한 ISA만 노출합니다. 파이프라이닝, 분기 예측, 캐시 등 Microarchitecture 수준의 최적화에 성능을 맡기는 방식입니다.
- Compiler 수준의 최적화에 의존 (그림의 ②: Compiler까지 추상화): 하드웨어의 복잡성은 그대로 노출하되, 그것을 사용 가능한 형태로 추상화하는 일은 컴파일러가 수행합니다. 프로세서와 컴파일러를 짝으로 함께 설계하는 접근입니다.
관점 B: 개발자가 HW 특성을 고려하여 짤 수 있도록. 최적화 결정은 개발자가 내린다는 입장입니다.
- 최적화 목적에 맞는 Programming Model 제공 (그림의 ③: Developer까지 노출): Datapath의 중요한 특성을 개발자에게 직접 노출하고, 그 디테일을 잘 다룰 수 있는 프로그래밍 모델을 함께 제공하여 개발자가 하드웨어 특성을 고려하며 코드를 작성하도록 지원합니다.
이 세 접근 방식의 차이가 CPU, GPU, NPU의 설계 차이로 이어집니다.
무어의 법칙과 ISA/Microarchitecture의 분리
추상화 레이어는 왜 이렇게 많아졌을까요? 하드웨어 안에서도 소프트웨어에 보이는 ISA와 그 아래 Datapath가 분리되어 있습니다. 이 분리가 생긴 이유부터 봅니다.
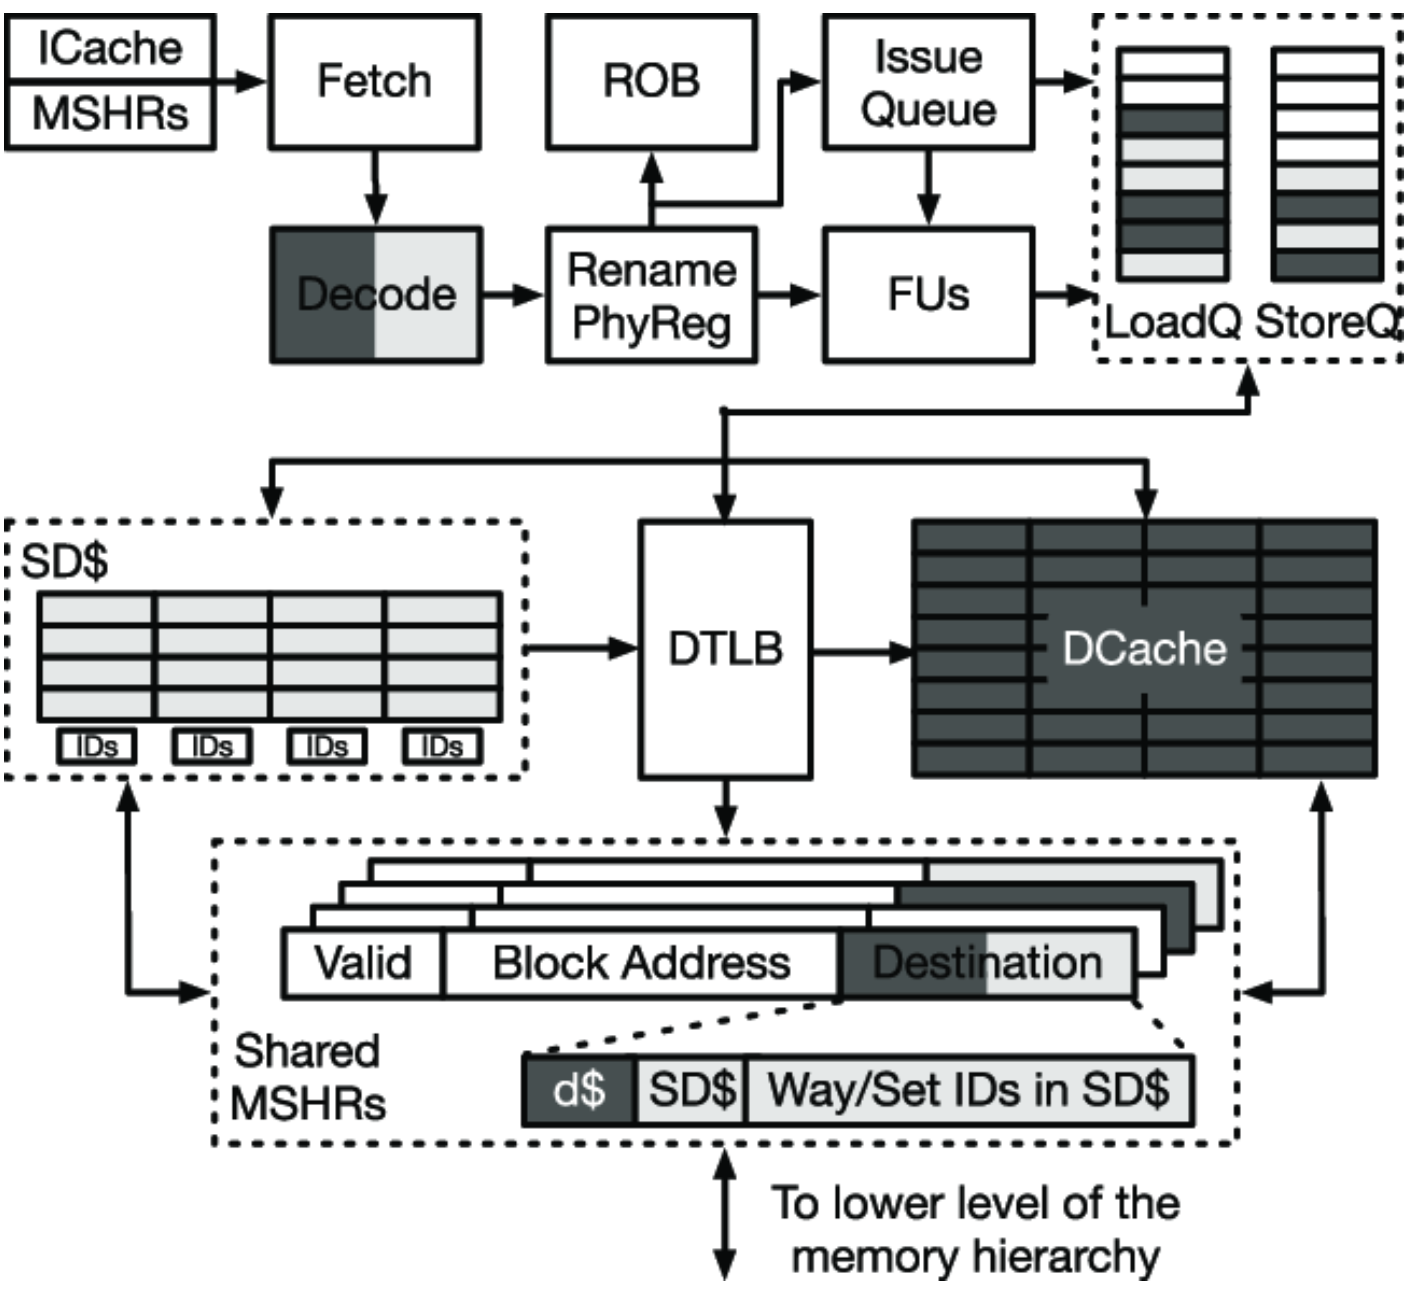
그 배경에는 무어의 법칙이 있습니다. 무어의 법칙이 활발히 작동하던 시절에는 트랜지스터 수가 약 2년마다 두 배씩 늘어났고, 그렇게 늘어난 트랜지스터로 더 많은 컴포넌트를 집적해 프로세서가 점점 더 많은 일을 처리하도록 만들 수 있었습니다. 그 결과 하드웨어, 특히 Datapath는 세대마다 점점 더 복잡해졌습니다. 위 그림은 현대 OOO 코어의 블록도인데, 이 블록 중 ISA에 드러나는 것은 하나도 없습니다. 각 블록이 무엇인지는 뒤의 OOO 절에서 다룹니다.
이 복잡해진 Datapath의 모든 디테일을 그대로 소프트웨어에 노출하는 것은 비현실적이었습니다. 노출해야 할 정보의 양이 너무 많아질 뿐 아니라, 세대가 바뀔 때마다 소프트웨어가 같이 바뀌어야 하기 때문입니다. 그래서 하드웨어 디테일과, 소프트웨어가 그것을 쓰는 방식이 분리되기 시작했습니다.
이렇게 분리된 결과, ISA는 소프트웨어가 바라보는 안정적인 인터페이스로 유지되고, ISA 아래의 하드웨어 디테일(즉 Control Logic + Datapath를 묶은 Microarchitecture)은 세대마다 자유롭게 변경할 수 있게 되었습니다. Microarchitecture라는 용어는 컴퓨터 아키텍처나 컴파일러 분야에서는 익숙한 개념이지만, 상위 애플리케이션 레이어에서 일하는 분들에게는 조금 생소할 수 있습니다. 그냥 “ISA 아래에 있는 하드웨어 디테일” 정도로 이해해도 충분합니다.
Latency, Throughput, 그리고 Latency Hiding
이 강의는 NPU가 GPU와 어떻게 다른가를 Latency Hiding이라는 공통 축으로 비교합니다. 먼저 Latency Hiding의 두 기본 개념, Latency와 Throughput을 정리합니다.
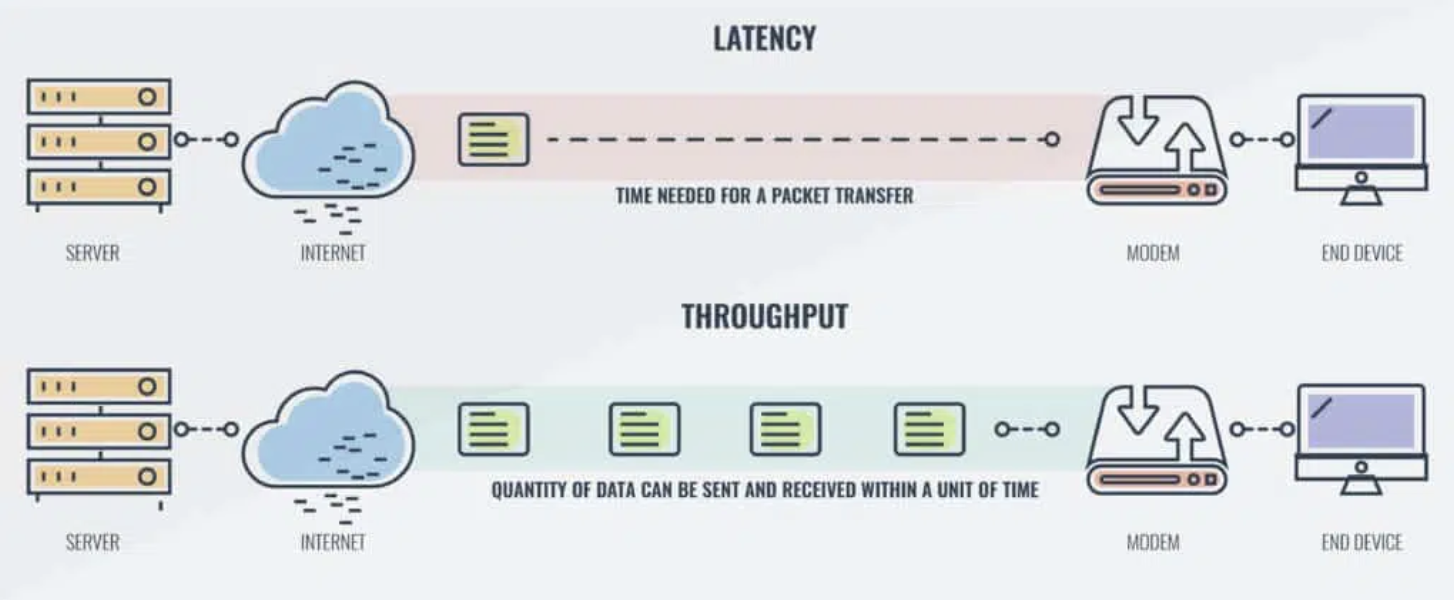
- Latency: 하나의 작업을 완료하는 데 걸리는 시간.
- Throughput: 단위 시간당 처리되는 작업의 양, 즉 얼마나 빠른 속도로 작업이 처리되는가.
직관적으로 보면 하나의 작업을 처리하는 데 걸리는 시간(Latency)이 짧을수록 단위 시간당 처리량(Throughput)이 늘어나는 것은 당연합니다. 단일 작업만 처리하는 경우라면 두 값은 거의 일대일로 연결되어 있죠. 그러나 항상 그렇지는 않습니다.
Latency Hiding & Parallelism


위 그림은 같은 길이의 작업이라도 처리 방식에 따라 Throughput이 어떻게 달라지는지를 보여줍니다.
- 단일 작업 처리 (위): 한 번에 하나의 작업밖에 처리할 수 없는 상황입니다. 이 경우 하나의 작업을 끝내는 데 걸리는 시간(Latency)이 그대로 Throughput에 직접적인 영향을 줍니다.
- 동시 작업 처리 (아래): 여러 작업을 동시에 처리할 수 있는 상황입니다. 이때는 개별 작업의 Latency 자체보다, 얼마나 빠르게 다음 작업을 새로 시작할 수 있는가가 Throughput을 결정합니다.
물론 이렇게 동시 처리가 가능하려면, 한 작업이 끝나기 전에 다른 작업을 시작할 수 있어야 합니다. 즉 작업 간 의존성이 없어야 합니다. 이 조건만 만족된다면, 개별 작업의 Latency가 길어도 Throughput은 충분히 높일 수 있습니다.
Latency가 길어도 작업을 겹치면 Throughput을 높일 수 있습니다. 이 성질을 이용하는 기법을 Latency Hiding이라고 부릅니다. 아래에서 Instruction-level, Loop-level, Thread-level pipelining 순서로 봅니다.
Instruction-Level Pipelining
Latency Hiding의 가장 기본적인 형태는 명령어 수준의 파이프라이닝입니다. 이 절에서는 교과서에서 RISC의 대표 사례로 자주 등장하는 고전적인 5-Stage RISC Pipeline(MIPS·RISC-V 교과서의 표준 예제)을 가져와 비교 기준으로 사용합니다. 5-Stage Pipeline은 명령어 하나가 실행되는 과정을 다섯 단계로 나눈 것입니다.
- IF (Instruction Fetch): instruction 메모리에서 명령어를 가져옵니다.
- ID (Instruction Decode): 가져온 명령어를 해석해 하드웨어가 무엇을 해야 할지 파악합니다.
- EX (Execute): 디코드된 정보를 가지고 실제 연산을 수행합니다.
- ME (Memory Access): 필요한 경우 데이터 메모리에 접근합니다.
- W (Write Back): 최종 결과를 레지스터에 다시 씁니다.
이 5단계를 (1) 순차적으로 실행할 때와 (2) 파이프라인으로 겹쳐서 실행할 때를 같은 cycle 범위에서 비교해 보겠습니다.
순차적 실행의 한계
명령어 하나가 실행되는 데 걸리는 시간이 그 명령어의 Latency입니다.
이 Latency는 모든 명령어가 동일한 것이 아닙니다. 명령어마다 다를 수 있고, 한 사이클에 끝나는 경우도 있고 여러 사이클이 걸리는 경우도 있으며, 메모리 접근처럼 굉장히 긴 시간이 걸리는 경우도 있습니다.
순차 실행 방식에서는 한 명령어의 다섯 단계가 모두 끝난 후에야 다음 명령어를 시작할 수 있습니다. 각 명령어의 Latency가 그대로 처리량에 누적됩니다.
| Cycle | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| Inst 1 | IF | ID | EX | ME | W | ||||
| Inst 2 | IF | ID | EX | ME |
9 cycle 동안 단 1개의 명령어만 완전히 끝나고, 두 번째 명령어는 아직 마지막 W 스테이지를 남겨둔 상태입니다. 한 명령어가 완전히 끝나야 다음을 시작할 수 있으므로 Throughput이 심하게 제한됩니다.
파이프라이닝을 통한 Throughput 향상 (5-Stage Pipeline)
이 문제를 해결하기 위해 등장한 것이 파이프라인 아키텍처입니다. 같은 5단계를 서로 다른 명령어가 매 cycle씩 밀려서 동시에 진행하도록 겹칩니다.
| Cycle | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| Inst 1 | IF | ID | EX | ME | W | ||||
| Inst 2 | IF | ID | EX | ME | W | ||||
| Inst 3 | IF | ID | EX | ME | W | ||||
| Inst 4 | IF | ID | EX | ME | W | ||||
| Inst 5 | IF | ID | EX | ME | W |
명령어 사이에 의존성이 없다면, 매 cycle마다 새로운 명령어를 Fetch할 수 있습니다. 개별 명령어의 전체 Latency는 여전히 5 cycle이지만, 다음 명령어를 시작하기 위해 기다려야 하는 시간은 단 1 stage(1 cycle)뿐입니다.
같은 9 cycle 동안 5개의 명령어가 끝납니다(순차 실행은 1개). 의존성이 없으면 이론상 Throughput이 5배가 됩니다. 명령어 하나의 Latency는 그대로이고, 여러 명령어의 단계가 겹쳐 Throughput이 오릅니다.
Vertical Microcode (Encoding)
5단계 중 두 번째인 ID(Instruction Decode)를 좀 더 보겠습니다. 디코딩이 있다는 것은 그만큼 인코딩 방식도 다양하다는 뜻이고, 인코딩 방식에 따라 디코딩이 하는 일도 달라집니다.
이 강의에서는 control information을 얼마나 압축해 표현하는지에 따라 Vertical과 Horizontal encoding을 비교합니다. Horizontal 방식은 뒤에서 VLIW를 다룰 때 다시 등장하므로 여기서는 먼저 Vertical 방식을 살펴봅니다.
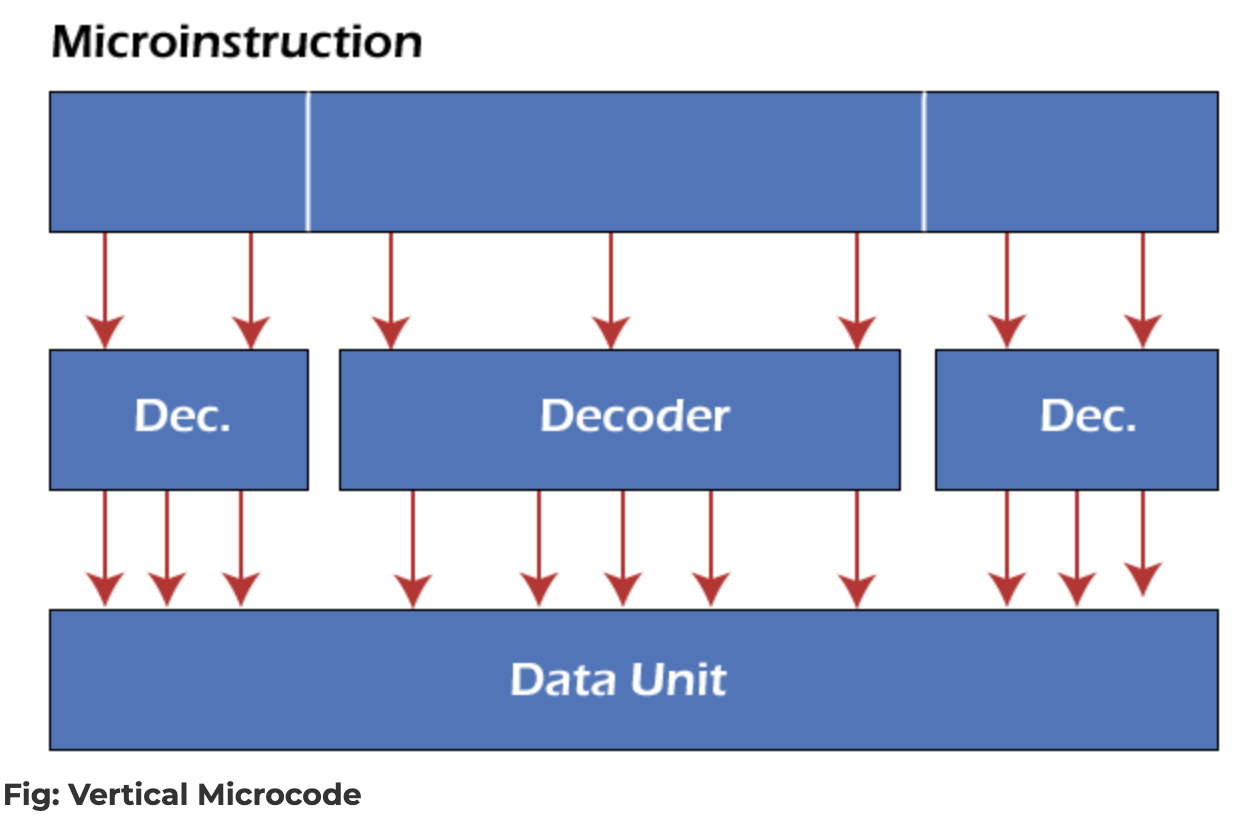
일반적인 RISC·CISC ISA의 instruction은 datapath control signal을 그대로 나열하지 않고 opcode와 operand field로 압축해 표현합니다. Decode 단계가 instruction을 해석해 microarchitecture의 control signal로 변환한다는 점에서 이 강의는 이를 Vertical Encoding 쪽에 놓습니다. RISC/CISC와 Vertical/Horizontal은 서로 다른 분류 기준이므로 완전히 같은 용어는 아닙니다.
이런 구조 덕분에 파이프라인 아키텍처의 디테일은 소프트웨어에 노출되지 않습니다. ISA 위에서 코드를 짜는 개발자는 5-stage가 어떻게 겹치는지, 어떤 신호가 어느 cycle에 어떤 유닛에 도달하는지 알 필요가 없습니다. 이것은 앞서 본 세 가지 접근 방식 중 ①번, Microarchitecture 수준에서 하드웨어가 자체적으로 처리하는 최적화의 전형적인 예입니다.
RISC-V 5-Stage Pipeline 상세 구조
지금까지 추상적으로 이야기한 5단계가 실제 하드웨어에서는 어떤 모습인지 한번 들여다 보겠습니다.
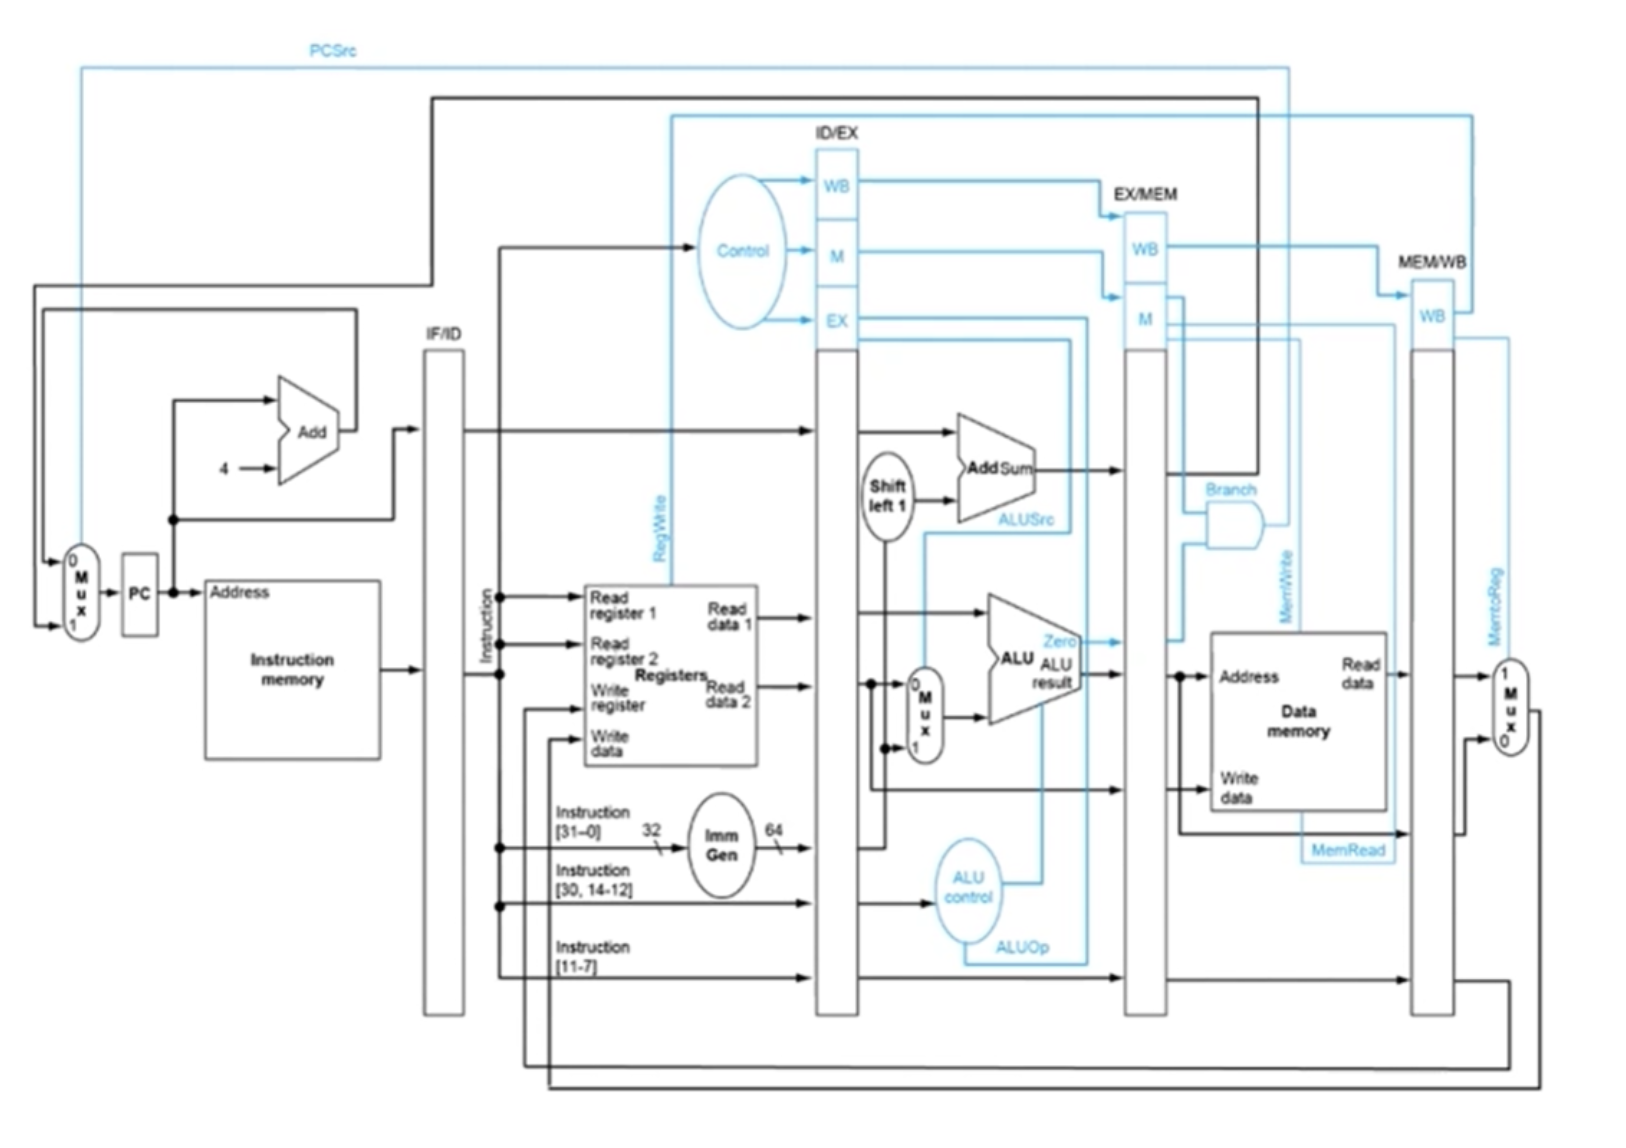
그림은 앞서 말한 다섯 개의 스테이지가 실제로 분리되어 연결된 구조를 보여줍니다. IF 단계에서 instruction 메모리로부터 명령어를 가져오면, 그 다음 단에 있는 큰 박스(ID 단계)에서 디코딩이 일어나며 명령어가 여러 개의 제어 신호로 분기됩니다. 이렇게 분기된 신호들이 가는 곳이 다양합니다.
- 어떤 신호는 레지스터 파일로 들어가 레지스터를 읽습니다.
- 어떤 신호는 그 자체로 다음 스테이지의 입력이 됩니다.
- 어떤 신호는 ALU를 제어합니다.
- 어떤 신호는 더 뒤쪽 스테이지까지 전달되어 거기서 일어나야 할 동작을 결정합니다.
매 cycle 하드웨어의 동작은 방금 Fetch한 명령어와, 파이프라인 안의 다른 명령어들이 남긴 상태가 함께 정합니다.
이 과정은 소프트웨어에서 보이지 않습니다. ISA만 봐서는 Microarchitecture가 이렇게 생겼는지 알 수 없고, 명령어는 디코딩된 뒤에야 하드웨어 제어 신호가 됩니다. 앞 절의 Vertical Encoding은 이 구조 위에서 동작합니다.
Data Hazard와 Bypass Logic
지금까지 본 파이프라이닝은 항상 이상적인 x5 Throughput을 보여주는 것처럼 묘사했지만, 실제로는 그렇지 않은 경우가 종종 있습니다. 파이프라인 버블(Bubble) 또는 파이프라인 스톨(Stall)이라고 부르는 현상이 그것입니다. 이 상황에서는 파이프라인의 어느 stage를 채우지 못해, 그 cycle을 통째로 낭비하게 됩니다.
버블이 발생하는 원인 중 대표적인 것이 레지스터 간 의존성에 의한 Data Hazard입니다. 앞 명령어가 아직 결과를 레지스터에 쓰지 않았는데, 뒤 명령어가 그 값을 읽어야 하는 상황이 그것입니다.
교과서에 나오는 간단한 5-stage 파이프라인 아키텍처에서는 이런 Data Hazard를 Bypass Logic(또는 Forwarding)이라고 부르는 기법으로 상당 부분 해결합니다. 아직 레지스터 파일에 정식으로 저장되지 않은 데이터라도, 이미 계산이 끝난 결과라면 뒤쪽 스테이지로 곧바로 포워딩해서 버블을 없애는 것입니다.
Data Hazard가 발생할 수 있는 상황을 하드웨어가 더 복잡한 로직을 동원해 자체적으로 해결하는 방식이라고 볼 수 있습니다. 다만 모든 해저드를 항상 해결할 수 있는 것은 아닙니다(예: 메모리 로드 직후의 의존성처럼 시점상 어쩔 수 없이 한 cycle을 멈춰야 하는 경우).
Branch Latency 문제
Bypass Logic으로 Data Hazard는 상당수 해결되지만, Branch(분기) 명령어가 만드는 bubble은 파이프라이닝만으로 숨기기 어렵습니다.
문제의 구조는 이렇습니다. 파이프라인의 첫 단계는 IF(Instruction Fetch)인데, Fetch를 하려면 instruction 메모리의 어느 주소에 다음 명령어가 있는지를 알아야 합니다. 그런데 Branch 명령어를 만나면 그 다음 명령어가 어디에 있는지가 분기 조건과 분기 대상 주소가 계산되어야 비로소 결정됩니다. 그리고 그 계산은 보통 파이프라인의 후반 스테이지에서 일어납니다.
IF 단계와 분기 조건/주소가 결정되는 단계 사이에는 여러 cycle의 거리가 있고, 그 사이 동안은 다음 명령어를 Fetch할 수가 없습니다. 그래서 분기로 인해 발생하는 Latency는 Bypass Logic 같은 트릭으로 깔끔하게 숨겨지지 않으며, Stall이 어느 정도 불가피합니다.
분기는 자주 나오므로(다음 절의 수치 참고) 분기 처리 비용을 줄이는 것은 파이프라인 아키텍처의 중요한 과제가 됩니다.
Branch Latency Hiding: Delayed Slot
이 Branch 문제를 해결하기 위한 기법 중 하나로, MIPS 아키텍처는 Branch Delay Slot이라는 다소 흥미로운 방법을 도입했습니다.
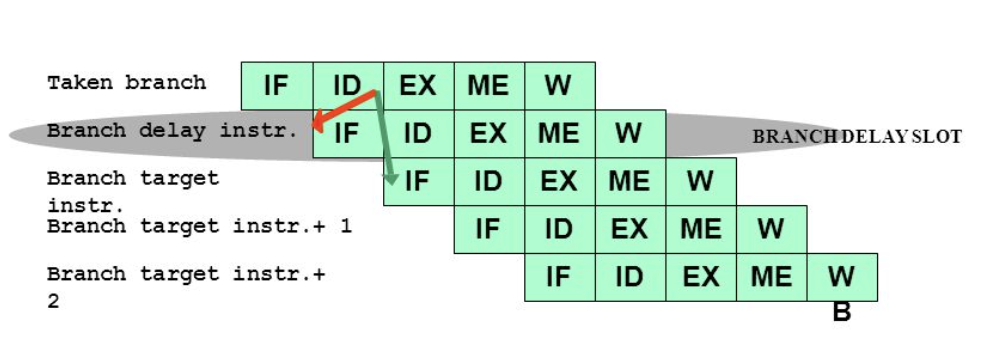
아이디어는 이렇습니다. 분기 명령어 바로 뒤에 위치한 명령어 한 개(= Delay Slot에 들어간 명령어)는, 분기가 Taken이든 Not Taken이든 무조건 실행되도록 ISA의 의미를 정해 버리는 것입니다. 그러면 파이프라인이 분기 결과를 기다리며 비어 있을 cycle 슬롯을 그 명령어로 채울 수 있어, 버블이 사라집니다.
사실 이건 고수준 프로그래밍 언어 관점에서 보면 꽤 어색한 발상입니다. 보통 우리는 “분기를 타면 타는 거고, 안 타면 안 타는 것”으로 코드를 짜지, “분기 다음 한 명령어는 분기 여부와 무관하게 무조건 실행된다”는 의미를 굳이 생각하지 않습니다. MIPS 설계자들은 Branch Delay로 생기는 빈 슬롯을 활용하기 위해, 의도적으로 ISA의 의미(Semantics)를 바꿔서 이 효과를 얻었다고 볼 수 있습니다.
다만 이 방식에는 단점이 분명합니다.
- 어셈블리 코딩이 까다로워집니다. 사람이 직접 짤 때 분기 다음 한 칸의 의미를 늘 의식해야 합니다.
- 컴파일러가 Delay Slot에 넣을 적절한 명령어를 찾지 못하는 경우가 자주 생깁니다.
- 파이프라인 depth가 깊어지면 Branch Delay도 길어지는데, Delay Slot 한두 개만으로는 그 늘어난 buffer를 다 메우기 어렵습니다.
이런 이유로 Branch Delay Slot은 지금은 거의 쓰이지 않습니다. 이후 프로세서는 ISA의 의미를 바꾸는 대신, 하드웨어가 분기를 예측해 먼저 진행하는 쪽으로 옮겨 갔습니다. 다음 절의 Branch Prediction입니다.
Branch Latency Hiding: Branch Prediction
Branch는 자주 나옵니다. 워드프로세서·웹브라우저처럼 일반적으로 “Integer program”이라 부르는 워크로드에서는 6~7개 명령어 중 하나는 Branch일 정도입니다. 이때마다 Branch Latency가 그대로 노출되어 버블이 생긴다면 성능에 큰 영향을 줍니다. 그래서 하드웨어에 별도 장치를 두어 Branch Latency를 숨기는 방식이 등장했습니다. 가장 널리 쓰이는 장치가 Branch Prediction입니다.
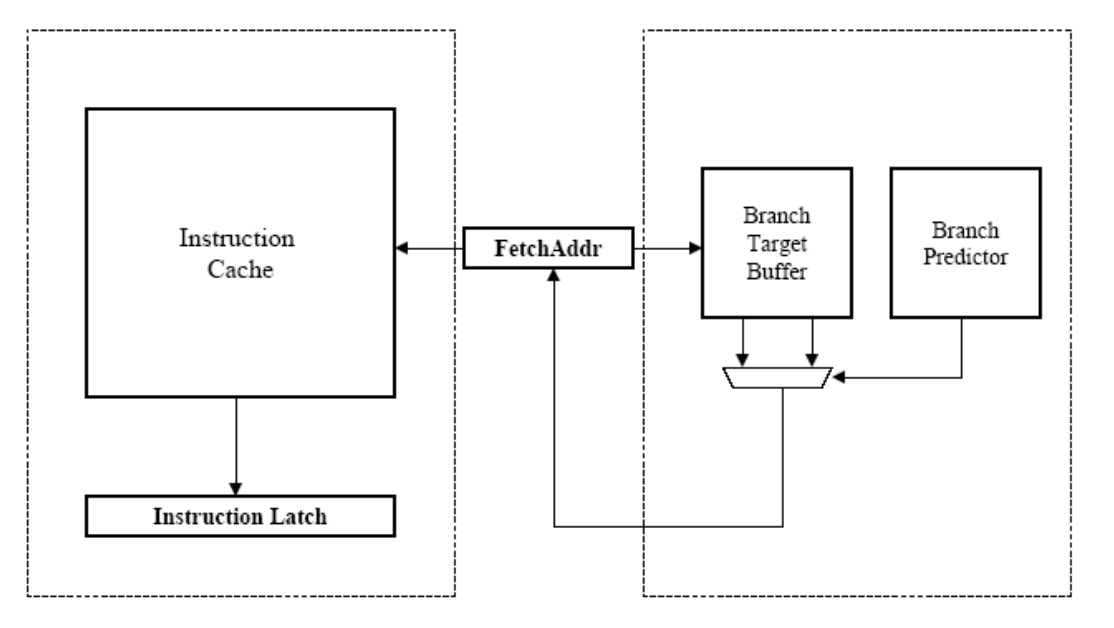
무엇을 예측해야 하는가?
Branch가 일으키는 버블을 없애려면 두 가지 정보가 필요합니다.
- Direction (Taken / Not Taken): 이 분기가 실제로 일어날 것인지 아닌지.
- Target Address: 일어난다면 어느 주소로 점프할 것인지.
Target Address는 적어도 instruction decode(ID) 단계까지 가야 알 수 있습니다. 디코드가 끝난 뒤에 다음 명령어를 Fetch하면 그 사이 몇 cycle을 잃습니다. 따라서 Direction과 함께 Target Address도 미리 알아야 버블이 없어집니다.
Branch Target Buffer (BTB)
이 두 번째 문제를 해결해 주는 장치가 Branch Target Buffer (BTB) 입니다. BTB는 일종의 캐시인데, 키는 방금 Fetch한 명령어의 주소, 값은 그 명령어가 Branch라면 점프했을 때의 Target Address입니다.
흐름은 이렇게 됩니다.
- 어떤 주소의 명령어를 Fetch한다.
- 그 주소가 BTB에 들어 있는지 본다.
- 들어 있고, Branch Predictor가 “이번엔 Taken일 것”이라고 예측하면, BTB에 저장된 Target Address를 바로 사용해 다음 cycle에 그 주소로 Fetch를 이어 간다.
이렇게 Branch Predictor가 Direction을 예측하고, BTB가 Target Address를 캐싱해 줌으로써, 분기 명령어가 모두 디코드되기를 기다리지 않고 곧바로 다음 명령어를 가져올 수 있게 됩니다.
Misprediction과 Speculative Execution
당연히 Prediction은 항상 맞지는 않습니다. 예측이 맞으면 대기 없이 진행하고, branch가 실제로 resolve된 뒤 결과가 예측과 다르면 Misprediction으로 처리됩니다. (BTB의 hit/miss는 target 주소가 캐싱되어 있는지의 문제일 뿐, 예측이 맞았는지는 branch가 resolve되어야 알 수 있습니다.) Misprediction이 발생하면 그동안 잘못된 경로에서 진행한 작업을 모두 버리고 올바른 주소에서 다시 Fetch를 시작해야 하는데, 그 사이에 이미 많은 작업이 진행된 복잡한 프로세서일수록 별도의 Rollback / Recovery 로직이 필요해집니다.
이렇게 정답이 무엇인지 아직 확실히 모르는 상태에서, 확률이 더 높은 쪽을 미리 골라 실행을 진행해 나가는 방식을 컴퓨터 아키텍처에서는 Speculative Execution(추측 실행) 이라고 부릅니다. Branch Prediction은 그 가장 대표적인 예시이고, 이후 OOO Processor를 다룰 때 다시 확장된 형태로 등장합니다.
Instruction-Level Pipelining 정리
이 절은 명령어 하나의 Latency를 파이프라이닝으로 숨기고, 그 때문에 생기는 hazard를 해결하는 과정이었습니다.
| # | 문제 / 상황 | 원인 | 해결 기법 | 결과 / 한계 |
|---|---|---|---|---|
| 1 | 순차 실행은 Throughput이 낮음 | 한 명령어 Latency가 그대로 누적 | 5-Stage Pipelining | 의존성 없으면 이론적 x5 Throughput |
| 2 | 파이프라인 버블 (Data Hazard) | 레지스터 간 의존성 | Bypass Logic / Forwarding | 일부 hazard는 여전히 stall (예: load-use) |
| 3 | 파이프라인 버블 (Branch Latency) | Direction과 Target Address가 늦게 결정됨 | (구) Delay Slot → (현) Branch Prediction + BTB | Misprediction 시 Rollback 비용 발생 |
Delay Slot을 빼면 위 기법은 모두 소프트웨어에 드러나지 않고 하드웨어가 처리합니다. Instruction-Level Pipelining에서는 「프로세서 설계의 핵심 질문」의 ①번 접근, 즉 Microarchitecture 수준 최적화가 사실상 표준입니다.
다음 절부터는 같은 Latency Hiding의 줄기를 이어가되, 단위를 한 단계 키워서 다룹니다. 한 명령어가 아니라 루프 iteration 단위로 겹쳐 실행하는 Loop-Level Pipelining, 그리고 그것을 하드웨어적으로 푸는 OOO와 소프트웨어적으로 푸는 VLIW가 등장합니다.
Loop-Level Pipelining
Instruction-level pipelining이 개별 명령어의 실행 단계를 겹치는 것이었다면, Loop-level pipelining은 한 단계 더 나아가 루프의 서로 다른 iteration을 겹쳐서 실행하는 것입니다.
루프의 순차적 실행 한계
앞 절에서 본 Branch 가운데 상당수는 루프 끝에서 처음으로 돌아가는 분기입니다. 그래서 루프를 빨리 도는 것이 프로그램 전체 성능을 좌우합니다.
Loop을 더 빠르게 돌릴 순 없을까?
loop: slli  s2, s1, 2     # 1
    add   s3, s0, s2    # 2
    lw    t1, 0(s3)     # 3
    mul   t2, t1, t1    # 4
    add   t3, t2, t1    # 5
    sw    t3, 0(s3)     # 6
    addi  s1, s1, 1     # 7
blt s1, t0, loop # 8slli s2, s1, 2 # 1 add s3, s0, s2 # 2 lw t1, 0(s3) # 3 mul t2, t1, t1 # 4 add t3, t2, t1 # 5 sw t3, 0(s3) # 6 addi s1, s1, 1 # 7 blt s1, t0, loop # 8
slli  s2, s1, 2     # 1
add   s3, s0, s2    # 2
lw    t1, 0(s3)     # 3
mul   t2, t1, t1    # 4
add   t3, t2, t1    # 5
sw    t3, 0(s3)     # 6
addi  s1, s1, 1     # 7
blt   s1, t0, loop  # 8
이 루프는 Python으로 쓰면 for i in range(n): a[i] = a[i] * a[i] + a[i]입니다. s0이 배열 a의 시작 주소, s1이 i, t0이 n이고, 12번이 주소 계산, 3번이 load, 45번이 곱셈과 덧셈, 6번이 store, 7번이 i += 1입니다. 왼쪽은 루프 자체(loop: 레이블이 붙어 반복 시작점이 되는 코드)이고, 오른쪽은 두 iteration을 순차 실행했을 때의 명령어 trace입니다. 마지막 줄에 있는 BLT(Branch if Less Than)가 조건부 분기 명령어로, 루프의 끝에서 다시 처음으로 되돌아가는 Back Edge를 형성합니다. 문제는 이 조건부 분기가 해결되어야만 다음 iteration을 시작할 수 있다는 점입니다.
따라서 아무 장치 없이 그대로 두면 이 루프는 iteration 단위로 순차 실행될 수밖에 없습니다. 한 iteration이 BLT까지 다 끝나야 비로소 다음 iteration의 첫 명령어를 시작할 수 있는 구조이기 때문입니다. 이 구조를 어떻게 깨고 iteration들을 겹쳐 실행할 것인가가 Loop-level pipelining의 출발점입니다.
Iteration 중첩을 통한 Latency Hiding
명령어 단위로 파이프라이닝을 했듯이, 루프 iteration 단위로도 파이프라이닝을 할 수 있을까요? iteration들의 실행을 겹칠 수 있다면 루프가 빨라집니다.
만약 iteration들을 중첩시켜 Latency Hiding을 한다면?
앞 절의 5-Stage Pipeline에서 본 것과 동일한 아이디어를 한 단계 위(루프 iteration 단위)에 적용해 봅니다. 이전 iteration이 끝나기를 기다리지 않고, 다음 iteration을 일찍 시작해서 명령어 실행을 겹치게 만드는 것입니다.
loop: slli  s2, s1, 2     # 1
    add   s3, s0, s2    # 2
    lw    t1, 0(s3)     # 3
    mul   t2, t1, t1    # 4
    add   t3, t2, t1    # 5
    sw    t3, 0(s3)     # 6
    addi  s1, s1, 1     # 7
blt s1, t0, loop # 8slli s2, s1, 2 # 1 add s3, s0, s2 # 2 lw t1, 0(s3) # 3 mul t2, t1, t1 # 4 add t3, t2, t1 # 5 sw t3, 0(s3) # 6 addi s1, s1, 1 # 7
slli  s2, s1, 2     # 1
add   s3, s0, s2    # 2
lw    t1, 0(s3)     # 3
mul   t2, t1, t1    # 4
add   t3, t2, t1    # 5
sw    t3, 0(s3)     # 6
addi  s1, s1, 1     # 7
slli  s2, s1, 2     # 1
add   s3, s0, s2    # 2
lw    t1, 0(s3)     # 3
mul   t2, t1, t1    # 4
add   t3, t2, t1    # 5
sw    t3, 0(s3)     # 6
addi  s1, s1, 1     # 7
각 iteration이 다른 data를 접근한다면 충분히 가능
위 그림은 같은 루프 본문 세 개를 한 칸씩 밀어 놓은 것입니다. iteration 1이 진행 중일 때 iteration 2가 시작되고, 조금 뒤 iteration 3이 시작됩니다. 5-Stage Pipeline 표가 stage 단위로 겹쳤다면, 여기서는 명령어 단위로 겹칩니다.
당연히 이 중첩이 항상 안전하지는 않습니다. 전제는 각 iteration이 서로 다른 데이터를 접근한다는 것, 즉 iteration 간 의존성이 약해서 현재 iteration이 끝나기 전에 다음 iteration을 시작해도 결과가 달라지지 않아야 한다는 것입니다.
실제 루프 상당수가 이 조건을 만족합니다. 배열 원소마다 같은 연산을 적용하는 루프, 행렬의 행이나 열을 따라 도는 루프는 iteration 간 의존성이 거의 없습니다. 다음 절에서는 이런 루프를 겹쳐 실행할 때 걸리는 방해 요소를 봅니다.
방해요소와 해결책
iteration을 겹쳐 실행하는 데는 방해 요소가 두 가지 있고, 각각 해결책이 있습니다.
| 방해요소 | ⇒ | 해결책 |
|---|---|---|
| Control Flow (conditional branch) | ⇒ | Branch Prediction |
| 다른 iteration의 instruction 사이 False Data Dependency | ⇒ | Register Renaming |
1. Control Flow (조건부 분기)
앞서 본 것처럼, 루프 끝에 있는 조건부 분기(BLT)는 컴파일러가 흔히 Back Edge라고 부르는 흐름을 만듭니다. 원칙적으로는 이 Back Edge가 해결되어야 다음 iteration을 시작할 수 있으므로, 분기 결과를 알기 전에는 다음 iteration을 출발시킬 수 없다는 제약이 생깁니다.
해결책은 이미 한 번 본 적이 있습니다. 명령어 수준 파이프라이닝에서 다뤘던 Branch Prediction입니다. 분기 방향과 Target Address를 미리 예측해 다음 iteration의 첫 명령어를 곧장 Fetch하면, Back Edge가 만든 stall을 hiding할 수 있습니다.
2. False Data Dependency (다른 iteration의 instruction 사이)
두 번째 방해요소는 다소 미묘합니다. 같은 루프의 서로 다른 iteration들은 계산상으로는 완전히 독립일 수 있는데도, 같은 레지스터를 재사용한다는 이유만으로 의존성이 있는 것처럼 보이는 경우가 그것입니다.
여기서 두 종류의 의존성을 구분할 필요가 있습니다.
- True Dependency - 실제로 어떤 값이 계산되고 그 값을 다른 명령어가 사용하는 관계. 값 자체가 필요하므로 반드시 지켜져야 합니다.
- False Dependency - 값을 저장해 놓은 저장 공간(레지스터)이 하필 겹쳐서 생기는 가짜 의존성. 만약 더 많은 저장 공간이 있어서 같은 레지스터를 쓰지 않았다면 처음부터 의존성이 없었을 관계입니다.
루프의 경우, iteration 1과 iteration 2가 계산상 완전히 독립이더라도, 사용 가능한 레지스터 수가 제한되어 있어 같은 레지스터(예: s2, t1, t3 …)에 반복적으로 읽고 쓰게 됩니다. 그 결과 실제로는 무관한 두 계산 사이에 False Dependency가 생기고, 중첩 실행이 막힙니다.
해결책은 Register Renaming입니다. 이름은 같은 t1이라도 iteration마다 실제로는 다른 저장 공간을 쓰도록 바꿔 주면, False Dependency가 해소되어 iteration들을 자유롭게 겹칠 수 있습니다.
소프트웨어로 풀 때의 한계: ISA 레지스터 수
소프트웨어로도 이 문제를 어느 정도는 풀 수 있습니다. 컴파일러가 루프를 두세 번 unroll한 뒤 copy마다 다른 레지스터를 배정하면(modulo variable expansion) 같은 이름을 다시 쓰는 일이 없어지고, Itanium 같은 VLIW/EPIC ISA는 iteration마다 레지스터 번호가 자동으로 밀리는 rotating register file을 두어 unroll 없이 같은 효과를 냅니다. 뒤의 VLIW 절 그림에서 iteration마다 레지스터 두 벌을 번갈아 쓰는 것이 이 방법입니다.
한계는 ISA가 노출하는 레지스터 수입니다. 겹치는 iteration 수만큼 레지스터 세트가 필요한데 RISC-V는 32개뿐이고, 그것도 컴파일 시점에 고정됩니다. 여기서 두 갈래가 생깁니다. 다음 절의 OOO Processor는 ISA 레지스터보다 훨씬 많은 물리 레지스터를 두고 하드웨어가 실행 중에 이름을 바꿔 주는 방식이고, VLIW는 컴파일러가 스케줄과 레지스터 배정을 미리 정해 ISA 차원에서 넘겨주는 방식입니다.
OOO(Out-Of-Order) Processor: 하드웨어적 접근
Out-of-Order Processor는 위에서 본 두 가지 방해 요소(Control Flow, False Data Dependency)를 하드웨어가 동적으로 풀어주는 방식입니다. Sequential 의미를 가진 ISA를 그대로 두면서도, 내부적으로는 Branch Prediction과 Register Renaming을 동원해 iteration들을 겹쳐 실행할 수 있는 형태로 코드를 재해석합니다. 큰 흐름은 다음 세 단계입니다.
loop: slli  s2, s1, 2     # 1
    add   s3, s0, s2    # 2
    lw    t1, 0(s3)     # 3
    mul   t2, t1, t1    # 4
    add   t3, t2, t1    # 5
    sw    t3, 0(s3)     # 6
    addi  s1, s1, 1     # 7
blt s1, t0, loop # 8prediction
같은 이름을 다시 쓰는 곳에 가짜 의존(빨강)이 생기고
값이 넘어가는 s1′ 하나만 남는다
graph
data-flow graph
각 단계를 풀어 보면 다음과 같습니다.
- Sequential code로부터 출발 - ISA는 여전히 “위에서 아래로 차례차례 실행” 의미를 가진 보통의 명령어 시퀀스입니다(
slli → add → lw → … → blt). - Branch Prediction으로 speculative trace 생성 - 루프 끝의
blt를 만나면 Branch Predictor가 “이번에도 Taken일 것”이라 예측하고, 그 결과를 받은 것처럼 다음 iteration의 명령어들을 추측해서 미리 펼쳐 둡니다. 이렇게 펼쳐진 직선형 명령어 흐름을 speculative trace라고 부릅니다. 분기 명령어 자체는 남아서 나중에 예측이 맞았는지 검증하지만, 그 결과를 기다리지 않고 다음 명령어들을 미리 가져와 두므로 재배치할 수 있는 명령어 창이 훨씬 넓어집니다. 다만 펼쳐 놓고 보면 iteration i+1의slli s2는 iteration i의add s3, s0, s2가s2를 다 읽기 전에는s2를 덮어쓸 수 없고,t1도 같습니다. 값이 아니라 이름이 겹쳐서 생기는 이 관계가 False Dependency(그림의 빨간 점선)입니다. 값이 실제로 넘어가는 True Dependency는addi s1에서 다음 iteration의slli로 가는s1하나(초록 실선)뿐입니다. - Register Renaming → Data-flow graph 전환 - 하드웨어가 값을 쓸 때마다 새 이름을 붙입니다. 그림에서는 iteration i+1이 만드는 값을
s2′,t1′처럼 프라임으로 구분했고, iteration i의addi가 만드는 새s1은s1′입니다. 이름이 겹치지 않으니 빨간 False Dependency가 사라지고, 명령어 사이에는 True Dependency만 남습니다. 남은 의존 관계만 그리면 data-flow graph(DAG) 가 되고, 서로 의존 경로가 없는 명령어들은 동시에 실행해도 결과가 같으므로 병렬로 처리할 수 있습니다.
s2′, t1′처럼 새 이름을 받으므로 iteration i의 s2, t1과 저장 공간이 겹치지 않는다. 두 열을 잇는 값은 루프 카운터 s1′ 하나뿐이고, 그 아래 명령어들은 두 iteration에서 동시에 실행될 수 있다.어떻게 하드웨어는 가능한가? Physical Register
하드웨어가 ISA 레지스터 수의 한계를 넘는 방법은 단순합니다. ISA로 노출된 것보다 훨씬 많은 레지스터를 실제로 가지고 있는 것입니다.
- Architectural Register (논리 레지스터) - ISA가 노출하는, 소프트웨어가 보는 레지스터 이름들(
s0,s1,t0,t1, …). 그 개수는 ISA에 의해 고정됩니다. - Physical Register (물리 레지스터) - 칩 위에 실제로 존재하는 저장 장치들. 보통 수 배에서 10배 이상 많습니다(x86-64는 architectural 16개에 physical 수백 개).
OOO Processor는 명령어가 들어올 때마다 코드에 적힌 Architectural Register 이름을, 그 시점에 비어 있는 Physical Register 중 하나에 매핑합니다. 그리고 그 명령어가 같은 Architectural 이름을 읽을 때는, 매핑 테이블을 따라가서 올바른 값이 들어 있는 Physical Register를 가리키도록 만듭니다. 이름은 같은 t1이어도 iteration i의 t1과 iteration i+1의 t1은 서로 다른 Physical Register에 들어갑니다. 앞 그림에서 t1과 t1′으로 구분해 그린 것이 바로 이 두 Physical Register입니다.
모든 명령어에 대해 cycle마다 이 매핑을 하면, 하드웨어 안에는 Renaming이 끝난 data-flow graph가 만들어집니다. 이 그래프에서 입력이 준비된 명령어는 원래 코드 순서와 무관하게(out-of-order) 실행됩니다. Out-of-Order Processor라는 이름이 여기서 나왔습니다.
결과적으로 ISA는 여전히 Sequential Semantics를 유지하지만, 하드웨어 내부에서는 루프가 파이프라인된 형태로 수행되며 매 cycle 여러 개의 instruction을 동시에 처리하는 효과를 얻습니다. 오늘날 사용되는 대부분의 CPU(Intel, AMD 등)가 이 OOO 기법을 채택하고 있습니다.
결과적으로 Loop이 Pipeline된 형태로 수행
이 흐름이 실제 실행 시점에는 어떤 모습으로 나타나는지를 그림으로 보면 다음과 같습니다.


여러 iteration의 루프 본문이 살짝씩 밀려서 나란히 진행되고, 같은 시점(cycle)을 기준으로 슬라이스를 떠 보면 서로 다른 iteration의 명령어들이 동시에 수행되고 있는 모습이 됩니다.
이 모습은 Instruction-Level Pipelining의 5-Stage 표와 구조가 같습니다. 다만 단위가 한 단계 커져서, “한 명령어 안의 IF/ID/EX/ME/W stage”가 아니라 “한 iteration 안의 명령어 묶음”이 각 stage를 차지하고, 서로 다른 iteration들이 다른 stage에 동시에 머무르며 매 cycle 한 칸씩 진행됩니다. 반복되는 패턴만 잘라내면 동일한 코드가 계속 돌아가는 것처럼 보이게 되는 것입니다.
다만 한 가지 주의할 점은, OOO Processor가 정확히 이 그림과 똑같이 고정된 패턴으로 돈다는 뜻은 아니라는 것입니다. OOO는 매 cycle 들어오는 명령어 윈도우의 상태에 따라 동적으로 다른 명령어 조합을 골라 실행합니다. 위 그림은 그 동작이 개념적으로 만들어 내는 중첩 효과를 단순화해서 보여 줄 뿐입니다.
보충: data-flow graph는 어디에 살아있는가?
수강생 질문이 있어서 잠깐 보태둡니다. 하드웨어가 data-flow graph를 자료구조로 유지하는가?라는 질문에 대한 답은 “그렇다”입니다. OOO Processor는 다음 장치들을 통해 그 그래프를 동적으로 만들고 갱신합니다.
- Reservation Station - 각 명령어가 어떤 Physical Register의 값을 기다리고 있는지 태깅해 두는 장치(Tomasulo 알고리즘의 용어). 입력 값이 도착하면 해당 명령어가 실행 가능 상태로 바뀝니다.
- Register Alias Table (RAT, rename map) - 어떤 Architectural Register가 현재 어떤 Physical Register에 매핑되어 있는지를 추적합니다. 새 명령어가 들어올 때마다 이 테이블을 참조해 입력 레지스터를 올바른 Physical Register로 다시 이름 붙입니다(rename).
이 자료구조들이 유지하는 그래프의 범위는 무한이 아닙니다. 명령어 윈도우(Instruction Window), 즉 아직 처리되지 않았거나 진행 중인 일정 개수의 명령어 안에 있는 명령어들에 대해서만 그래프가 만들어집니다. 명령어가 다 끝나서 윈도우에서 빠져나가면 그래프에서도 사라지고, 새로 들어온 명령어가 그 자리를 채우면서 그래프가 계속 모양을 바꿉니다. 즉 OOO의 data-flow graph는 매 cycle 유동적으로 변하는 sliding window 위의 그래프입니다.
Intel Core Architecture의 OOO Engine
지금까지 이야기한 OOO 동작이 실제 상용 프로세서에서는 어떻게 생겼는지, Intel Core 아키텍처의 다이어그램으로 한번 확인해 보겠습니다.
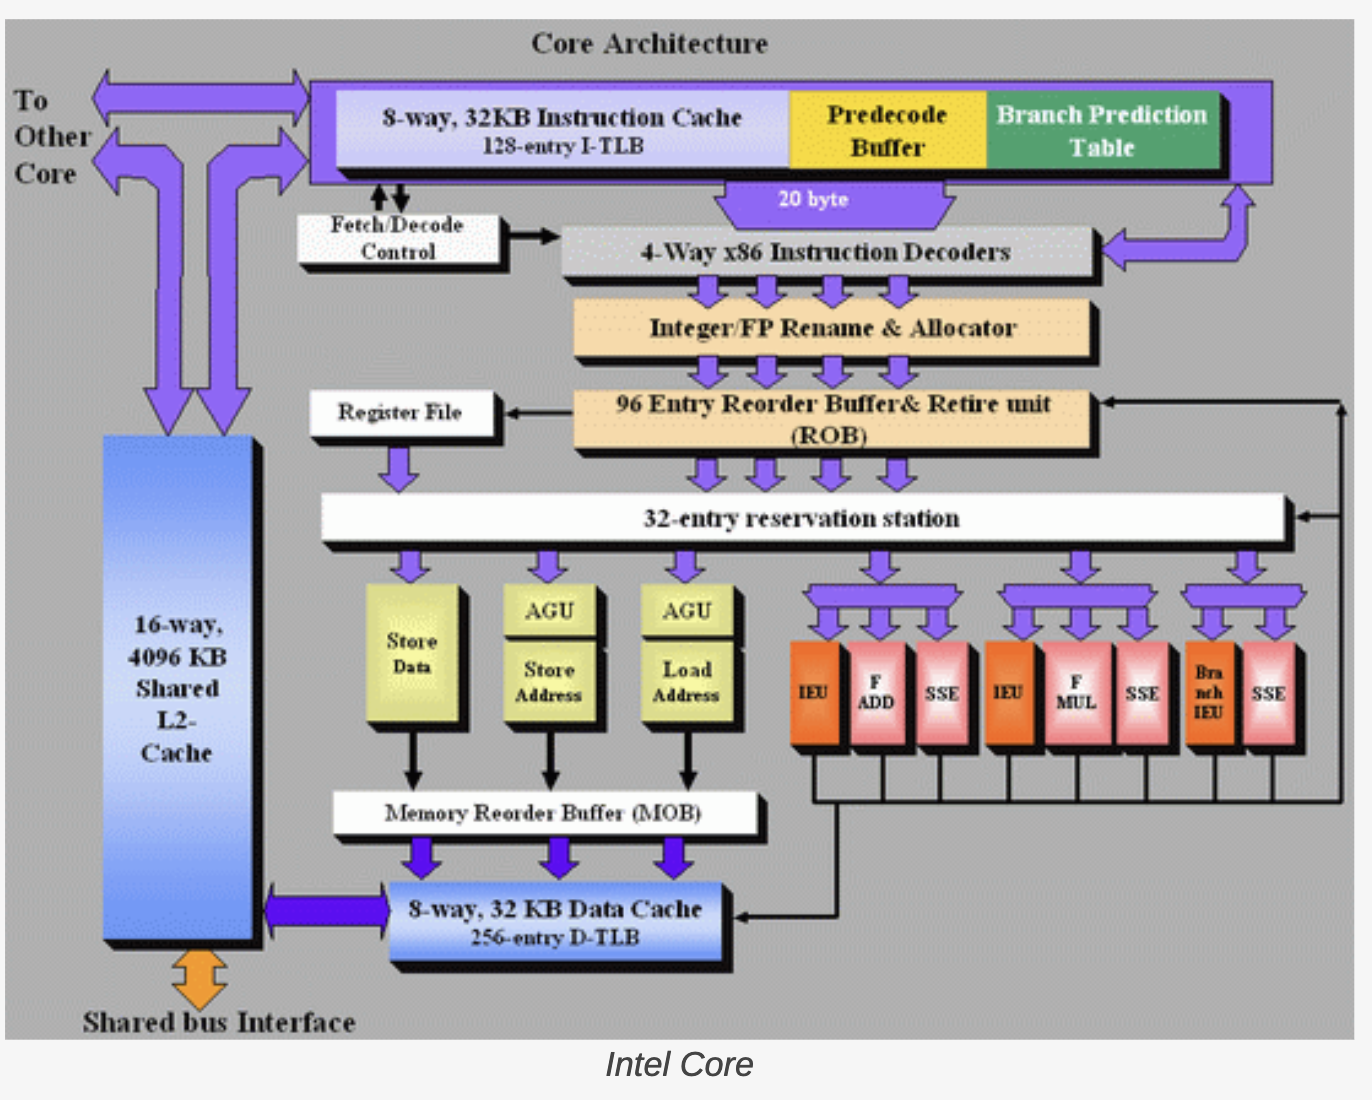
이 그림은 앞 절에서 개념적으로 설명한 “동적으로 Data-Flow Graph를 만들어서 실행하는 엔진”의 실제 구현 단면입니다. 앞 절의 추상화된 자료구조들이 각각 별도의 장치로 구현되어 함께 동작합니다.
- Register Alias Table (RAT) - Architectural Register를 그 시점의 비어 있는 Physical Register로 매핑 (register renaming)
- Reservation Station / Scheduler - 명령어 윈도우 안의 명령어들이 어떤 값을 기다리고, 어디로 결과를 보내는지 매 cycle 갱신하며 실행 가능해진 명령어를 실행 유닛으로 내보냄
- Reorder Buffer (ROB) - 내부적으로는 out-of-order로 실행되더라도, 결과를 외부로 commit할 때는 원래 프로그램 순서대로 정리 (in-order retire) 하고, misprediction 시 rollback의 기준점이 됨
요약하면, 앞 절에서 “Reservation Station + RAT + Instruction Window”로 설명한 자료구조들이 실제 Intel Core 안에서도 같은 이름의 장치로 있고, 여기에 in-order commit을 위한 Reorder Buffer가 더해집니다.
VLIW: 소프트웨어적 접근
다시 보는 OOO의 Loop Pipeline, 그리고 그 비용
VLIW로 넘어가기 전에 OOO의 비용을 짚어 둡니다. OOO Processor는 앞 절의 세 단계(speculative trace 펼치기, register renaming, 명령어 윈도우 위의 data-flow graph 갱신)를 하드웨어가 매 cycle 동적으로 수행합니다.
이 모든 일을 하드웨어가 직접, 그리고 동적으로 해내야 한다는 점은 곧 상당한 설계 복잡도를 의미합니다. 게다가 Branch Prediction이 틀린 순간에는 그동안 진행한 작업을 되돌리는 Rollback이 필요해집니다. 더 많은 병렬성을 짜내려고 명령어 윈도우를 크게 잡을수록, 한 번 예측이 빗나갔을 때 되돌려야 하는 양이 커지고 복구 로직 자체도 함께 복잡해집니다.
VLIW의 발상
VLIW는 여기에 정반대 방향의 답을 내놓습니다. OOO와 똑같은 결과(즉 루프 iteration들을 펼친 data-flow graph를 매 cycle 병렬 실행하는 모습)를, 하드웨어가 동적으로 만들어내는 대신 소프트웨어(컴파일러)가 미리 정적으로 만들어 두는 것입니다. 컴파일러가 Loop Pipeline 모양을 컴파일 타임에 결정해 두면, 하드웨어는 그 계획대로 매 cycle 정해진 일만 하면 되므로 Reorder Buffer, renaming, 명령어 윈도우 같은 동적 스케줄링 장치를 없앨 수 있고, branch prediction도 훨씬 단순해집니다. 이 갈래의 대표 아키텍처가 VLIW(Very Long Instruction Word) 입니다.


생긴 모습은 OOO 때 본 그림과 닮아 있지만, 이 파이프라인을 누가 만들어 내느냐가 결정적으로 다릅니다. OOO에서는 매 cycle 하드웨어가 동적으로 그려내던 그림을, VLIW에서는 컴파일러가 미리 그려서 ISA 차원에서 하드웨어에 던져 줍니다. 하드웨어는 그 모양을 그대로 반복 실행하면 되기 때문에, 하드웨어가 훨씬 단순해지고 실행 효율성도 더 좋을 수 있습니다.
하드웨어가 동적으로 하느냐, 소프트웨어가 정적으로 하느냐의 대비는 「프로세서 설계의 핵심 질문」의 ①과 ② 접근에 해당하고, 뒤의 GPU와 NPU 비교에서 다시 나옵니다.
VLIW 아키텍처의 구조
VLIW의 발상이 실제 하드웨어 도면 위에 어떻게 그려지는지 보겠습니다.
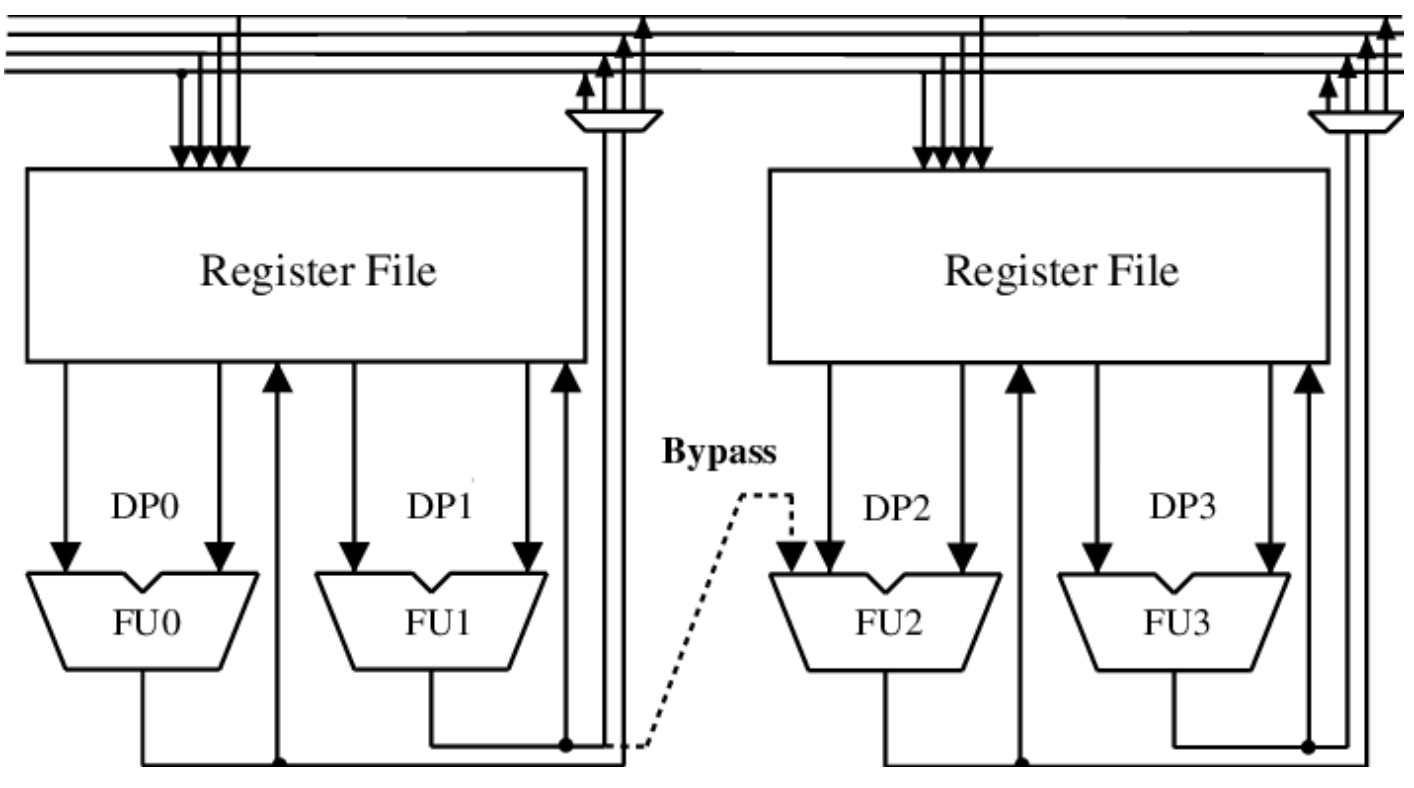
그림에서 가장 눈에 띄는 점은, 여러 Functional Unit(연산 유닛)이 병렬로 늘어서 있고 그 옆에 값을 저장·읽을 수 있는 레지스터 파일이 함께 배치되어 있다는 점입니다. 이런 외형 자체는 사실 OOO Processor의 실행부와도 꽤 닮아 있습니다. 결정적인 차이는 이 유닛들에게 매 cycle 무엇을 시킬지를 누가, 어떻게 표현하느냐에 있습니다.
Register File Partitioning
VLIW에서 한 가지 미묘한 어려움이 있습니다. Functional Unit 개수가 늘어날수록, 그 모두가 하나의 큰 레지스터 파일에 동시에 물리는 것이 점점 어려워진다는 점입니다. 레지스터 파일에는 동시에 읽고 쓸 수 있는 포트(port) 개수가 정해져 있는데, 유닛이 많아질수록 필요한 포트 수가 폭발적으로 늘고, 포트가 많아질수록 레지스터 파일의 회로 자체가 급격히 복잡해집니다.
그래서 VLIW에서는 보통 레지스터 파일을 여러 개로 파티션해서 각 파티션에 일부 Functional Unit만 묶어 두는 형태로 설계합니다. 한 파티션 안에서는 익숙한 레지스터 read/write로 통신하지만, 서로 다른 파티션 간에는 레지스터 파일을 직접 공유할 수 없고 별도의 Interconnect를 거쳐 데이터를 옮겨야 합니다. 이는 컴파일러가 명령어를 배치할 때 “이 값은 어느 파티션에서 살아야 하나”까지 함께 결정해야 한다는 것을 의미하고, VLIW 컴파일러를 어렵게 만드는 요인 중 하나입니다.
Explicit Parallel Programming과 “Very Long Instruction Word”
이 구조 위에서 코드를 짤 때, VLIW는 sequential한 명령어 한 줄에 한 가지 일을 시키는 식이 아니라, 한 번에 여러 Functional Unit이 무엇을 할지를 명시적으로(Explicit) 한꺼번에 표현합니다. 즉 “한 cycle = 여러 명령어 묶음”이고, 각 묶음 안에는 해당 cycle에 각 유닛이 수행할 동작이 그대로 들어 있습니다.
예를 들어 한 cycle에 3개의 Functional Unit이 동시에 동작한다면, 명령어 한 묶음 안에 3개의 Sub-instruction이 함께 묶여 있고, 다음 cycle에는 또 다른 3개가 묶음으로 표현되는 식입니다. 이렇게 묶음 단위로 진행되는 명령어 흐름이 곧 앞에서 본 VLIW Loop Pipeline 그림과 같은 모양을 만들어 냅니다.
이렇게 한 번에 하드웨어 전체를 제어하기 위한 명령어가 매우 길어지기 때문에, 이 아키텍처에 Very Long Instruction Word(VLIW)라는 이름이 붙은 것입니다. 다음 절에서는 이 “한 명령어로 여러 유닛을 동시에 제어하는” 표현 방식이 RISC/CISC와 어떻게 다른지를 인코딩 관점에서 정리해 봅니다.
Very Long Instruction Word (VLIW): Horizontal Encoding
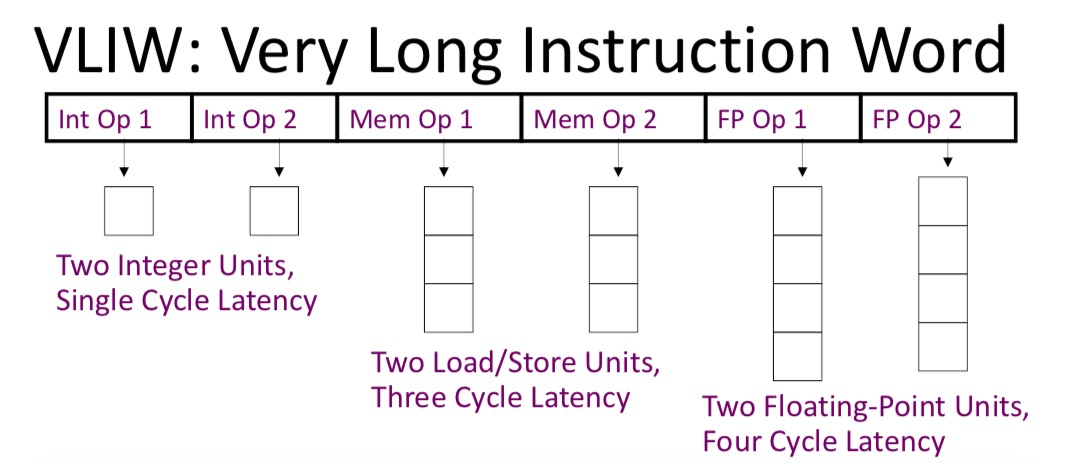
이 절의 제목인 “Very Long Instruction Word”는 이름 그대로, 한 cycle에 하드웨어 전체에게 무엇을 시킬지가 한 줄에 길게 적혀 있는 명령어 형식을 가리킵니다. 이 형식을 인코딩 관점에서 보면, 앞서 Instruction-Level Pipelining 절에서 다뤘던 Vertical Encoding의 정반대 방향에 위치합니다. 그래서 이 방식을 흔히 Horizontal Encoding이라고 부릅니다.
| Vertical Encoding (RISC/CISC) | Horizontal Encoding (VLIW) | |
|---|---|---|
| 명령어가 담은 정보 | 어떤 동작을 할지가 비트 단위로 인코딩되어 압축되어 있음 | 하드웨어의 각 유닛이 그 cycle에 무엇을 할지 펼쳐서 그대로 적혀 있음 |
| 하드웨어 매핑 | 디코딩 단계를 거쳐야 비로소 어떤 유닛이 어떤 일을 할지가 결정됨 | 명령어(bundle)의 슬롯이 유닛과 1:1로 대응. 각 슬롯의 operation은 여전히 decode됨 |
| 누가 결정하나 | 하드웨어가 디코딩하면서 신호를 분기 (① 접근) | 소프트웨어(컴파일러)가 명시적으로 미리 결정 (② 접근) |
쉽게 말해 Vertical Encoding은 “무엇을 할지 짧게 적어 두면, 디코더가 알아서 풀어서 하드웨어 곳곳에 보내겠다”는 방식이고, Horizontal Encoding은 “하드웨어 각 부분이 매 cycle 무엇을 할지를 소프트웨어가 직접 표 형식으로 늘어놓겠다”는 방식입니다.
Vertical vs. Horizontal Microcode
이 대비를 microcode 수준으로 내려가 보면 모양이 가장 분명합니다. 다만 vertical/horizontal microcode는 원래 제어 저장소 안의 microinstruction 표현을 나누는 구분이고, RISC/VLIW ISA에 그대로 1:1 대응하는 것은 아닙니다. 여기서는 “압축해서 decoder에 맡기느냐, 펼쳐서 유닛에 직결하느냐”라는 축을 빌려 오는 비유로 씁니다.
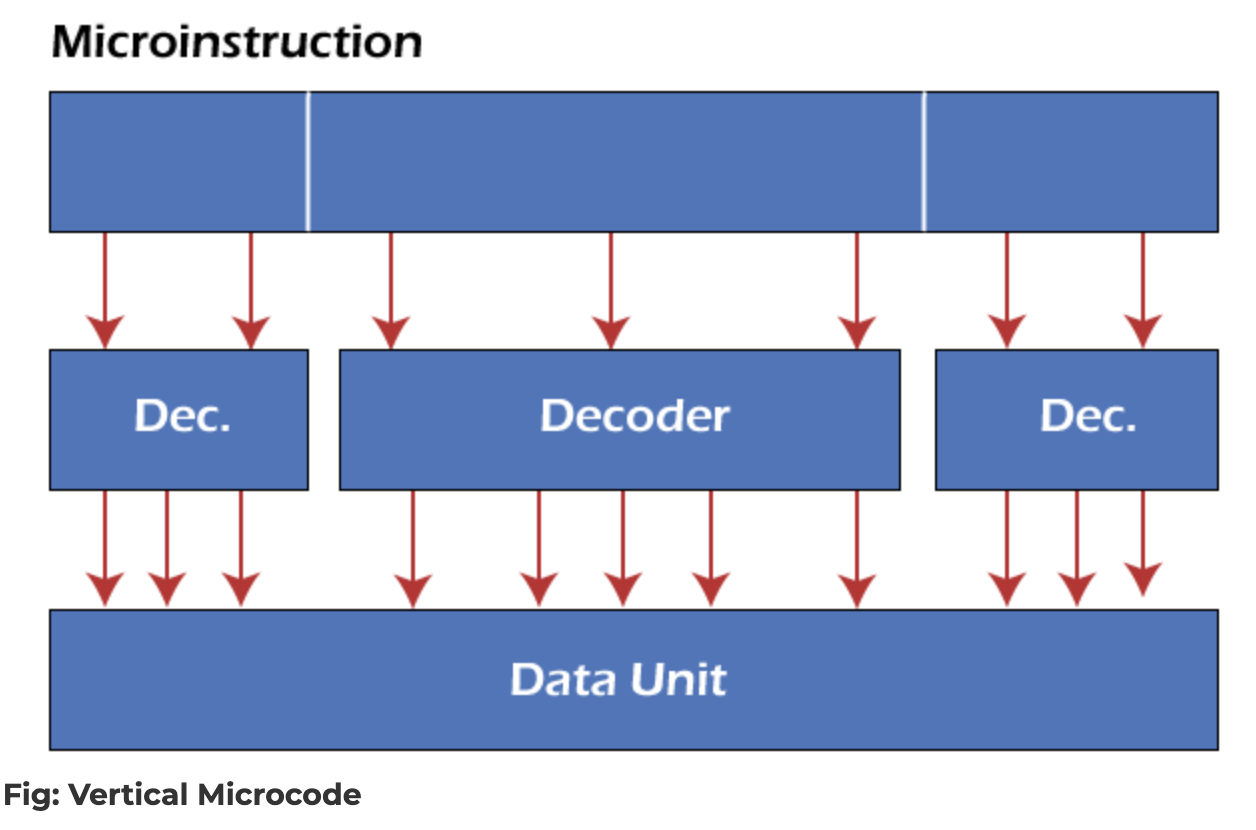
microinstruction이 여러 Decoder를 거쳐 Data Unit의 신호로 펼쳐짐
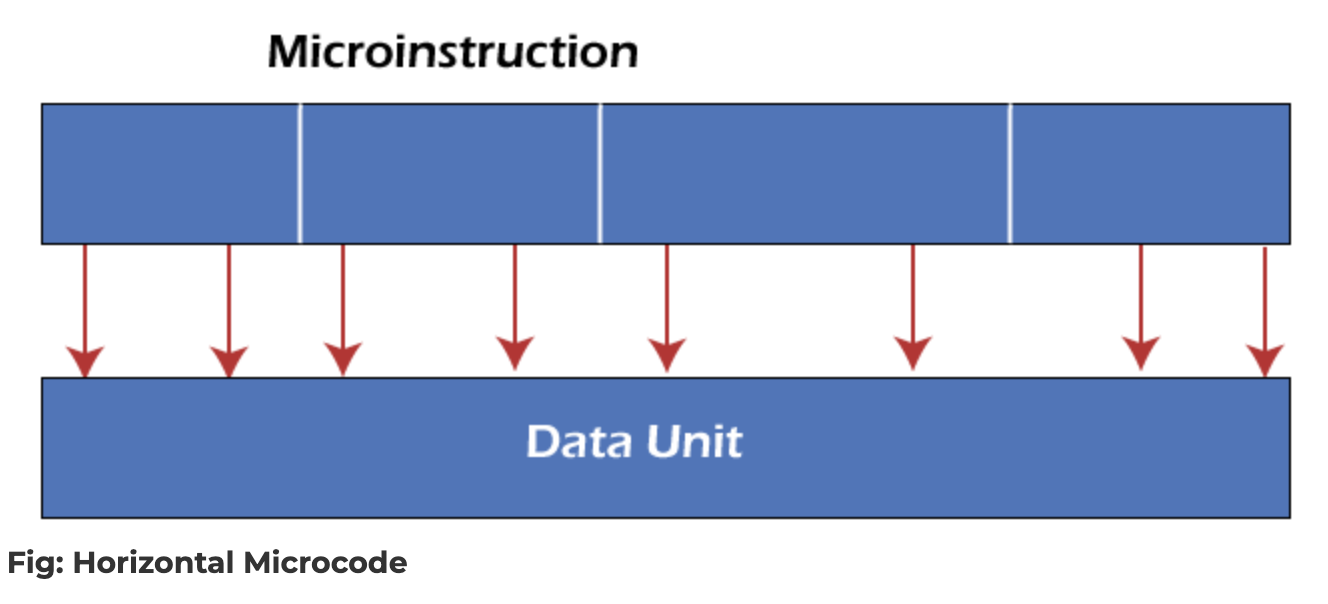
microinstruction의 각 비트 묶음이 Decoder 없이 곧장 Data Unit의 각 부분으로 연결
Can Be Hierarchical: 두 방식을 계층적으로 섞어 쓸 수 있습니다(아래 참조).
왼쪽 Vertical은 명령어를 받아 Decoder가 하드웨어 제어 신호로 펼쳐 주는 형태이고, 오른쪽 Horizontal은 명령어 비트가 곧장 Data Unit의 각 부분에 직결되는 형태입니다.
두 방식은 서로 배타적이지 않다 (계층적 결합)
두 방식은 한 시스템 안에서 계층적으로(hierarchical) 함께 쓸 수 있습니다. 흔히 쓰이는 절충은 다음과 같습니다.
- 상위 레벨에서는 Horizontal Encoding으로 “어떤 유닛이 어떤 묶음에 참여하는지” 전체 구조를 명시적으로 펼쳐 둔다
- 각 묶음 안의 개별 유닛에 들어가는 명령어는 Vertical Encoding으로 짧게 인코딩하고, 그 단위에서는 디코더가 다시 하드웨어 제어 신호로 풀어낸다
이렇게 하면 명령어 길이를 억제하면서도 여러 유닛을 한 cycle에 동시에 제어할 수 있습니다.
Horizontal Encoding은 HW 디테일을 SW에 노출한다
Horizontal Encoding은 하드웨어의 디테일 자체를 그대로 소프트웨어에 노출합니다. 명령어의 각 비트가 어느 유닛에 직결되는지가 ISA 차원에서 보이기 때문에, 그 코드를 만드는 컴파일러나 프로그래머가 하드웨어 구조를 깊이 이해하고 있어야 합니다. 어떤 유닛이 매 cycle 무엇을 할지를 명시적으로 코딩해 줘야 하는 것입니다.
반면 Vertical Encoding은 짧은 명령어 뒤에 디코더가 모든 디테일을 흡수하므로, 소프트웨어는 하드웨어 구조를 몰라도 코드를 작성할 수 있습니다. 강의 초반에 본 「프로세서 설계의 핵심 질문」으로 다시 돌아가면, Vertical = ① Microarchitecture 최적화 의존, Horizontal = ② Compiler/Programmer 최적화 의존이라는 매핑이 정확히 여기에서 성립합니다. 인코딩 방식을 고르는 일은 하드웨어와 소프트웨어의 책임 경계를 어디에 둘지 정하는 일입니다.
Modulo Scheduling: SW Pipelining의 핵심
지금까지 본 VLIW 기법(Loop Pipeline, Horizontal Encoding, Functional Unit 병렬 제어)은 오래된 아이디어입니다. 컴파일러가 이런 loop pipeline을 만드는 대표 알고리즘이 Modulo Scheduling이고, 대표 구현이 Iterative Modulo Scheduling입니다.
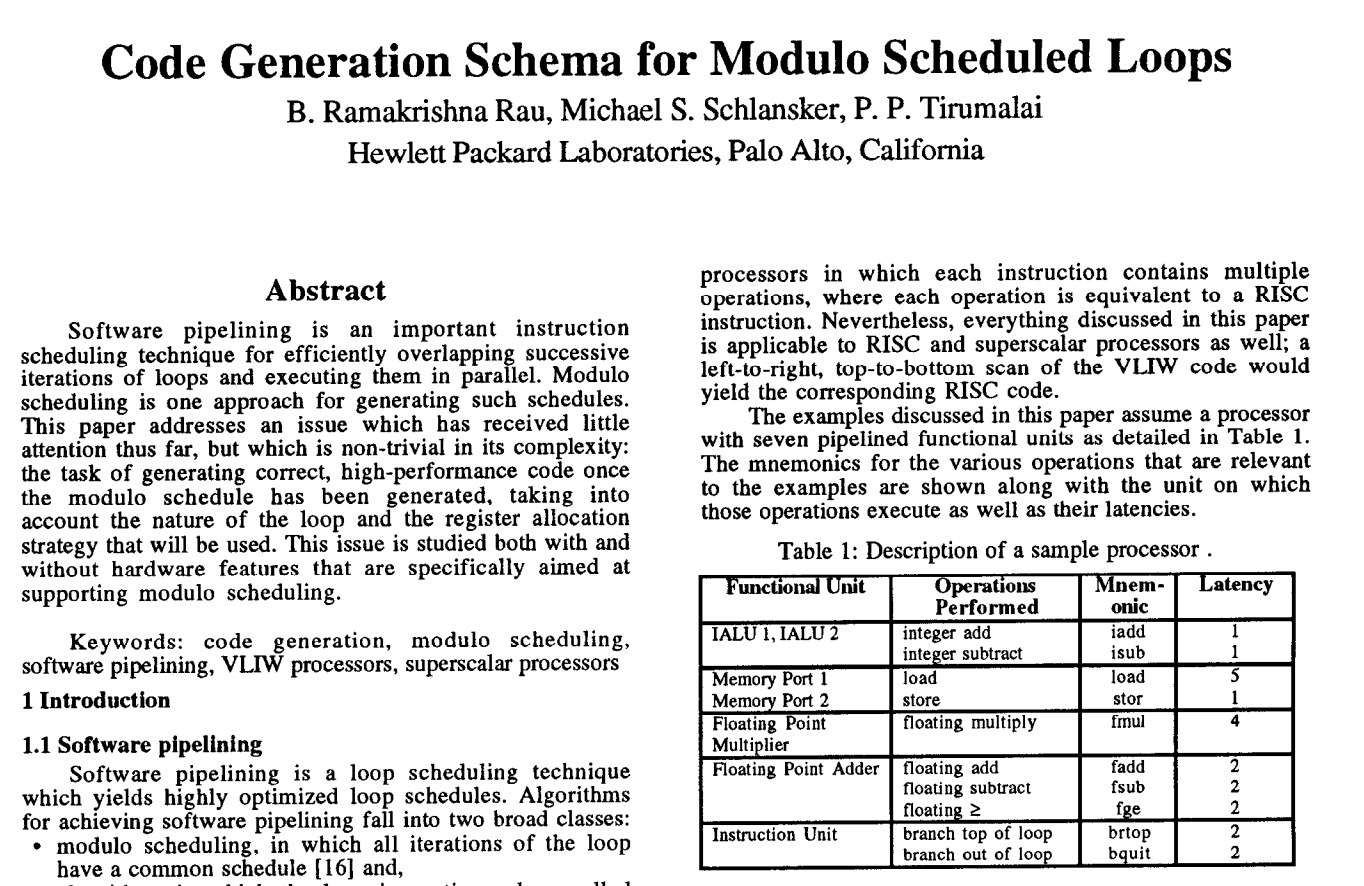
이 알고리즘의 개념은 1980년대에 Bob Rau가 처음 만들었고, 그가 HP Labs에 있을 때 잘 정리해서 1994년 논문으로 발표했습니다.
B. Ramakrishna Rau, “Iterative modulo scheduling: an algorithm for software pipelining loops,” Proceedings of the 27th Annual International Symposium on Microarchitecture (MICRO-27), 1994.
이후의 production 컴파일러(LLVM MachinePipeliner, GCC의 SMS 등)는 Swing Modulo Scheduling 같은 변형을 쓰지만, 모두 이 modulo scheduling의 틀 위에서 SW Pipelining을 구현합니다.
알고리즘이 도입한 주요 개념들
이 강의에서 알고리즘 자체를 깊게 다루지는 않습니다. 대신, Bob Rau가 제안한 여러 가지 주요 개념들이 어떤 모양인지를 그림으로 한 번 훑고 넘어갑니다. 아래 두 그림이 그 전체 그림을 압축해서 보여 줍니다. 두 그림은 서로 다른 예제 루프입니다.
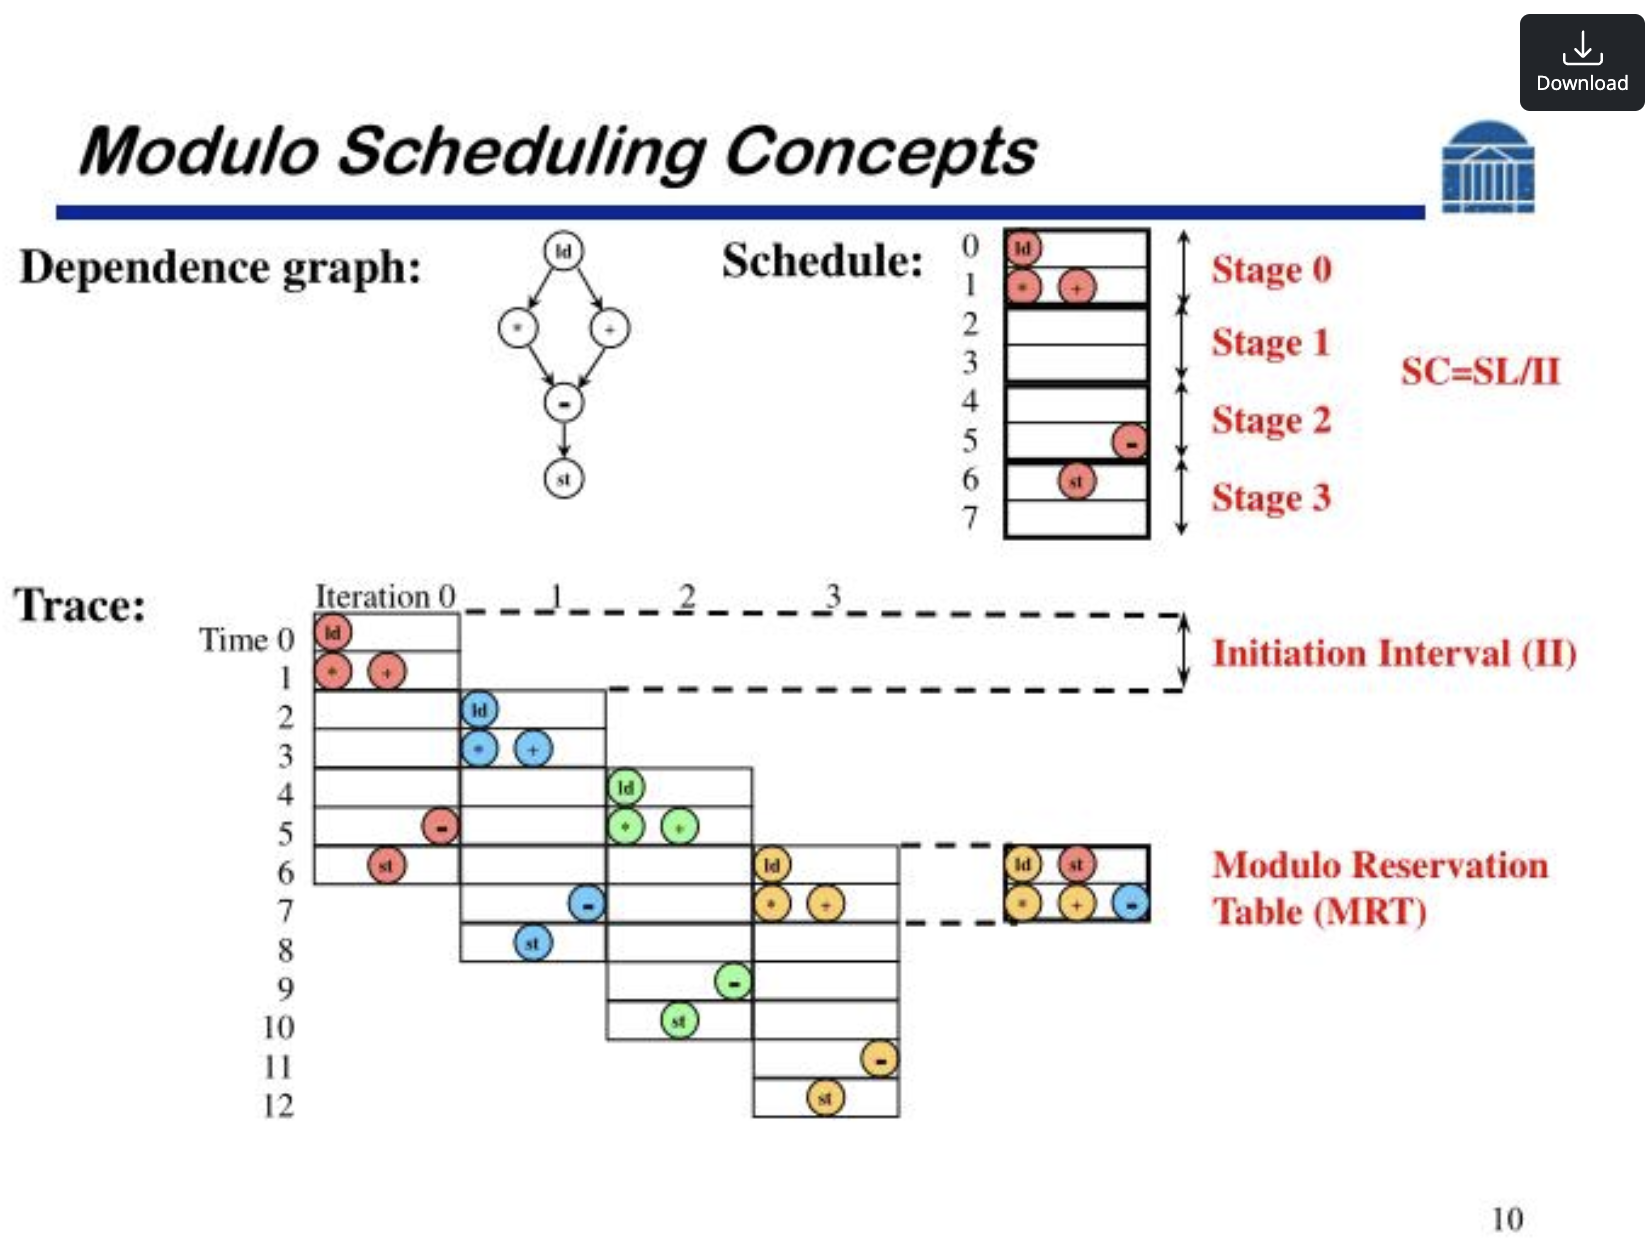
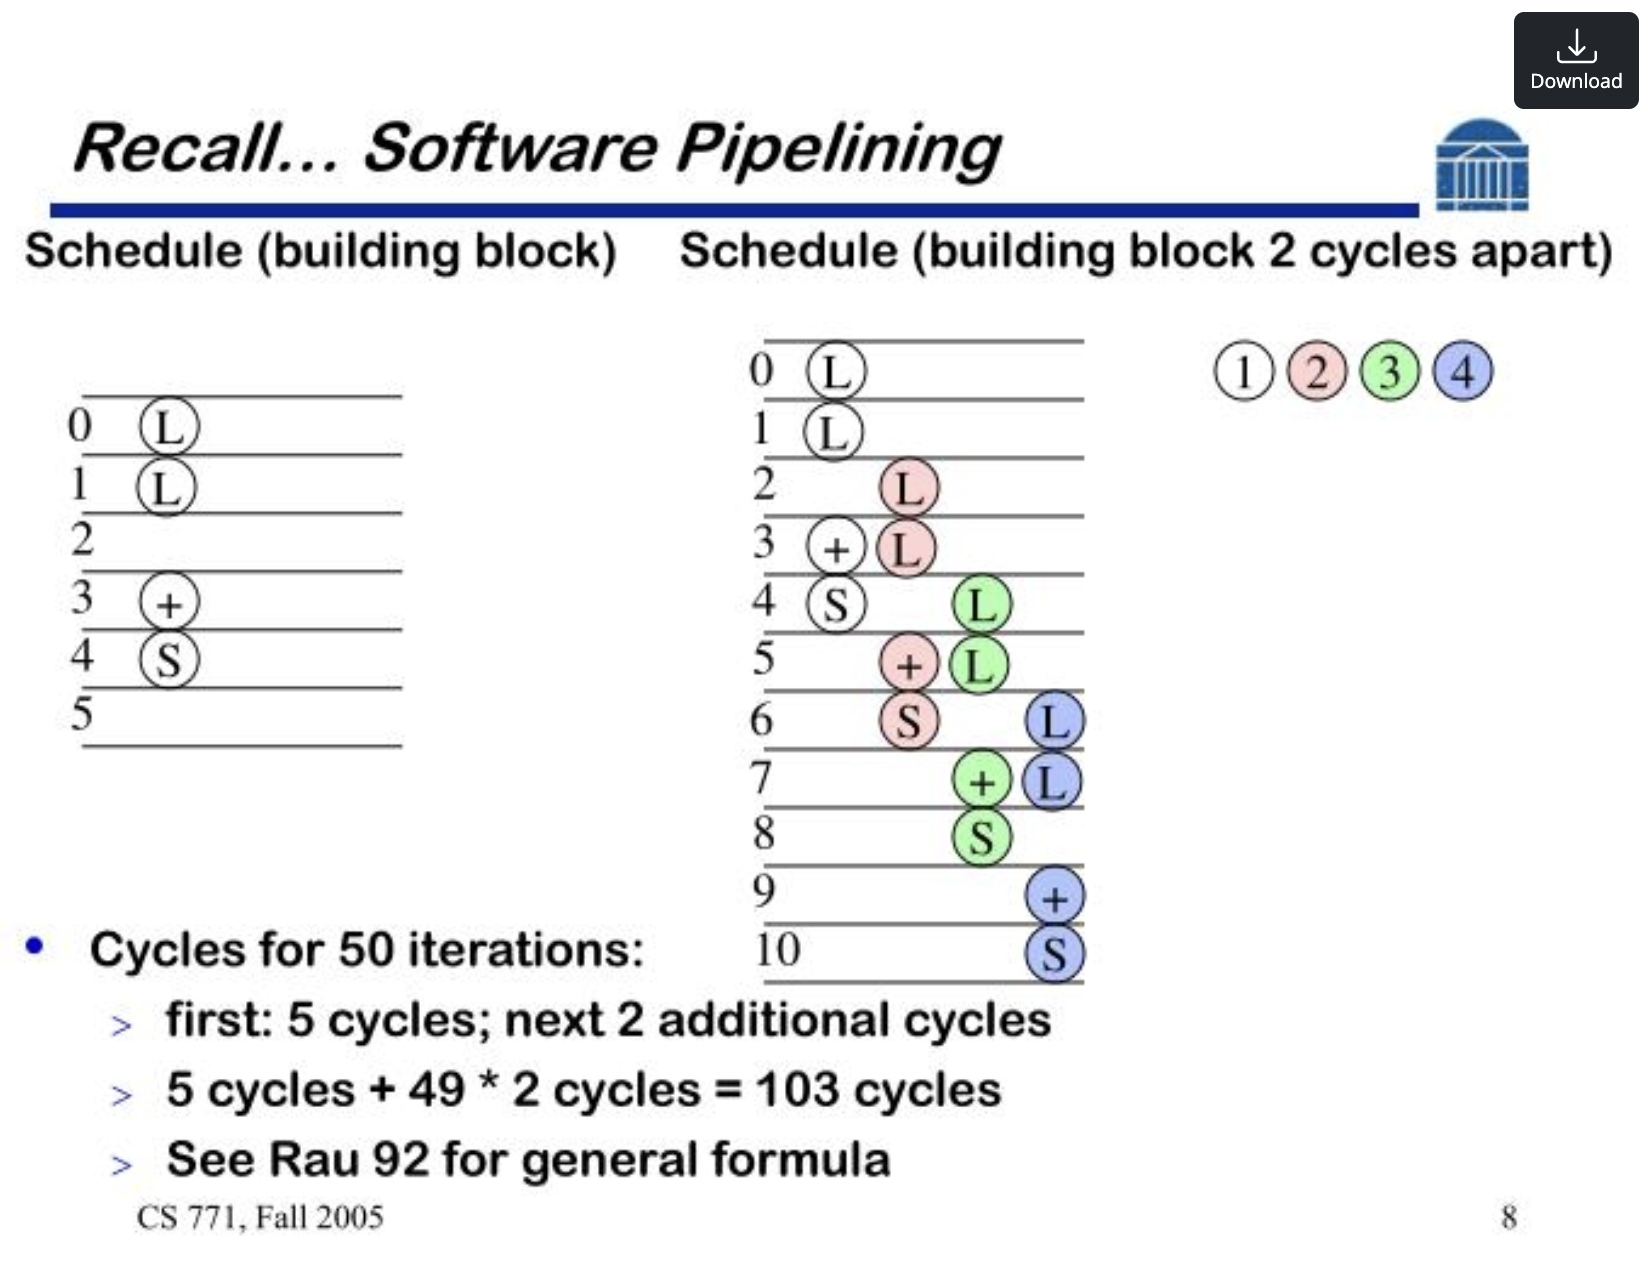
요약하면 이렇습니다. Dependence Graph(명령어 간 의존성)와 Schedule(매 cycle 어떤 명령어가 어떤 stage에 들어가는지), 그리고 다음 iteration을 시작하는 간격인 Initiation Interval(II), 한 II 안에서 어느 cycle에 어느 자원이 쓰이는지를 II로 나눈 나머지 위치에 기록해 자원 충돌을 추적하는 Modulo Reservation Table(MRT), 이 개념들이 한 묶음으로 작동해서, 컴파일러가 루프를 파이프라인된 형태로 배치하고 그 위에 새로운 iteration을 일정 간격으로 계속 흘려보낼 수 있게 만듭니다. 슬라이드 두 번째에 나오는 “50 iterations → 5 cycles + 49 × 2 cycles = 103 cycles” 같은 예시가 그 효과를 그대로 보여 주는 사례입니다.
Modulo Scheduling은 OOO Processor가 실행 중에 하던 일, 즉 iteration들의 명령어를 펼쳐 의존성에 맞게 재배치하고 cycle마다 무엇을 동시에 실행할지 정하는 일을 컴파일러가 미리 합니다. OOO의 Reservation Station·RAT·Reorder Buffer가 동적으로 관리하던 data-flow graph, 자원 할당, 실행 시점이 컴파일 시점의 Dependence Graph, MRT, Schedule로 바뀝니다.
CGRA (Coarse-Grained Reconfigurable Architecture)
최근 AI accelerator 문맥에서는 VLIW 계열의 정적 제어 방식을 Reconfigurable Architecture라고 설명하기도 합니다. 넓은 control word나 command stream이 여러 functional unit과 data path의 동작을 지정하므로, software가 cycle마다 hardware의 사용 구성을 바꾸는 것으로 볼 수 있기 때문입니다. 엄밀히 VLIW와 reconfigurable processor가 같은 용어라는 뜻은 아니며, compiler가 hardware 동작을 명시적으로 schedule한다는 계보와 공통점을 가리킵니다.
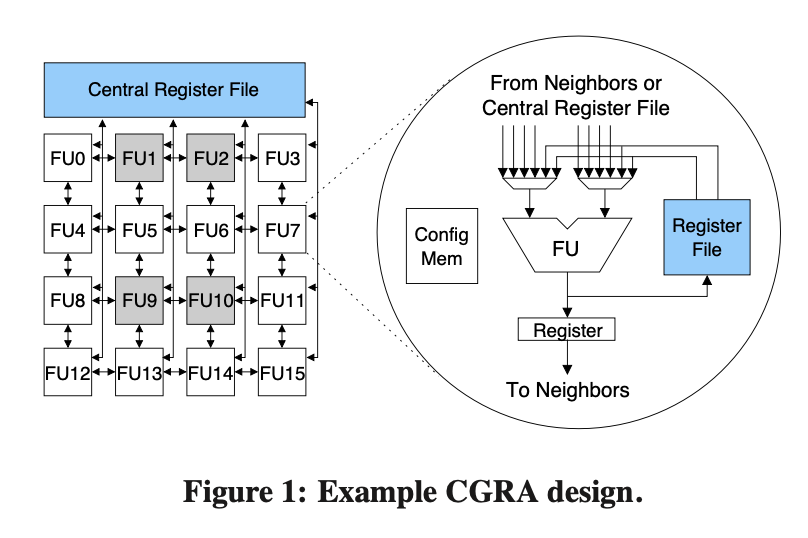
CGRA(Coarse-Grained Reconfigurable Architecture)는 위 그림처럼 functional unit을 2차원 격자로 배열하고 이웃끼리 연결한 구조입니다. 각 FU의 Config Memory에 “이 cycle에 무엇을 계산하고 결과를 어느 이웃으로 보낼지”를 적어 두므로, software가 cycle마다 연산뿐 아니라 FU 사이의 데이터 경로까지 구성합니다. VLIW보다 더 많은 hardware detail을 control word에 노출한다는 뜻에서 이 강의는 이를 “Extreme VLIW”로 비유합니다(표준 분류명은 아닙니다).
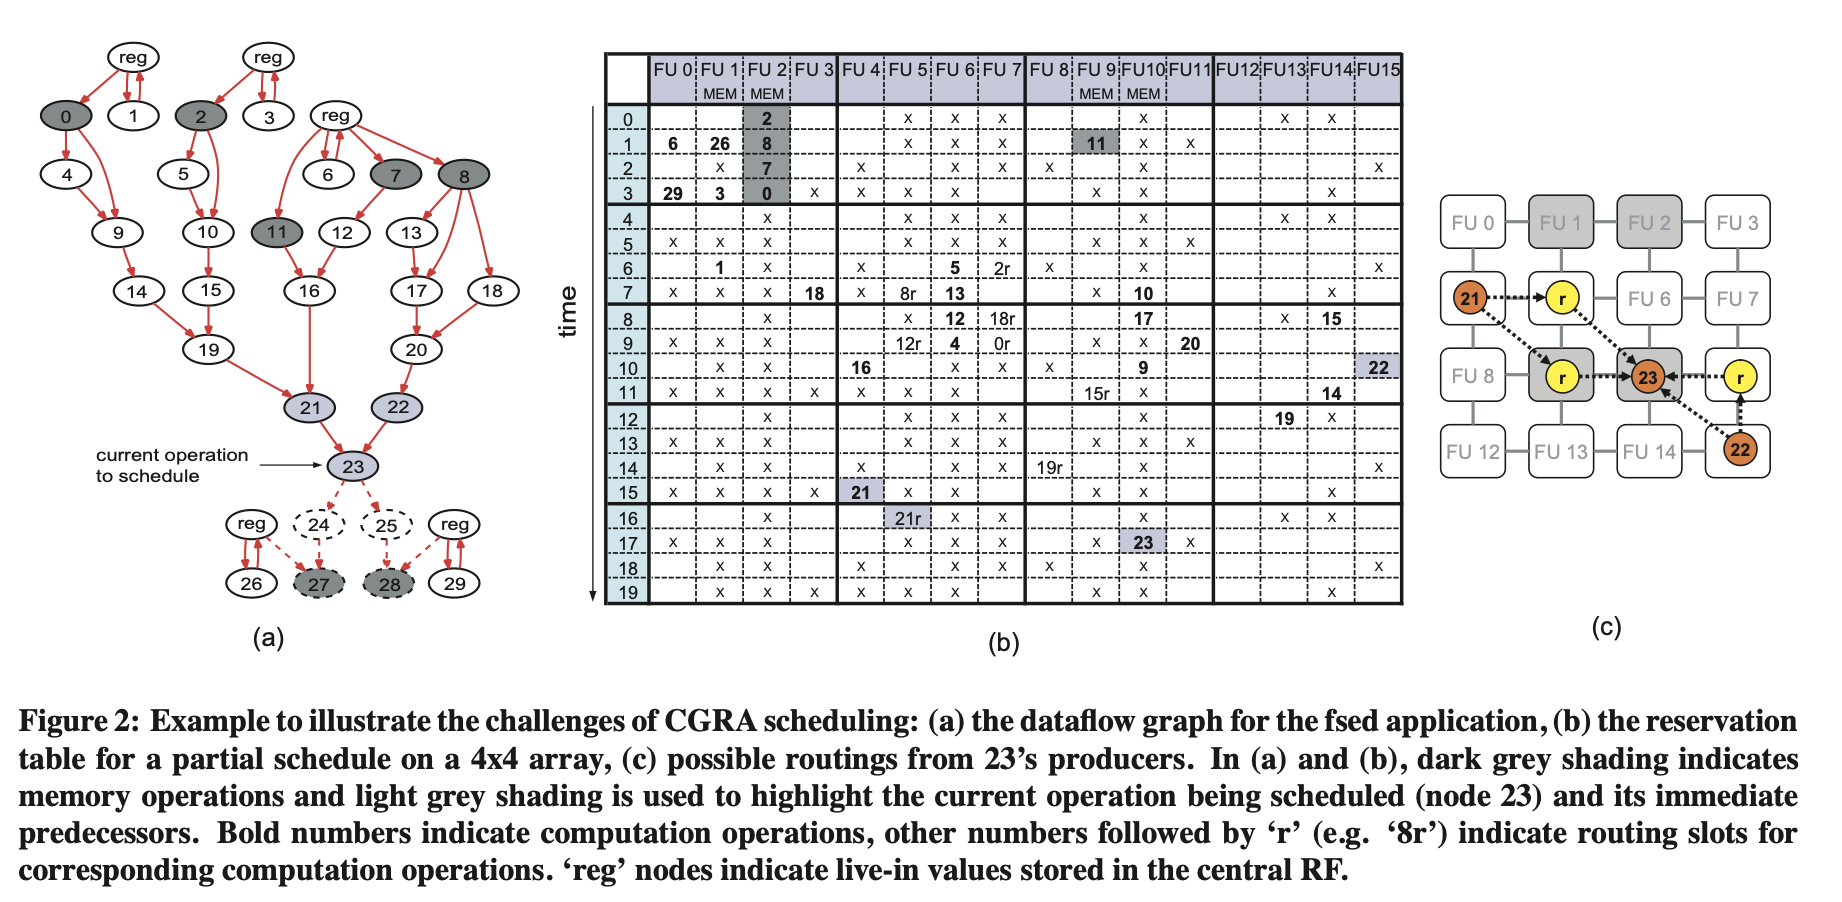
두 번째 그림은 CGRA에서의 modulo scheduling입니다. (b)의 reservation table은 행이 cycle, 열이 FU이고, 연산을 배치할 때 (c)처럼 앞 연산(21, 22)의 결과를 어느 FU를 거쳐 가져올지(routing, 표의 r)까지 함께 정해야 합니다. 앞 절의 MRT에 FU 위치라는 공간 축이 더해진 형태입니다.
그림 출처: Park et al., “Edge-centric Modulo Scheduling for Coarse-Grained Reconfigurable Architectures”, PACT 2008
일부 NPU도 여러 compute·DMA unit의 실행과 data movement를 compiler가 미리 구성합니다. 강의 후반부에서는 이 제한된 공통점, 즉 hardware detail을 더 많이 노출할수록 compiler의 scheduling 책임이 커진다는 점을 사용합니다.
Loop-Level Pipelining 정리
지금까지 다룬 내용을 크게 세 가지로 정리할 수 있습니다.
- Loop Pipelining = loop iteration을 중첩, Latency Hiding - 한 iteration이 끝나기 전에 다음 iteration을 시작해 명령어 실행을 겹치는 것이 요점. 거의 모든 프로그램이 실행 시간을 루프에 쏟기 때문에, 이 효과를 잘 내는 것이 곧 성능 향상의 관건이 됩니다.
- Out-of-Order Processor에서는 하드웨어가 동적으로 이 효과를 만들어냅니다. 그 이론적 기반은 1960년대의 Tomasulo Algorithm1으로, 오늘날의 ROB·Reservation Station·RAT까지 곧장 이어집니다.
- VLIW (또는 Reconfigurable) Processor에서는 소프트웨어(컴파일러)가 정적으로 이 효과를 만들어냅니다. 대표적인 컴파일러 알고리즘이 1994년의 Iterative Modulo Scheduling입니다.
정적 접근(VLIW)의 장단점
같은 효과를 SW가 미리 만들어 두는 방식의 장단점도 짚어 두면 좋습니다.
- 장점
- 하드웨어가 훨씬 단순해집니다 (Reorder Buffer, renaming, 명령어 윈도우 같은 동적 스케줄링 장치 불필요. branch predictor는 남기더라도 단순해짐).
- 컴파일 타임에 더 다양한 스케줄·최적화 옵션을 충분히 탐색할 수 있어, 잘 짜인 워크로드에 대해서는 더 최적화된 코드를 만들 수 있습니다.
- 단점
- Integer 프로그램(워드프로세서·웹브라우저류, 즉 Intel CPU에서 흔히 도는 코드)처럼 분기가 많고 동적 이벤트가 많은 워크로드에는 약합니다. 루프 안에 분기가 들어 있으면 의존성을 정적으로 풀기가 까다로워지고, 캐시 미스 같은 이벤트도 컴파일 타임에 모두 고려하기 어렵습니다.
- 분기를 줄이기 위해 Predication2 같은 기법을 도입할 수 있지만, 그만큼 컴파일러가 복잡해집니다.
- 하드웨어가 단순한 만큼, 코드가 충분한 병렬성을 갖지 못한 경우에는 하드웨어가 그것을 보완해 줄 방법이 없습니다. 프로그램을 다시 짜거나 더 강력한 컴파일러를 쓰는 수밖에 없습니다.
요약하면 Integer-heavy한 워크로드에서는 동적(OOO) 접근이 일반적으로 더 효율적이고, 반복적이고 의존성이 깔끔한 워크로드(많은 ML / DSP / 미디어 처리 등)에서는 VLIW 계열이 잘 맞습니다.
Q&A
강의 중 나온 질문들을 정리합니다.
Q. VLIW 프로세서에서 동작시킬 소프트웨어를 위한 지정된 언어가 있나요? 아니면 컴파일러로 지정 가능한가요? 우리가 흔히 말하는 Integer 프로그램은 결국 C/C++ 같은 기존 언어로 짜여 있고, VLIW 프로세서가 그런 프로그램을 타깃하려면 그 언어들을 그대로 지원해야 합니다. 따라서 “VLIW 전용 언어”가 따로 있다기보다는, 순차 코드(C/C++ 등)를 받아 병렬 파이프라인 형태로 변환하는 컴파일러 기법이 핵심입니다.
Q. VLIW 구조에 잘 맞지 않는 코드는 버블이 발생할 텐데, 별도로 처리해 주는 방법이 있나요? 안타깝게도 하드웨어 단에서 보완해 줄 방법은 거의 없습니다. VLIW는 애초에 하드웨어를 단순하게 만들기 위해 도입되는 구조라, 코드가 충분한 병렬성을 제공하지 못하면 그대로 손실로 이어집니다. 정공법은 프로그램을 다시 짜거나 더 고도화된 컴파일러를 쓰는 것이고, 특히 루프 안 분기가 문제일 때는 Predication으로 분기를 평탄화해 SW Pipelining을 적용할 수 있도록 ISA가 보조 기법을 함께 제공하기도 합니다.
Q. TPU나 Tensor Core의 Systolic Array 같은 하드웨어 블록 프로그램에는 VLIW가 유리한가요? Systolic Array3와 VLIW는 서로 다른 층위의 설계입니다. VLIW는 명령어를 어떻게 발행하느냐의 문제이고, systolic array는 연산기와 데이터 전달을 어떻게 배열하느냐의 문제라서, VLIW 계열 제어 프로세서가 systolic matrix unit에 명령을 보내는 조합도 가능합니다(TPU의 MXU가 systolic array이고 그 앞단을 컴파일러가 정적으로 스케줄합니다. Tensor Core 내부 배치는 공개되어 있지 않습니다). systolic array 자체는 프로그래머빌리티 제약이 크지만 하드웨어 효율은 훨씬 높으므로, “VLIW가 유리하냐”보다는 “어떤 제어 방식과 어떤 연산기 배열을 짝지을 것이냐”의 문제로 보는 것이 맞습니다.
이 두 접근(HW 동적 / SW 정적)의 대비는 이후 살펴볼 GPU와 NPU의 설계 철학 차이로 그대로 이어집니다.
Thread-Level Pipelining: CPU의 전환
지금까지 Instruction-level pipelining에서는 한 명령어의 stage를, Loop-level pipelining에서는 루프의 iteration을 겹쳤습니다. 이번 절의 단위는 thread입니다. 이 강의는 이를 Thread-level pipelining이라 부르고, 교과서 용어로는 hardware multithreading 또는 TLP(thread-level parallelism)입니다. GPU는 Thread 수준의 Latency Hiding을 극대화하는 방향으로 설계되어 왔으므로, 이 절이 GPU 절로 이어집니다.
이 전환의 배경에는 CPU 아키텍처의 변곡점이 있습니다.
CPU의 변곡점: Clock Frequency Scaling의 종료
GPU가 등장하던 시기의 CPU부터 봅니다.
1990년대: ILP의 황금기
1990년대에는 Intel 프로세서의 클럭 속도가 세대마다 크게 올랐고, 새로운 아키텍처 아이디어가 빠르게 칩에 반영되었습니다.
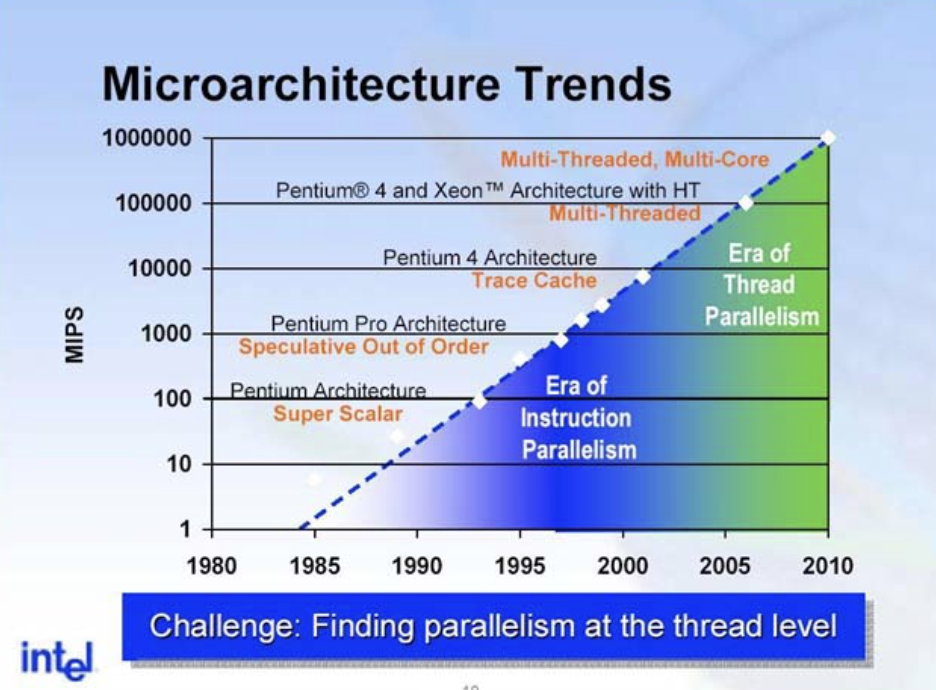
이 시기의 구조적 개선은 거의 전부 명령어 수준의 중첩(Overlap)을 어떻게 더 잘 짜낼 것인가에 집중되어 있었습니다. 앞서 다룬 두 축이 정확히 이 시기에 정착됩니다.
- 한 명령어를 어떻게 stage로 잘게 나눠 파이프라인할 것인가 (Instruction-Level Pipelining)
- 여러 명령어를 어떻게 잘 중첩해 동시에 실행할 것인가 (OOO를 통한 Loop-Level Pipelining)
이 둘을 통틀어 Instruction-Level Parallelism (ILP) 라고 부르고, 1990년대~2000년대 초의 CPU 설계는 이 ILP를 극대화하는 데 많은 자원과 시간을 쏟아부었습니다. 그림에서도 1990년대 영역이 “Era of Instruction Parallelism” 으로 표시되어 있습니다.
2000년대: Clock Frequency 경쟁의 끝
이 흐름의 한계가 드러난 대표 사례가 Pentium 4입니다. NetBurst microarchitecture는 높은 clock을 목표로 깊은 pipeline을 사용했지만, power·thermal constraint와 branch misprediction penalty 때문에 clock 증가가 기대한 성능 향상으로 이어지기 어려웠습니다. Pentium 4 하나가 frequency scaling 종료의 원인은 아니지만 당시 접근의 한계를 보여 줍니다.
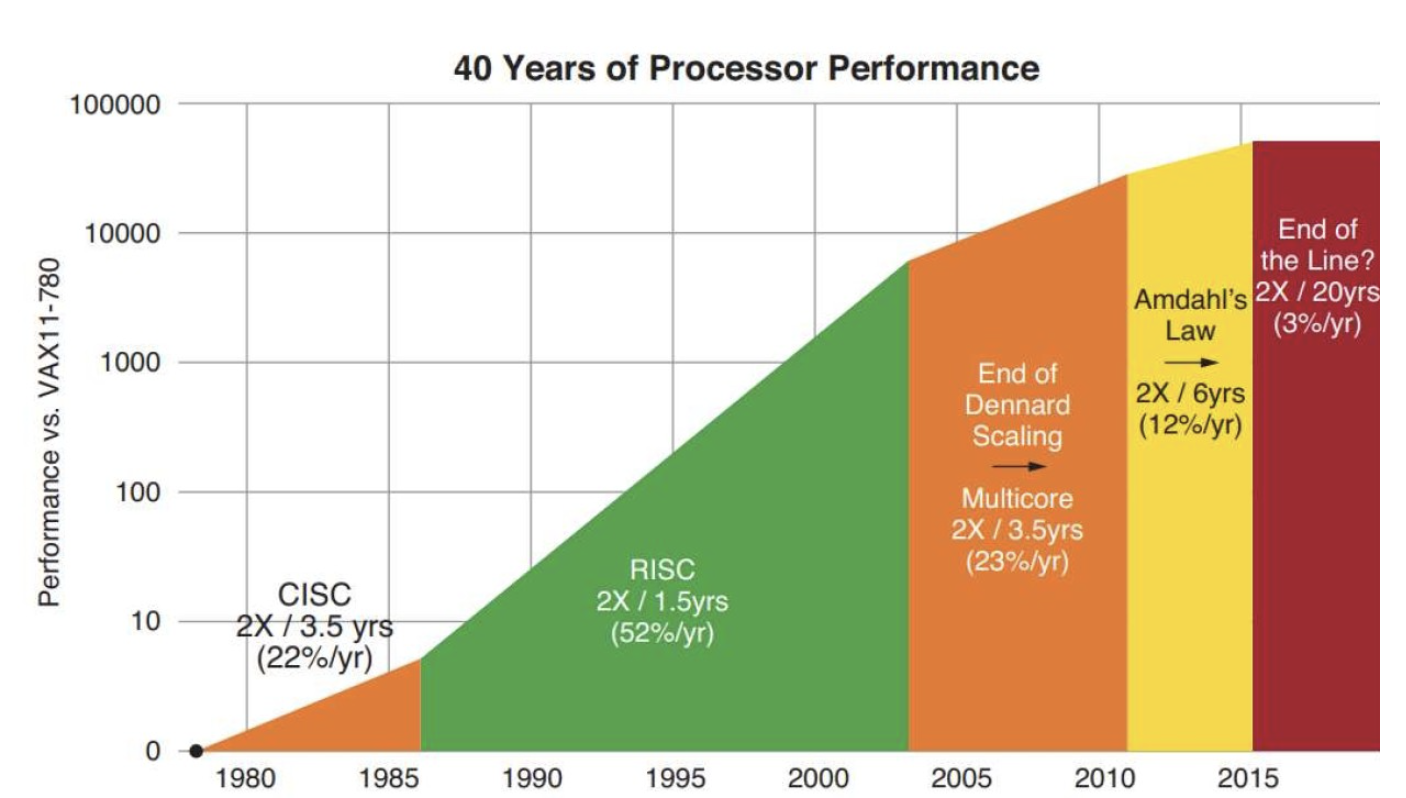
발열의 근본 원인은 Dennard Scaling이 끝난 것입니다. Dennard scaling은 트랜지스터를 줄이면 동작 전압도 함께 줄어 단위 면적당 전력이 일정하게 유지된다는 관찰이었습니다. 2000년대 중반부터 전압을 더 낮출 수 없게 되자(threshold 전압 하한과 leakage 급증) 집적도와 클럭을 올릴수록 단위 면적당 열 밀도가 올라갔고, 냉각이 이를 따라가지 못했습니다. 그래서 클럭을 올려 성능을 얻는 방식은 2000년대에 한계에 이릅니다.
마침 같은 시기에 인터넷과 server 시장이 빠르게 성장하면서 workload의 성격도 바뀌었습니다. 단일 instruction stream 안에서 ILP를 더 찾는 것뿐 아니라, 서로 독립적인 request·session·사용자를 동시에 처리하는 능력이 중요해졌습니다. 이에 따라 CPU 성능 향상의 중심도 더 높은 clock과 single-core ILP만을 추구하는 방식에서 multi-core와 multithreading을 함께 사용하는 방향으로 이동했습니다. 그렇다고 ILP 최적화를 중단한 것은 아닙니다. 각 core에서도 OOO와 branch prediction은 계속 사용하고 개선합니다. 그림의 “Era of Thread Parallelism” 은 이러한 중심 이동을 나타냅니다.
Memory Wall: DRAM Bandwidth를 어떻게 최대한 활용하느냐?
Thread-level 병렬 아키텍처가 서버 시장에서 중요해진 이유 하나는, 서버 워크로드의 성능이 ILP보다 메모리 시스템 활용에 좌우되기 때문입니다. 그 그림을 보려면 우선 일반적인 프로세서의 메모리 계층 구조를 떠올려 봐야 합니다.
위에서부터 차례대로 보면, 실제 연산을 담당하는 Compute Unit들이 가장 위에 있고, 그 밑에 빠른 On-Chip Memory(CPU의 경우 보통 Cache)가 있고, 가장 아래에 DRAM 같은 오프칩 메모리가 자리합니다. 위로 갈수록 빠르고 작고, 아래로 갈수록 느리고 큽니다. 이 구조를 Memory Hierarchy라고 부릅니다.
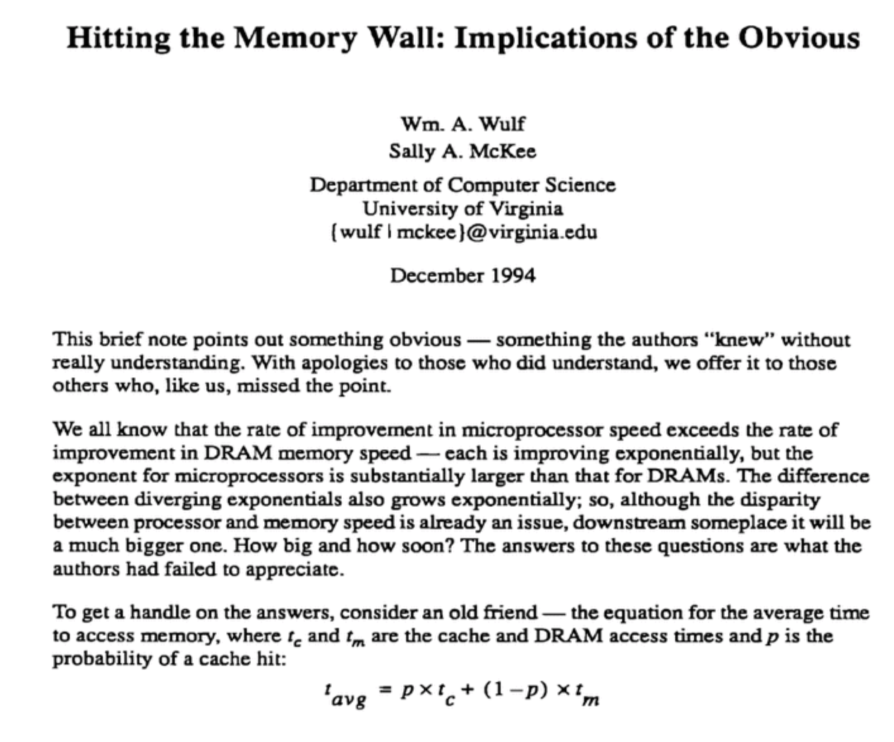
현대 프로세서에서 가장 큰 성능 병목은 이 오프칩 메모리(DRAM)에 접근할 때의 Bandwidth와 Latency입니다. 연산 능력은 세대를 거치며 계속 향상되지만, DRAM에 접근하는 속도는 그 속도를 따라가지 못합니다. 이 현상을 가리키는 용어가 Memory Wall이고, Wulf와 McKee의 1994년 기술 보고서(1995년 ACM 게재)에서 널리 알려졌습니다. 프로세서 설계의 과제는 “DRAM Bandwidth를 어떻게 최대한 활용할 것인가”가 됩니다.
Multithreading을 활용한 Memory Latency Hiding
이 Memory Wall을 풀어내는 방법으로 잘 알려진 것이 Multithreading입니다. 하나의 스레드가 메모리 접근으로 대기 중일 때 즉시 다른 스레드를 실행해, 메모리 접근의 긴 Latency를 다른 유용한 작업으로 채웁니다.
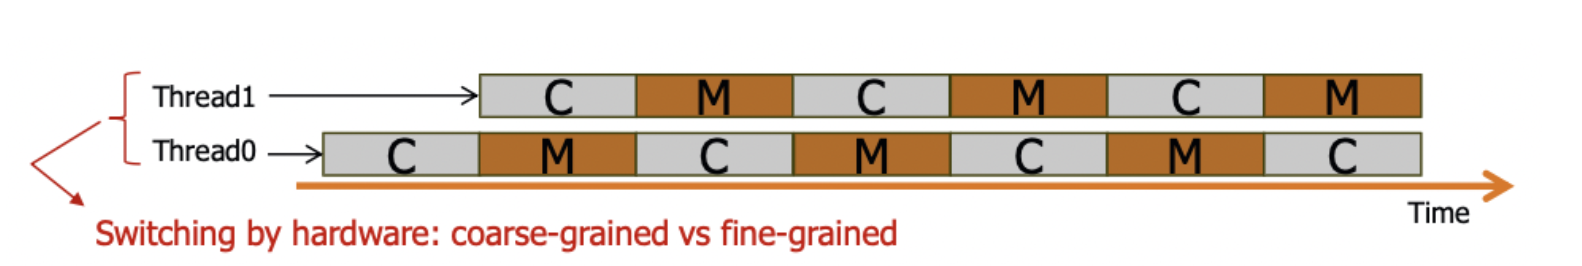
위 그림에서 C는 연산, M은 메모리 대기이고, 두 줄은 같은 core의 hardware thread 두 개입니다. 전환 단위는 cache miss 같은 긴 이벤트마다 바꾸는 coarse-grained와 매 cycle 바꾸는 fine-grained가 있습니다. 이 스케줄이 성립하려면 메모리 시스템이 여러 outstanding request를 동시에 처리할 수 있어야 하고, 프로그램이 스레드 형태로 병렬성을 명시해 두어야 합니다.
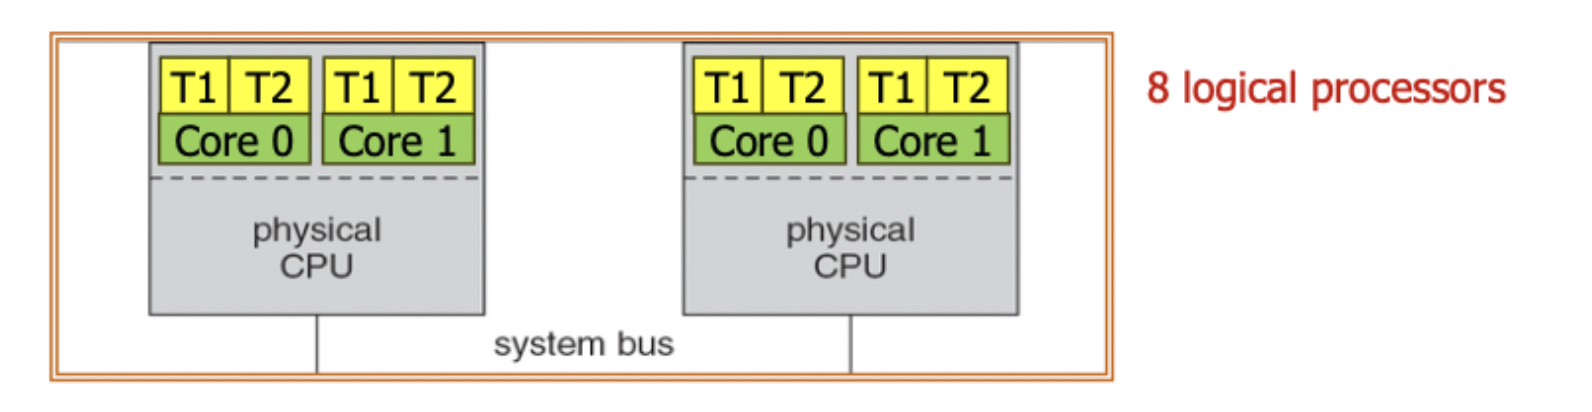
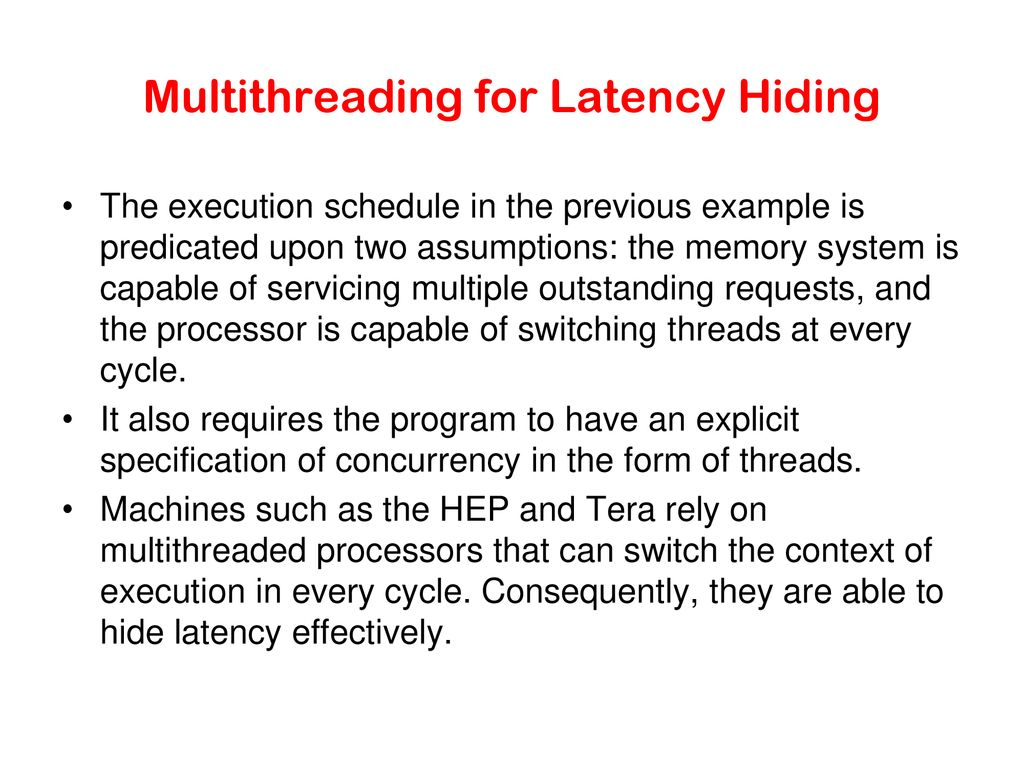
CPU에서는 이를 SMT(Simultaneous Multithreading, Intel의 Hyper-Threading)로 구현해 core당 2개 정도의 hardware thread를 둡니다(왼쪽, 8 logical processors). 1980~90년대의 HEP, Tera 같은 machine은 매 cycle context를 바꾸는 fine-grained multithreading으로 latency를 숨겼고(오른쪽), 다음 절의 GPU는 이 방향을 수십 개 warp 규모로 키운 것입니다.
GPU의 SIMT 실행과 Warp Scheduling
CPU가 Multi-Core로 전환하던 같은 시기인 2000년대에, 그래픽스 프로세서도 큰 변화를 겪고 있었습니다.
Fixed-Function에서 Programmable Device로
그래픽스 프로세서는 이 시기에 Fixed-Function hardware에서 Programmable Device로 바뀌었습니다.
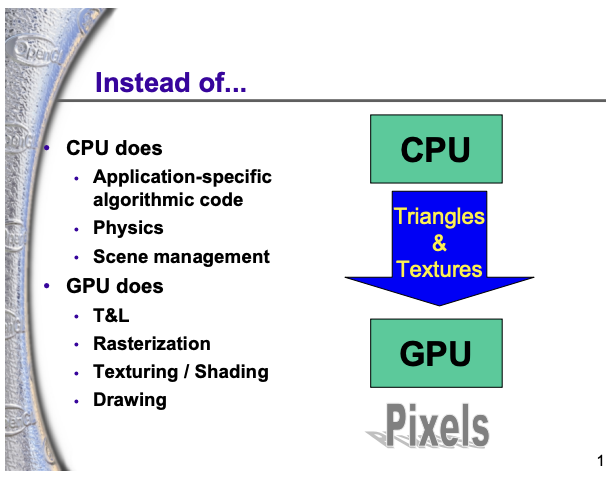
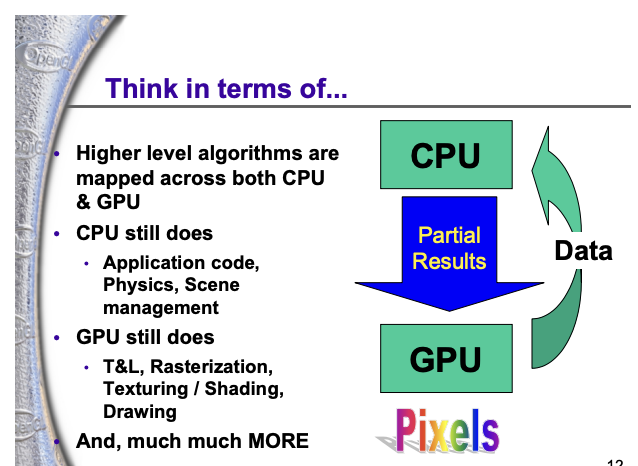
이 변화의 중심에는 Shader Programming의 등장이 있습니다. 이전 GPU는 미리 정해진 그래픽스 파이프라인 연산(정해진 종류의 변환·조명·텍스처링 등)만 처리할 수 있는 Fixed-Function 디바이스였지만, Shader가 도입되면서 개발자가 GPU의 동작을 일정 범위 안에서 직접 프로그래밍할 수 있게 되었습니다. Shader가 도입되면서 GPU는 정해진 연산만 하는 가속기에서, 개발자가 짠 코드를 대규모로 병렬 실행하는 프로세서가 되었습니다.
CPU vs GPU: 설계 철학의 차이
GPU가 노리고 있는 그래픽스 워크로드는 본질적으로 픽셀이나 삼각형(triangle) 단위의 엄청나게 많은(abundant / massive) 병렬성을 가지고 있습니다. GPU는 이 풍부한 병렬성을 그대로 활용하는 데 초점을 맞추는 방향으로 진화했고, 그 결과 CPU와는 매우 다른 설계 선택을 하게 됩니다.
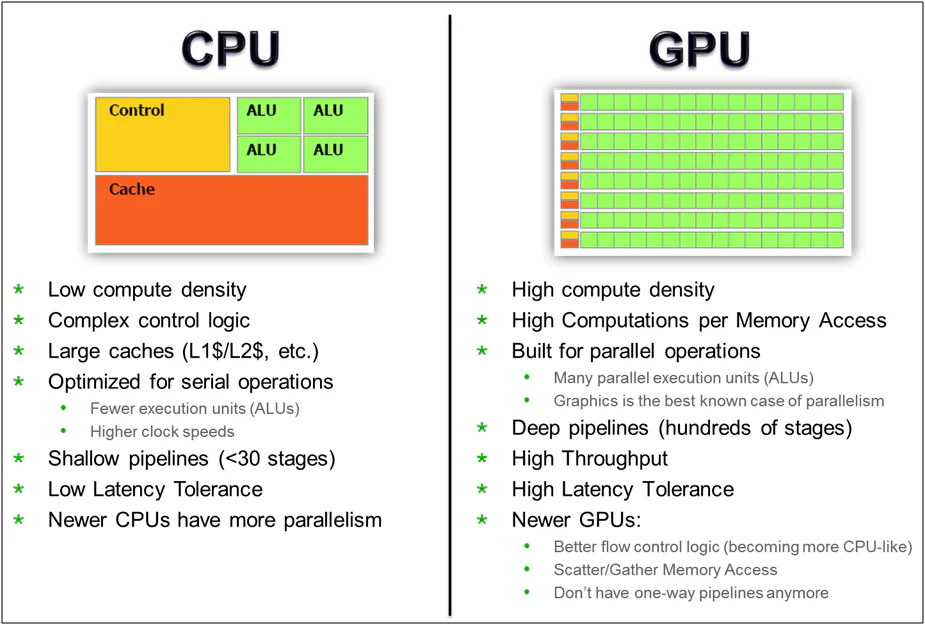
CPU와 비교해서 GPU의 특징을 정리하면 이렇습니다.
- Computing Density (연산 밀도) - Throughput 중심 GPU는 CPU보다 같은 면적/전력에서 더 많은 연산 유닛에 자원을 배분합니다.
- 동시 처리 가능한 스레드 수 - GPU가 CPU보다 압도적으로 많습니다. 한 GPU 안에서 수천~수만 개 스레드가 동시에 in-flight 상태로 존재합니다.
- Control 단순화 - CPU가 단일 스레드 성능을 끌어올리려고 OOO 엔진·Branch Predictor·Reorder Buffer 같은 부가 장치를 잔뜩 짊어진 반면, GPU는 그 장치들을 과감히 덜어냅니다. 한 스레드가 좀 오래 걸려도 상관없으니, 대신 여러 스레드를 한꺼번에 효율적으로 흘리는 데 최적화된 아키텍처를 선택한 것입니다.
CPU는 단일 스레드의 Latency를 줄이는 데, GPU는 Throughput을 높이는 데 자원을 씁니다. GPU는 메모리 Latency를 앞 절의 Multithreading으로 가립니다. 한 스레드가 메모리를 기다리는 동안 다른 스레드를 실행해 연산 유닛이 쉬는 시간을 줄입니다.
CUDA와 SIMT
CUDA는 Shader 시절부터 다듬어진 GPU의 아키텍처 개념을 프로그래밍 모델로 정리한 것입니다. NVIDIA가 2007년경 발표했고, 이후 GPU를 범용 연산(GPGPU)에 쓰는 일이 널리 퍼졌습니다.
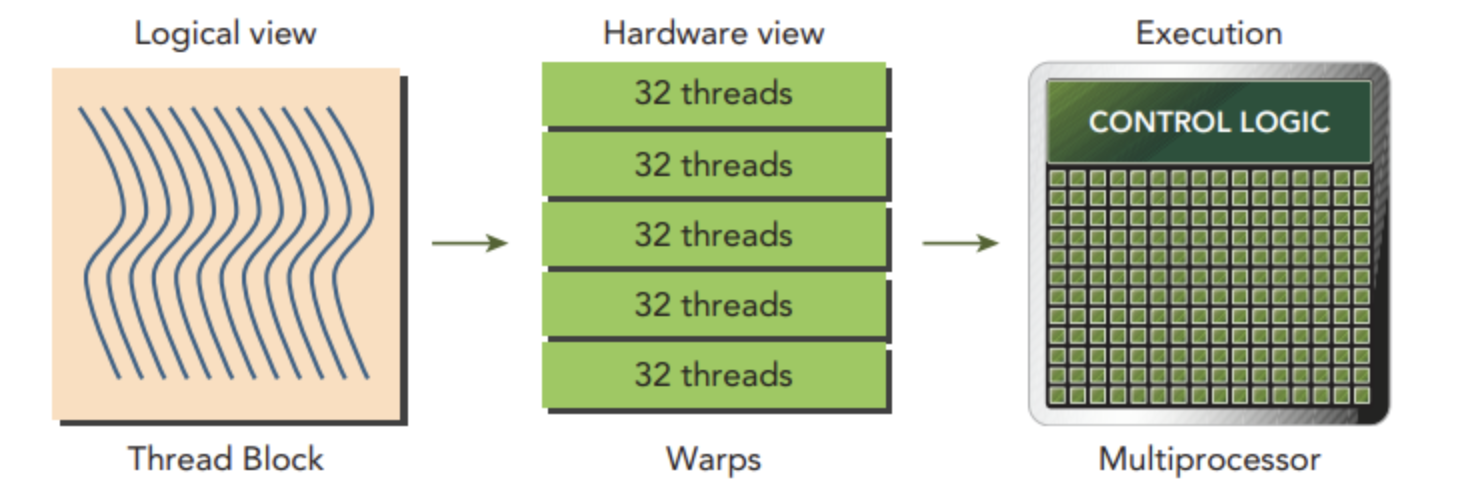
CUDA가 제시한 실행 모델이 SIMT (Single Instruction Multiple Threads) 입니다. 하드웨어가 같은 명령어를 여러 데이터에 적용한다는 점은 SIMD (Single Instruction Multiple Data)와 같지만, 프로그래밍 모델이 다릅니다. SIMD는 vector 폭을 소프트웨어에 그대로 노출하는 반면, SIMT에서는 프로그래머가 thread 하나의 코드와 분기를 쓰고, 각 thread가 자기 PC와 주소를 갖습니다. 하드웨어는 같은 명령어를 실행하는 thread들을 warp로 묶어 발행하고, thread마다 분기 결과가 다르면(divergence) mask로 일부를 끄면서 양쪽 경로를 차례로 실행합니다. 메모리 latency hiding은 SIMT의 정의가 아니라 다음의 warp scheduling이 맡습니다.
ThreadBlock, Warp, Multiprocessor
SIMT 모델의 기본 단위는 다음과 같습니다.
- Thread - 가장 작은 실행 단위. 프로그래머는 CUDA로 수많은 Thread를 SIMT 형태로 짭니다.
- Warp - 같은 명령어를 함께 실행하는 스레드 묶음(NVIDIA 구현에서는 보통 32개). Warp 단위로 하드웨어가 명령어를 발행합니다.
- ThreadBlock - Warp들을 묶은 그룹. 같은 ThreadBlock 안의 스레드들은 공유 메모리·동기화 같은 자원을 함께 쓸 수 있습니다.
- Streaming Multiprocessor (SM) - Warp들을 실제로 흘려 보내는 하드웨어 단위. 여러 ThreadBlock을 동시에 in-flight 상태로 들고 있으면서 매 cycle 실행할 Warp을 골라냅니다.
Latency Hiding 메커니즘
CUDA 프로그래머가 굉장히 많은 Thread를 작성해 두면, GPU는 이를 다음과 같이 굴립니다. 어떤 Thread/Warp이 실행되다가 Cache Miss나 메모리 접근 같은 긴 Latency 이벤트를 만나면, 그 Warp은 일시 중단되고 SM은 즉시 실행 가능한 다른 Warp으로 전환해 연산 유닛을 계속 가동합니다. 그러다가 처음 Warp이 기다리던 메모리 접근이 끝나면 그 Warp은 다시 후보 큐에 들어가 실행됩니다.
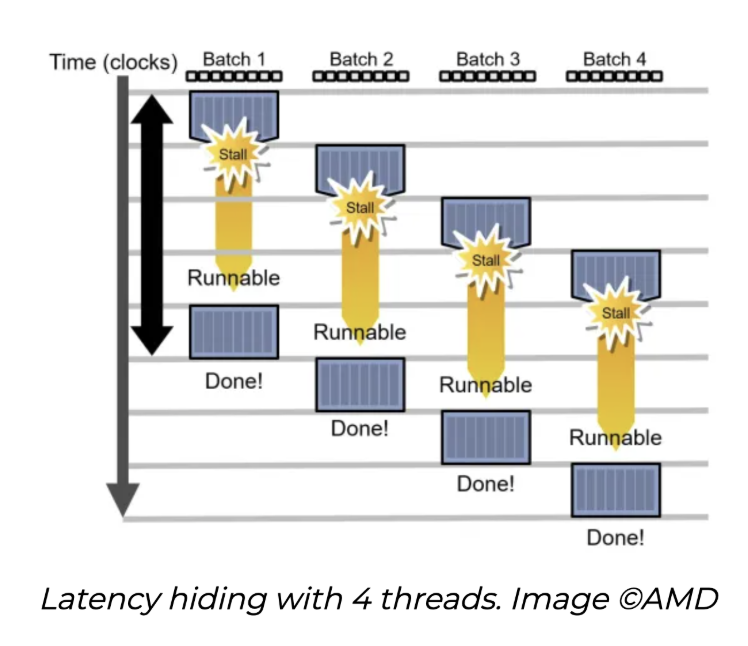
이 방식은 전환할 ready Warp이 충분히 많아야 동작합니다. GPU는 많은 Thread를 in-flight 상태로 두고, Warp scheduler가 issue 시점마다 실행 가능한 Warp을 골라 memory latency로 생기는 빈 cycle을 줄입니다.
Occupancy: Latency Hiding의 예산
Warp을 많이 올리려면 하드웨어 자원이 필요합니다. SM에 실제로 올라와 있는(resident) Warp 수를 SM이 지원하는 최대 Warp 수로 나눈 비율을 Occupancy라고 부르는데, 이 값은 하드웨어 자원에 의해 뚜렷하게 제한됩니다. H100 기준으로 한 SM은 최대 64개의 resident Warp을 스케줄링할 수 있지만, 그 Warp들이 나눠 써야 하는 Register File은 SM당 256KB(32-bit 레지스터 64K개)뿐입니다. 극단적으로 한 스레드가 상한(255개)까지 레지스터를 쓰면, 64K ÷ (32 threads × 256 registers) ≈ 8, 즉 SM에 Warp을 8개밖에 올리지 못하고 Occupancy는 8/64 = 12.5%가 됩니다(실제 값은 block 크기와 할당 단위까지 고려해 계산합니다). Shared Memory 역시 같은 SM에 올라온 ThreadBlock들이 나눠 쓰는 한정 자원입니다.
필요한 예산의 크기는 Little’s law로 가늠할 수 있습니다. 대역폭을 채우려면 (대역폭 × latency)만큼의 byte가 항상 in-flight여야 하는데, 예를 들어 HBM latency를 600ns로 잡으면 3.35TB/s × 600ns ≈ 2MB입니다. 이 in-flight 요청을 누군가 들고 있어야 하고, GPU에서는 그것이 resident Warp들입니다.
커널이 스레드당 레지스터나 Shared Memory를 많이 쓸수록 갈아 끼울 Warp 후보가 줄어들고, 메모리 Latency를 가려 줄 여력도 함께 줄어듭니다. 반대로 Warp을 많이 올리려고 스레드당 자원을 줄이면 이번에는 스레드 하나가 들고 있을 수 있는 데이터가 작아져 연산의 효율이 떨어집니다. CUDA kernel의 Occupancy tuning은 이 trade-off를 다루며, 뒤에서는 Occupancy가 낮은 GEMM kernel이 explicit pipeline으로 latency를 숨기는 방식을 설명합니다.
GPU: All About Hiding Latency
원래 강의의 표현대로 GPU는 “All About Hiding Latency” 로 요약할 수 있습니다. 그래픽스 workload의 풍부한 병렬성을 SIMT model로 노출하고, Warp scheduling과 많은 in-flight thread를 이용해 memory access로 생기는 대기 시간을 다른 Warp의 실행으로 채웁니다.
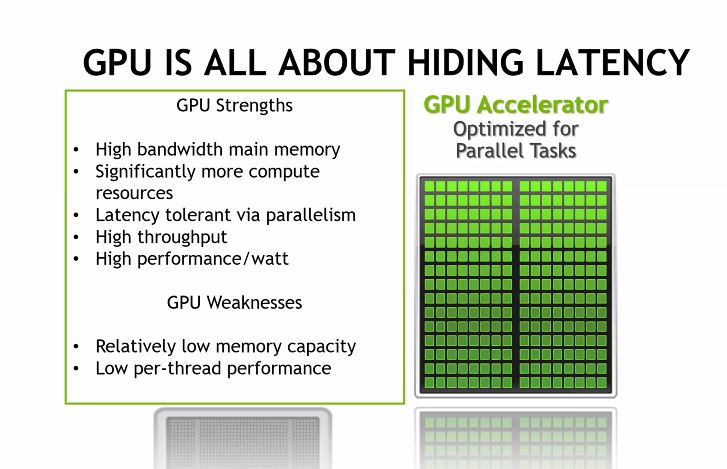
이 설명은 GPU의 기본 SIMT execution model을 정리한 것입니다. Hopper와 Blackwell의 고성능 GEMM kernel은 이 model을 유지하면서도 TMA, Warp Specialization과 software pipeline을 명시적으로 사용합니다. 강의 마지막 절에서 이 추가 메커니즘을 살펴봅니다.
다만 GPU가 처음 만들어졌을 때의 설계 철학(단일 스레드 Latency가 아니라 Throughput을 끌어올리고, 그 길의 핵심 도구로 Multithreading을 통한 Latency Hiding을 쓴다)은 지금까지도 그대로 유지되고 있다고 보면 됩니다. 이어지는 절들은 이 철학 위에서 NVIDIA GPU가 어떻게 성장했고, 또 어떤 한계에 부딪히고 있는지를 살펴봅니다.
NVIDIA GPU의 성장과 한계
GPU는 처음부터 머신러닝을 염두에 두고 설계된 것이 아닙니다. 그래픽스 워크로드의 픽셀·삼각형 단위 Massive Parallelism을 위해 만든 구조가 ML 워크로드에도 잘 맞았습니다.
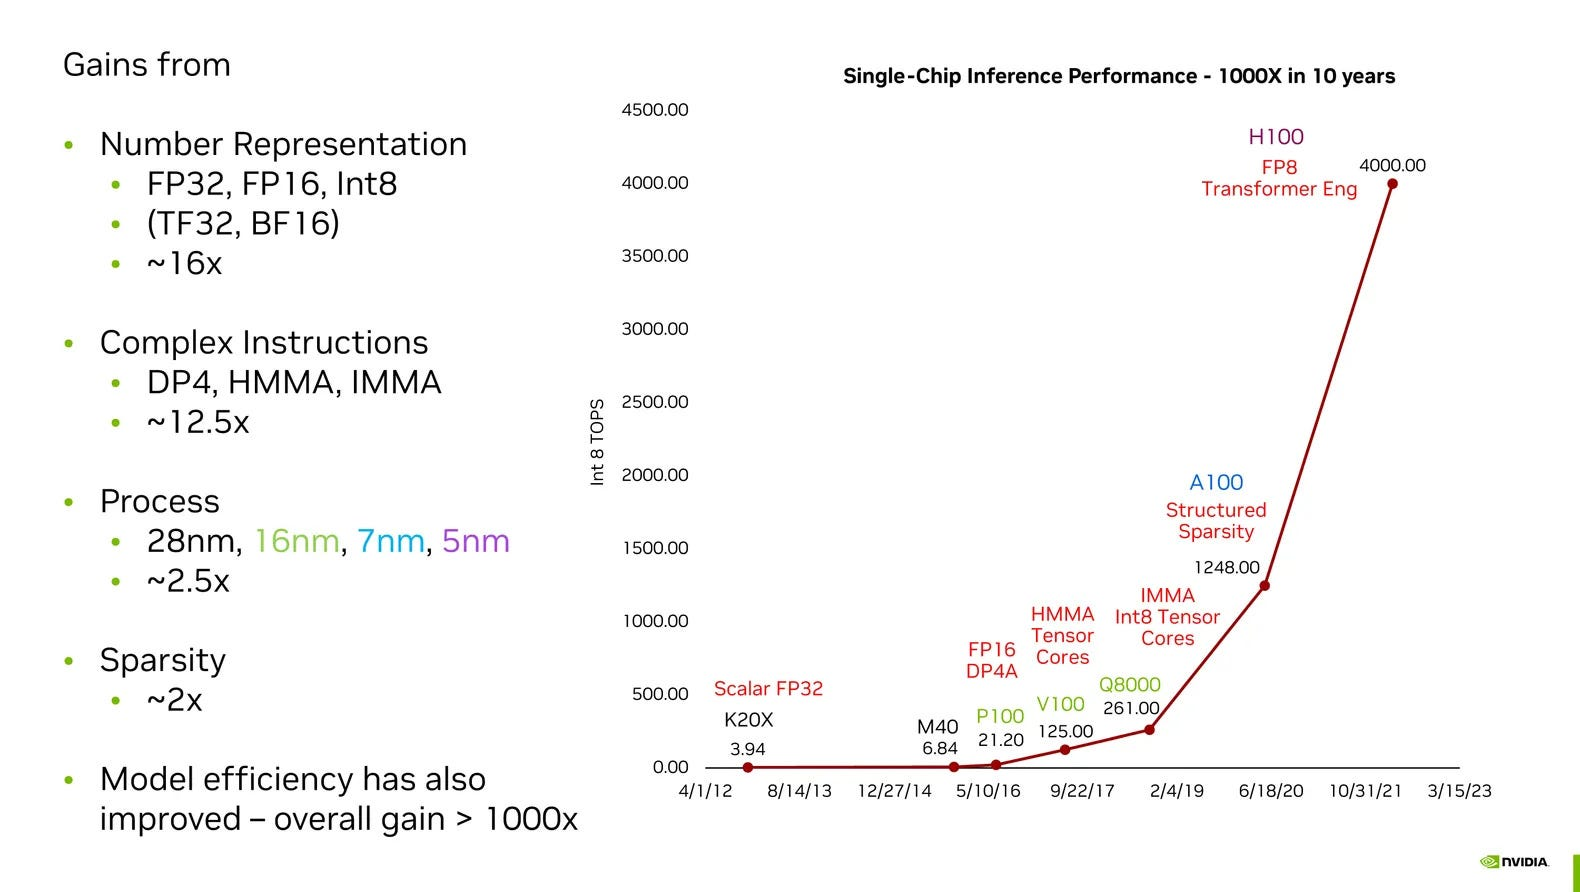
ML 수요가 커지면서 NVIDIA GPU의 연산 처리량도 세대마다 빠르게 올라갔습니다. 위 그림은 단일 칩 추론 성능(Int8 TOPS)이 10년간 1000배가 된 곡선인데, 같은 정밀도의 FLOPS 비교가 아니라 FP32에서 Int8/FP8로의 수치 표현 변화(16배), Tensor Core 명령(12.5배), 공정(2.5배), structured sparsity(2배)를 모두 합친 수치입니다.
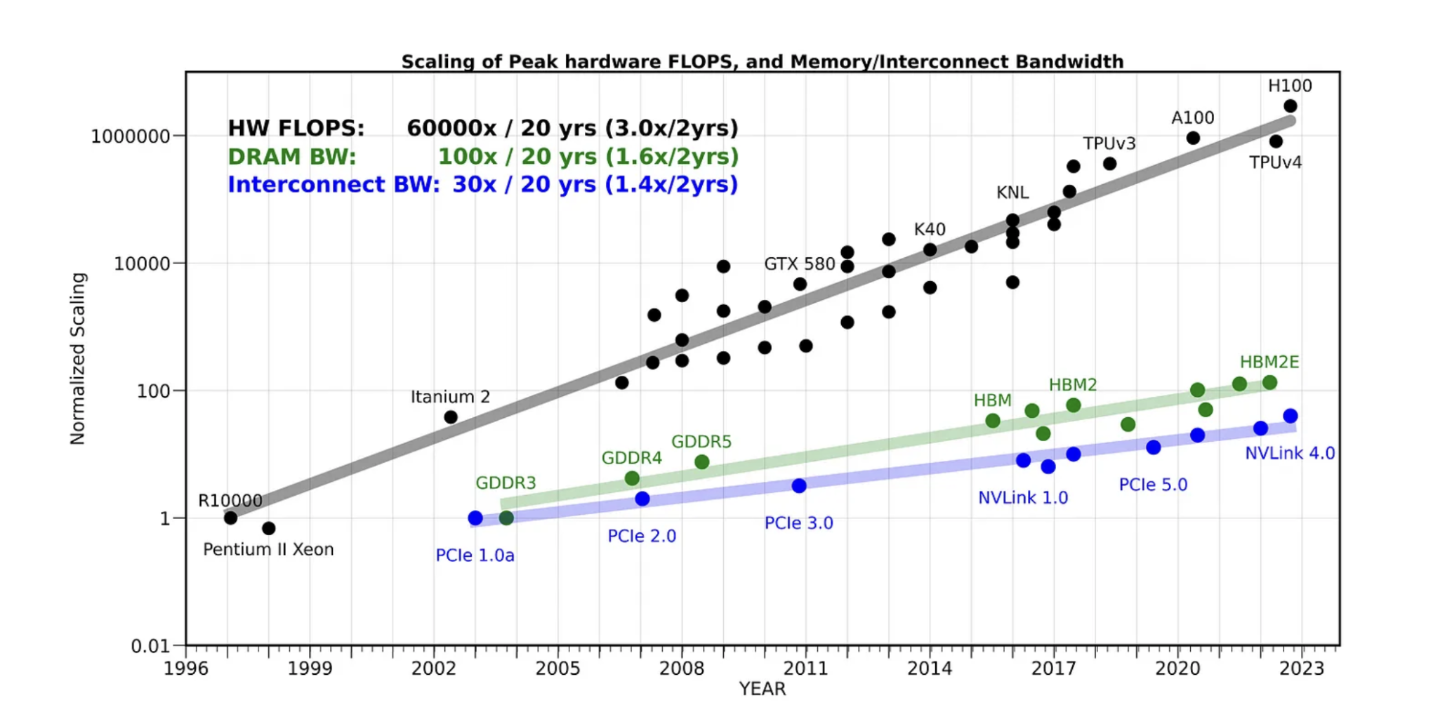
다만 컴퓨팅 성능이 올라가는 만큼 메모리 Bandwidth가 같은 속도로 따라오지는 못하고 있다는 점은 매우 중요한 한계입니다. 메모리 인터페이스 기술 자체도(HBM 세대 교체 등) 빠르게 발전하고는 있지만, NVIDIA가 컴퓨팅 밀도를 끌어올리는 속도를 따라잡지는 못하고 있고, 그 사이의 갭은 오히려 점점 더 벌어지는 추세입니다.
이 격차를 실제 수치로 확인해 보면 다음과 같습니다. H100 SXM의 메모리 계층을 위(빠르고 작음)에서 아래(느리고 큼)로 내려가며 정리한 표입니다.
| 계층 | 용량 | 비고 |
|---|---|---|
| Register File | 256KB / SM | 스레드들이 나눠 씀 (Occupancy의 상한) |
| Shared Memory (SMEM) | ~228KB / SM | L1과 통합, ThreadBlock 단위로 할당 |
| L2 Cache | ~50MB | 모든 SM이 공유. 대역폭은 NVIDIA 공식 수치가 없고 JAX scaling book의 실측치 약 5.5TB/s |
| HBM3 (GMEM) | 80GB | 3.35TB/s (SXM 기준. PCIe/NVL 구성은 다름) |
여기서 6주차에 다룬 Roofline Analysis를 적용할 수 있습니다. NVIDIA가 공개한 dense BF16 Tensor Core peak와 HBM peak bandwidth를 사용하면 H100 SXM은 약 990 TFLOPs/s ÷ 3.35 TB/s ≈ 295 FLOPs/byte, B200은 약 2.25 PFLOPs/s ÷ 8 TB/s ≈ 281 FLOPs/byte입니다. 실제 kernel의 attainable peak는 precision mode, sparsity 사용 여부, clock과 memory efficiency에 따라 달라지지만, 두 예 모두 높은 arithmetic intensity가 필요하다는 점을 보여줍니다.
Blackwell 세대에서도 compute throughput과 memory bandwidth가 함께 증가했지만, 고성능 kernel이 요구하는 arithmetic intensity는 여전히 높습니다. 따라서 다음 절에서는 Tensor Core에 data를 공급하기 위해 GPU kernel이 사용하는 명시적 data movement와 pipelining을 살펴봅니다.
GPU의 Multithreading Overhead
기본 CUDA execution model에서는 Warp scheduling과 in-flight thread 관리가 hardware에서 이루어집니다. Programmer는 grid와 ThreadBlock으로 병렬성을 표현하고, hardware는 resident Warp 중 실행 가능한 Warp를 선택합니다.
SIMT model로 충분한 병렬성을 표현하면, hardware가 Warp를 배치하고 scheduling한다.
이 방식이 ML 워크로드에 가장 맞는 선택인지에는 강사를 포함해 의문을 가진 사람이 많고, 학계에서도 논의되고 있습니다.
“(1) GPGPU’s multithreading overhead: It is not our intention to lessen GPGPUs’ huge contribution to ML’s recent success… Overhead or not, there were no alternatives, until other options came along”
출처: https://www.sigarch.org/why-the-gpgpu-is-less-efficient-than-the-tpu-for-dnns
최근 세대의 NVIDIA GPU는 위에서 본 원래 구조의 한계들을 여러 방식으로 보완·극복하고 있고, 그 내부가 모두 공개되지는 않기 때문에, “GPU의 일반적 방식이 ML에 잘 맞지 않는다”는 평가가 현재 칩에 그대로 적용되는지는 별개의 문제입니다.
Multithreading 기반 Latency Hiding을 SIMT라는 단순한 프로그래밍 모델 뒤에 숨긴 NVIDIA의 선택이 ML에 최적이었는지는 아직 답이 없습니다. 같은 Latency Hiding을 소프트웨어가 주도하는 NPU가 이 의문에서 나왔습니다.
NPU의 정적 실행 계획과 명시적 데이터 이동
CPU 절에서는 OOO processor가 runtime에 instruction을 동적으로 schedule하고, VLIW processor는 compiler가 여러 operation의 schedule을 미리 구성하는 방식을 비교했습니다. 다음에서는 이 scheduling 책임의 차이를 GPU와 compiler-scheduled AI accelerator의 실행 model을 설명하는 데 사용합니다.
GPU vs NPU: 핵심 대비
이 분기를 한 장의 표로 보면 다음과 같습니다.
HW가 동적으로 Data-Flow Graph 생성
HW가 동적으로 Warp 스케줄링·Latency Hiding
컴파일러가 정적으로 Loop Pipeline 결정
컴파일러가 정적으로 전체 실행 계획 생성
비례식으로 줄이면 원래 강의의 OOO : VLIW = GPU : NPU입니다. 이는 scheduling 책임이 hardware와 software 중 어디에 놓이는지를 비교하는 교육적 비유입니다. GPU와 NPU의 전체 architecture가 각각 OOO와 VLIW에 일대일로 대응한다는 뜻은 아닙니다. GPU는 Warp를 hardware가 동적으로 schedule하는 반면, 이 절에서 다루는 NPU 유형은 compiler가 data movement와 compute 순서를 정적으로 계획합니다.
이 절에서 다루는 NPU 유형의 특징
NPU라는 이름으로 묶인 chip의 구조는 vendor마다 다릅니다. 이 강의에서는 scratchpad memory와 DMA를 compiler에 노출하고, compute와 data movement schedule을 정적으로 생성하는 accelerator를 대표 사례로 다룹니다.
Google TPU는 이 비교에 사용할 수 있는 한 사례입니다. TPU generation마다 memory hierarchy와 execution 기능은 다르지만, XLA compiler가 matrix unit의 연산과 on-chip memory 사이 data movement를 계획한다는 점에서 이 절의 scratchpad·DMA·정적 schedule model과 연결됩니다.
NPU Architecture: Scratchpad Memory와 DMA
전반적인 그림 자체는 사실 GPU나 NPU나 크게 다르지 않습니다. 위쪽에 연산을 담당하는 Compute Unit들이 있고, 그 사이를 잇는 Interconnect가 있고, 빠른 온칩 메모리가 있고, 비용이 큰 오프칩 경계를 넘어 DRAM이 있는, 앞 절의 Memory Wall 그림과 같은 형태입니다.
차이는 두 가지입니다.
- 온칩 메모리가 Cache가 아니라 Scratchpad - 일반 CPU/GPU에서는 하드웨어가 자동으로 데이터를 캐시 라인 단위로 관리하지만, NPU에서는 어떤 데이터를 어디에 둘지를 소프트웨어가 직접 결정하는 Scratchpad 형태로 노출됩니다.
- Scratchpad에 값을 넣고 빼는 전송이 DMA로 명시 프로그래밍 - 위 그림 좌측의 L1 DMA / L2 DMA stack 이 그것입니다. 이 DMA4 들이 하드웨어 디테일로 숨겨져 있는 것이 아니라, 소프트웨어가 어느 DMA로 어떤 영역을 언제 옮길지 명령으로 직접 적어 주는 구조입니다. 연산 유닛이 자기 로컬 버퍼를 읽는 것까지 전부 DMA인 것은 아니고, DRAM↔on-chip 사이의 큰 전송이 대상입니다.
NPU에서는 Compute Unit뿐 아니라 DMA도 소프트웨어가 따로 프로그래밍하는 병렬 유닛입니다. 소프트웨어가 유닛마다 누가 언제 무엇을 할지 순서표로 적어 두면, 하드웨어는 그 순서대로 실행합니다. 다만 매 cycle을 완전히 확정하는 것은 아니고, DMA처럼 비동기로 끝나는 작업은 완료 신호(signal/wait)로 의존성을 맞춥니다. GPU에서는 하드웨어가 자동으로 캐시를 관리하고 스레드 스케줄링까지 동적으로 처리해 주던 일을, NPU에서는 모두 컴파일러(혹은 프로그래머)가 정적으로 계획하는 것입니다.
Horizontal Encoding과 Command Stream
명령어 관점에서 보면 NPU는 유닛들이 옆으로 늘어서 있고, 명령어가 각 유닛의 동작을 따로 지정하는 구조입니다.


이런 command stream은 여러 functional unit의 동작을 software가 함께 schedule한다는 점에서 앞 절의 Horizontal Encoding과 유사합니다. 다만 모든 NPU ISA가 VLIW이거나 reconfigurable architecture인 것은 아니므로, 여기서는 scheduling 방식의 유사성만 비교합니다.
이 구조에서 Command Processor가 소프트웨어가 미리 만들어 놓은 실행 계획을 받아 각 하드웨어 유닛에 분배하고, Sync Network를 통해 서브태스크 간 순서 관계를 유지합니다. 그래서 NPU에서 “프로그래밍한다”는 것은 곧 이 Command Stream을 어떻게 짤 것인가의 문제가 됩니다.
NPU Compiler의 역할


ML 모델은 일반적으로 노드 단위의 그래프 형태로 컴파일러에 들어옵니다. 그런데 그래프의 한 노드(예: 큰 matmul, attention 한 블록)가 곧바로 한 cycle에 끝낼 수 있는 작업인 경우는 거의 없고, 하드웨어가 한 번에 처리할 수 있는 작은 단위로 더 잘게 쪼개야 합니다.
이 쪼개기와 그 후의 결정들이 모두 NPU 컴파일러의 몫입니다.
- 그래프 노드 → 하드웨어가 처리 가능한 작은 sub-task로 분할
- 각 sub-task가 어떤 Compute Unit / DMA / Scratchpad 영역에서 수행될지 결정
- sub-task들 사이의 순서 관계와 동기화 결정
- 최종적으로 각 유닛에 보낼 Command Stream을 생성
이 결정을 내리려면 컴파일러가 아키텍처의 디테일을 알아야 합니다. NPU 하드웨어는 컴파일러가 만든 계획대로 실행하고, 비동기 작업의 완료는 signal/wait로 맞춥니다.
| GPU | NPU | |
|---|---|---|
| 작업 분할 | SW가 thread·block 단위로 정의 | SW(컴파일러)가 compute·DMA 단위로 정의 |
| 배치·스케줄링 | HW가 block을 SM에 배치하고 Warp를 스케줄링 | 컴파일러가 배치와 순서까지 실행 계획으로 생성 |
| HW 스케줄링 복잡도 | 상대적으로 높음 | 상대적으로 낮음 |
| 추상화 수준 | 높음 (Thread·Block 중심) | 낮음 (HW 디테일 노출) |
이 표는 이 절에서 비교하는 대표적인 실행 model을 단순화한 것입니다. 기본 CUDA model에서 programmer는 thread의 작업과 launch shape을 정의하고, hardware가 resident Warp의 실행 순서를 정합니다. GPU에서도 Shared Memory와 asynchronous copy를 명시적으로 사용할 수 있으며, 뒤의 Hopper·Blackwell 절에서 그 사례를 다룹니다. 이 절의 NPU model에서는 compiler가 task placement, DMA와 synchronization까지 더 많이 결정합니다. 그만큼 runtime scheduling hardware를 줄일 수 있지만 compiler가 target memory와 execution resource를 구체적으로 model해야 합니다.
Hopper·Blackwell GEMM Kernel의 명시적 Pipelining
앞 절에서는 GPU가 많은 Warp를 바꿔 실행하며 latency를 숨기는 방식을 설명했습니다. Hopper와 Blackwell의 고성능 GEMM kernel은 여기에 TMA를 이용한 명시적 data movement와 Warp별 역할 분담을 추가해 load·MMA·epilogue를 overlap합니다. Scratchpad, DMA와 정적 pipeline을 사용한다는 점에서는 앞서 본 NPU 방식과 유사합니다.
왜 고전적 Latency Hiding만으로는 부족해졌는가
먼저 용어를 정리합니다. tile은 출력 행렬 C를 잘라 한 ThreadBlock이 맡는 조각(예: 128×256)이고, 그 tile을 만들려면 A의 행 띠와 B의 열 띠를 K 방향으로 잘게(K-step) 나눠 차례로 곱해 누적합니다. MMA(Matrix Multiply-Accumulate)는 Tensor Core가 한 번에 처리하는 작은 행렬곱 명령이고, warp-group은 Hopper에서 MMA 명령을 함께 발행하는 warp 4개(128 thread) 묶음입니다. epilogue는 누적이 끝난 tile을 output layout에 맞게 정렬하고 scaling·bias·activation 같은 elementwise 연산을 적용한 뒤 GMEM에 저장하는 마지막 단계입니다.
출발점은 Tensor Core입니다. 지원하는 행렬 연산에서는 Tensor Core의 처리량이 일반 CUDA core보다 훨씬 높아서, 이 처리량을 꽉 채우려면 매 cycle 대량의 tile 데이터를 SMEM과 Register에 공급해 줘야 합니다. 여기서 Occupancy 절의 trade-off가 문제가 됩니다. Arithmetic intensity를 높이려면 output tile을 키워야 하고, tile을 키우면 스레드당 레지스터·SMEM 사용량이 급증해 SM에 올릴 수 있는 Warp 수가 뚝 떨어집니다. 전환할 Warp이 몇 개 남지 않으면, 다른 Warp으로 전환해 숨기는 HW 주도 Latency Hiding이 성립하지 않습니다.
대형 matmul에서는 GPU의 전통적인 latency-hiding 방식인 높은 Occupancy만으로는 부족합니다. NVIDIA는 Hopper 이후 data movement를 TMA로 명시하고, Warp별 역할과 pipeline을 software에서 정하는 기능을 강화했습니다. 이는 앞서 NPU의 특징으로 설명한 DMA·Scratchpad·정적 scheduling과 같은 접근입니다.
Hopper의 TMA, Warp Specialization, SW Pipeline
Hopper 세대의 GEMM kernel에서는 다음 기능을 조합합니다.
- TMA (Tensor Memory Accelerator) - GMEM ↔ SMEM 사이의 multi-dimensional bulk copy를 수행하는 asynchronous data movement mechanism입니다. DMA와 기능적으로 유사하지만 NVIDIA GPU의 memory model과 Tensor Map descriptor에 맞게 정의된 기능입니다.
- 프로그래머가 직접 관리하는 SMEM - Matmul kernel은 여러 buffer slot을 circular queue로 구성하고 각 input tile의 위치와 lifetime을 직접 관리합니다. 이 용도에서는 SMEM이 software-managed scratchpad 역할을 합니다.
- Warp Specialization - Warp 또는 warp-group에 load, MMA, epilogue 같은 역할을 나누고 barrier로 연결합니다. 역할과 pipeline stage는 kernel schedule에 정적으로 정해지지만, 실행 가능한 Warp를 고르는 기본 hardware Warp scheduling은 그대로 사용됩니다.
Blackwell의 TMEM과 tcgen05
Blackwell(B200)에서도 TMA pipeline, warp specialization, mbarrier 동기화는 여전히 소프트웨어(CUTLASS)가 짭니다. 바뀐 것은 그 구조의 비용을 줄이는 하드웨어 자원 두 가지입니다.
첫째, TMEM (Tensor Memory) 이라는 새로운 on-chip memory가 추가되었습니다. 128개 lane × 최대 512 column, cell당 32-bit인 2차원 memory로, MMA accumulator를 register file 대신 저장할 수 있습니다. Kernel은 tcgen05.alloc과 tcgen05.dealloc으로 TMEM column을 명시적으로 관리하고 tcgen05.ld/st로 register와 값을 주고받습니다. TMEM에 accumulator를 두면 큰 output tile이 차지하던 register pressure를 줄일 수 있습니다.
둘째, 5세대 Tensor Core instruction인 tcgen05.mma 는 wgmma와 달리 single-thread issue semantics를 사용합니다. Kernel code를 실행하는 thread 하나가 TMEM address와 input descriptor를 operand로 tcgen05.mma를 발행하면 Tensor Core가 해당 tile의 asynchronous MMA를 시작하고 결과를 TMEM에 누적합니다. Warp-specialized kernel에서는 보통 MMA 역할을 맡은 Warp의 한 thread를 선출해 이 instruction을 발행합니다. 앞선 MMA의 완료가 필요할 때 같은 thread가 tcgen05.commit을 발행해 mbarrier5가 그 operation들을 추적하게 하고, consumer thread는 barrier를 기다린 뒤 결과를 읽습니다. 즉 명령의 발행 주체는 Tensor Core 자신이 아니라 kernel을 실행하는 thread이며, Tensor Core와 TMA가 서로 대칭인 독립 engine이라고 단정할 필요도 없습니다. cta_group::2는 CTA6 pair가 하나의 MMA operation에 함께 참여하도록 지정합니다.
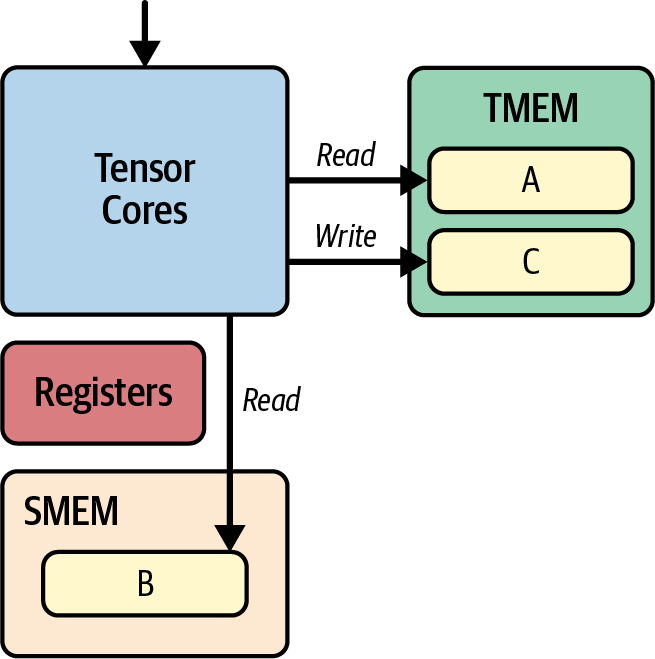
위 그림은 한 tcgen05.mma 형태의 data path를 보여줍니다. Operand descriptor는 register로 전달되지만, matrix tile과 accumulator의 주요 data path는 TMEM·SMEM을 사용하므로 accumulator 전체를 각 thread의 register에 보관하지 않아도 됩니다.
그림 출처: AI Performance Engineering — cfregly (Apache License 2.0)
GEMM kernel의 mainloop는 A·B tile을 반복해서 load하고 matrix product를 accumulator에 누적하며, 앞서 정의한 epilogue가 그 뒤를 잇습니다. 일부 CUTLASS warp-specialized schedule은 epilogue를 전담하는 Warp를 두어, 한 tile의 epilogue와 다음 tile의 mainloop를 overlap합니다.
아래 그림은 이러한 Blackwell GEMM pipeline의 한 예입니다. 그림의 k는 출력 tile 번호입니다. TMA가 tile k+1의 입력을 GMEM에서 SMEM으로 옮기는 동안 tcgen05.mma로 tile k를 TMEM에 누적하고, epilogue 담당 Warp는 누적이 끝난 tile k-1의 결과를 TMEM에서 읽어 output operation과 GMEM store를 수행합니다. 한 출력 tile 안에서는 K-step j+1의 load와 j의 MMA가 겹치는 안쪽 pipeline이 따로 있는데, 그림은 이를 tile 하나의 막대로 뭉뚱그린 바깥 pipeline만 보여 줍니다. 정확한 Warp 역할과 overlap 방식은 CUTLASS schedule과 kernel 구성에 따라 달라집니다.
이 pipeline에서 mainloop 담당 Warp는 TMA·MMA instruction 발행, buffer slot 관리와 mbarrier synchronization을 수행하고, epilogue 담당 Warp는 output 변환과 store를 수행합니다. 역할 분담과 software pipeline이 명시적이어도 kernel은 여전히 CUDA의 CTA·Warp 실행 model과 hardware Warp scheduling 위에서 동작합니다.
Blackwell의 전체 구조는 Modern GPU Programming for MLSys의 tcgen05.mma·TMEM 챕터를 참고했습니다.
tcgen05의 발행·완료 semantics는 NVIDIA PTX ISA, GEMM epilogue의 정의는 CUTLASS Efficient GEMM을 참고했습니다.
숫자로 보는 효과: H100 matmul 워크로그
이 전환이 성능에서 얼마나 큰지는 Pranjal Shankhdhar의 H100 bf16 matmul 커널 최적화 워크로그(Aleksa Gordić의 해설 글에서 재정리)가 잘 보여줍니다. 각 단계가 어떤 Latency를 숨겨서 얼마를 얻었는지를 따라가 보면 됩니다.
| 단계 | 핵심 아이디어 | TFLOP/s |
|---|---|---|
| Warp-tiling baseline | CUDA core만 사용한 고전적 tiling | 32 |
| Tensor Core + TMA | 연산은 TC로, 로드는 비동기 DMA로 | 317 |
| Output tile 확대 | Arithmetic intensity 증가 | 423 |
| SW Pipelining | Producer/Consumer로 로드와 연산을 중첩 | 498 |
| Tile 128×256 + Consumer 2개 | 더 큰 tile을 warp-group 2개가 분담 | 610 |
| Persistent kernel7 | Store latency를 다음 tile 연산으로 숨김 | 660 |
| PTX barrier 최적화 | 동기화 비용 절감 | 704 |
| Cluster + TMA multicast8 | SM 간 중복 로드 제거 | 734 |
| 마이크로 최적화 | 747 | |
| TMA async store | Store도 비동기로 | 758 |
| Hilbert curve9 스케줄링 | L2 locality 개선 | 764 |
이 수치는 해당 H100 BF16 matmul shape과 benchmark 환경에서 측정한 결과입니다. 최종 kernel은 같은 환경의 cuBLAS 대비 약 107% 성능을 기록했습니다. 단계별 결과를 보면 Warp 수를 늘리기보다 TMA, 큰 tile, software pipeline과 locality 개선으로 data movement와 연산을 overlap해 성능을 높였습니다. 다른 matrix shape과 dtype에서는 결과가 달라질 수 있습니다.
출처: Outperforming cuBLAS on H100: a Worklog — Pranjal Shankhdhar, Inside NVIDIA GPUs: Anatomy of high performance matmul kernels — Aleksa Gordić, Modern GPU Programming for MLSys — GPU Execution Model
GPU Kernel에 도입된 SW 주도 Pipelining
NVIDIA GPU는 dynamic Warp scheduling을 유지하지만, Hopper·Blackwell의 고성능 GEMM kernel은 TMA를 DMA처럼 사용하고 SMEM을 Scratchpad로 직접 관리하며 Warp별 역할을 정적으로 나눕니다. 이 범위에서는 GPU kernel 최적화도 앞서 NPU의 특징으로 설명한 명시적 data movement와 SW 주도 pipeline을 채택했습니다. 다만 CUDA의 SIMT execution과 hardware Warp scheduling은 그대로이므로 GPU와 NPU의 전체 execution model이 같아졌다는 뜻은 아닙니다.
정리
이번 강의에서 다룬 내용을 정리하면 다음과 같습니다.
현대 프로세서의 가장 큰 성능 병목은 오프칩 메모리(DRAM) 접근의 Bandwidth/Latency, 즉 Memory Wall입니다. 따라서 메모리 Latency를 숨겨 outstanding request를 충분히 유지하고, 그래서 메모리 Bandwidth를 포화시키는 것(Little’s law: 유지해야 하는 in-flight byte 수 = bandwidth × latency)이 모든 현대 프로세서 설계의 공통 과제가 됩니다.
2000년대에는 power와 frequency scaling의 한계로 CPU 성능 향상의 중심이 더 높은 clock과 ILP만을 추구하는 방식에서 multi-core와 multithreading을 함께 사용하는 방향으로 이동했습니다. Pentium 4는 이 전환기의 대표 사례입니다.
GPU는 그래픽스 workload의 많은 병렬 작업을 SIMT Thread로 표현하고, hardware가 ready Warp를 선택해 memory latency를 숨깁니다. 단일 thread latency보다 전체 throughput에 초점을 둔 이 구조는 병렬성이 큰 ML workload에도 효과적으로 사용되었습니다.
이 강의의 OOO : VLIW = GPU : NPU 비유는 scheduling 책임을 비교합니다. GPU hardware는 runtime에 Warp를 선택하고, 이 절에서 다룬 NPU compiler는 compute와 data movement 순서를 실행 전에 계획합니다. Hopper·Blackwell의 고성능 GEMM kernel도 NPU에서 사용하던 명시적 data movement와 SW 주도 pipeline을 도입했습니다. CUDA의 SIMT execution과 dynamic Warp scheduling은 유지되므로, 이 비유는 scheduling 관점에 한정해 사용해야 합니다.
Footnotes
-
1967년 IBM System/360 Model 91의 부동소수점 유닛을 위해 Robert Tomasulo가 고안한 동적 스케줄링 알고리즘. Reservation Station과 Register Renaming이라는 아이디어가 모두 여기서 출발했습니다. ↩
-
분기 대신 각 명령어에 조건(predicate)을 붙여 두고, 조건이 거짓이면 그 명령어의 결과를 버리는 기법. Control flow를 data flow로 바꿔 분기 없는 직선 코드를 만들어 주므로 SW Pipelining을 적용하기 쉬워집니다. ↩
-
연산 유닛(PE)들을 2차원 격자로 배열하고, 데이터가 심장 박동(systole)처럼 매 cycle 이웃 유닛으로 흘러가며 부분 결과가 누적되는 구조. 행렬곱에 특화된 형태로, TPU의 MXU가 대표적인 구현입니다. ↩
-
Direct Memory Access. 연산 유닛을 거치지 않고 메모리 영역 사이의 데이터 전송을 전담하는 엔진. CPU/GPU에서는 대부분 하드웨어와 드라이버 뒤에 숨겨져 있지만, NPU에서는 소프트웨어가 직접 명령을 발행하는 1급 프로그래밍 대상입니다. ↩
-
Shared Memory에 놓이는 asynchronous barrier object.
tcgen05.mma뒤에tcgen05.commit...mbarrier::arrive를 발행하면 그 thread가 앞서 시작한tcgen05operation의 완료를 mbarrier가 추적하고, 다른 thread가 해당 phase를 기다릴 수 있습니다. ↩ -
Cooperative Thread Array. CUDA의 ThreadBlock을 하드웨어(PTX) 수준에서 부르는 이름입니다. ↩
-
tile마다 ThreadBlock을 새로 띄우는 대신, SM 수만큼의 ThreadBlock을 한 번 띄워 두고 각 block이 tile을 여러 개 연달아 처리하는 kernel. block 사이의 launch 공백이 없어져 한 tile의 store를 다음 tile의 연산과 겹칠 수 있습니다. ↩
-
Hopper의 thread block cluster는 인접 SM 몇 개를 묶어 서로의 SMEM에 접근하게 하는 단위이고, TMA multicast는 같은 A 또는 B tile을 cluster 안 여러 SM의 SMEM에 한 번의 GMEM 읽기로 복사하는 기능입니다. ↩
-
출력 tile을 행 우선으로 처리하는 대신 공간을 채우는 Hilbert 곡선 순서로 처리해, 동시에 도는 ThreadBlock들이 같은 A 행 띠·B 열 띠를 재사용하게 만들어 L2 hit rate를 높이는 스케줄링. ↩