Week 6: Beyond PyTorch: Custom Kernel과 vLLM
PyTorch + NPU 온라인 모임 #6 | 2025-02-05
강의는 2025-02-05에 진행되었고, 본 자료는 2026-09 기준으로 FlashAttention-4, vLLM Model Runner V2, DSpark 등 이후 자료를 보강했습니다. 버전이 붙은 수치는 각 출처의 시점 기준입니다.
소개
이번 강의에서는 PyTorch를 넘어서(Beyond PyTorch) LLM 추론에 필요한 기술들을 다룹니다.
오늘의 질문
이번 강의는 “Beyond PyTorch”라는 제목 그대로, PyTorch 외에 무엇을 더 준비해야 하는지를 다룹니다. 특히 리벨리온을 비롯해 이번 강의에 참여하고 계신 다른 AI 반도체 회사들 관점에서, 그리고 그중에서도 추론(inference)에 특화된 AI 반도체 관점에서, 개발 환경으로 PyTorch만 지원하면 충분한가, 아니면 무엇을 더 갖춰야 하는가를 함께 고민해 보려고 합니다.
성능이 가장 중요한 이슈라고 본다면, 자연스럽게 다음 세 가지 질문이 따라옵니다.
- 성능 측면에서 LLM 추론의 가장 큰 문제는 무엇인가?
- 그 문제들을 어떻게 해결할 수 있는가?
- 그 해결책을 개발자가 잘 구현하기 위해 PyTorch만으로 충분한가, 아니면 보조적인 다른 개발 환경이 필요한가?
결론부터 말하면, LLM 추론 관점에서 PyTorch는 전체 큰 그림의 (매우 중요한) 일부입니다. 전체 생태계의 구심점은 분명히 PyTorch이지만, PyTorch만 가지고 모든 게 되지는 않습니다. 우리가 잘 활용하고 있는 Llama, DeepSeek 같은 공개 Pretrained LLM, 그리고 이들이 배포되는 Hugging Face 중심의 배포 기술 모두가 큰 그림 안에서 굉장히 중요한 환경 중 하나입니다.
성능에 초점을 맞춰 보면 더 분명해집니다. PyTorch만으로는 해결되지 않는 영역이 분명히 존재하고, 이를 메우려면 커널 프로그래밍(병렬 프로그래밍)과 더 상위 레이어인 서빙 최적화까지 함께 갖춰져 있어야 합니다. 이 모든 것이 갖춰져야 비로소 개발자들이 LLM 추론에서 제대로 된 성능을 낼 수 있고, 따라서 AI 반도체 회사 입장에서도 PyTorch 외의 환경을 함께 잘 준비해야 합니다. 오늘 아젠다는 이 관점에서 정리한 것입니다.
▼ 오늘의 초점
Open Pretrained LLM
LLM 배포
ML Framework
Kernel Programming
서빙 최적화
오늘 다룰 주제들
위의 세 가지 질문을 그대로 따라, 문제 진단 → 해결 기법 → 커널 프로그래밍 → 서빙 프레임워크 순으로 나아갑니다.
- LLM inference의 성능 문제 - Decode가 memory wall에 부딪히는 이유
- Prefill vs. Decode: 계산 구조와 병렬성의 비대칭
- KV cache: 한 번 계산한 K·V를 저장해 재계산을 없애고, 대신 메모리와 읽기 트래픽이 새 병목이 됨
- Roofline analysis: Decode는 매 스텝 같은 weight를 읽지만 연산량이 적어 arithmetic intensity가 낮음 → memory bandwidth bound
- PD Disaggregation: Prefill과 Decode를 서로 다른 머신 풀에서 실행
- Memory overhead를 줄이기 위한 기술들
- Continuous batching: 여러 request를 동적으로 묶어 lock-step의 낭비 제거
- Speculative decoding: 생성을 검증 문제로 바꿔 순차적인 decode를 병렬처럼 처리
- Flash Attention과 Paged Attention: 각각 attention 연산과 KV cache 메모리 할당을 개선
- Kernel programming - 고성능 fused kernel을 직접 구현할 때 필요한 더 낮은 수준의 제어
- 개별 PyTorch op을 조합하는 것만으로는 op 경계를 넘는 tiling·fusion과 중간 tensor의 메모리 배치를 직접 지정하기 어려움
- 그래서 필요한 더 낮은 레벨: CUDA, CUTLASS, Triton, 그리고 최근의 CUDA Tile(cuTile)
- Flash Attention v1 → v2 → v3 → v4의 GPU utilization 개선과 serving용 attention engine인 FlashInfer
- Serving 최적화 framework - 이 최적화들을 하나로 묶는 layer
- vLLM: PagedAttention을 제안한 팀에서 시작해 널리 사용되는 오픈소스 서빙 엔진 - V1 엔진의
torch.compile통합과 하드웨어 플러그인 시스템 - 결론: LLM 추론 스택은 PyTorch 하나로 완성되지 않고, 커널 프로그래밍과 서빙 최적화라는 층이 함께 필요
- vLLM: PagedAttention을 제안한 팀에서 시작해 널리 사용되는 오픈소스 서빙 엔진 - V1 엔진의
LLM Inference의 성능 문제
Self Attention과 Scaled Dot-Product
LLM에서 가장 중요한 연산을 하나 꼽으라면 단연 Self-Attention, 그중에서도 실제로 그것을 계산하는 연산인 Scaled Dot-Product입니다. 왼쪽 그림처럼 한 문장이 주어졌을 때, 단어들 사이의 관계를 통해 “이 문장 안에서 이 단어가 어떤 의미를 갖는가”를 더 명확하게 뽑아내는 과정이 곧 self-attention이라고 생각할 수 있습니다.
이 과정은 잘 알려져 있듯이 K(Key), Q(Query), V(Value) 세 가지 값으로 이루어집니다. 각 단어의 embedding에 세 개의 weight를 곱해 만드는 벡터로, query는 “내가 무엇을 찾는가”, key는 “내가 무엇을 갖고 있는가”, value는 “실제로 전달할 내용”에 해당합니다. Attention은 단어들 사이의 연관성의 크기이고, query–key 내적으로 그 크기를 구한 뒤 value를 곱해 누적하면(=scaled dot-product), 특정 단어에 self-attention이 반영된 새로운 표현(embedding)이 만들어집니다.
오른쪽 그림에서 계산 측면의 포인트 하나는, 입력 단어 embedding으로부터 K·Q·V를 뽑아내는 부분은 단어마다 독립이라 모두 병렬로 처리할 수 있다는 점입니다. 그 뒤의 단계는 오른쪽 카드 ①~④ 순서입니다.
요약하자면 계산 특성은 다음과 같습니다.
- 병렬 처리가 자연스러운 부분 - 입력 embedding으로부터의 K·Q·V 계산, 그리고 단어별로 독립적인 하위(아래쪽) 연산
- 병렬 처리가 까다로운 부분 - 전체 분포를 봐야 하는 softmax, 그리고 그 결과와 V를 곱한 뒤 모든 단어에 대해 합산하는 summation
이 “위쪽이 병렬화하기 까다롭다”는 점은 이후 Flash Attention 같은 IO-aware 알고리즘(GPU의 메모리 계층을 고려한 알고리즘)이 풀어야 하는 문제로 다시 등장합니다.
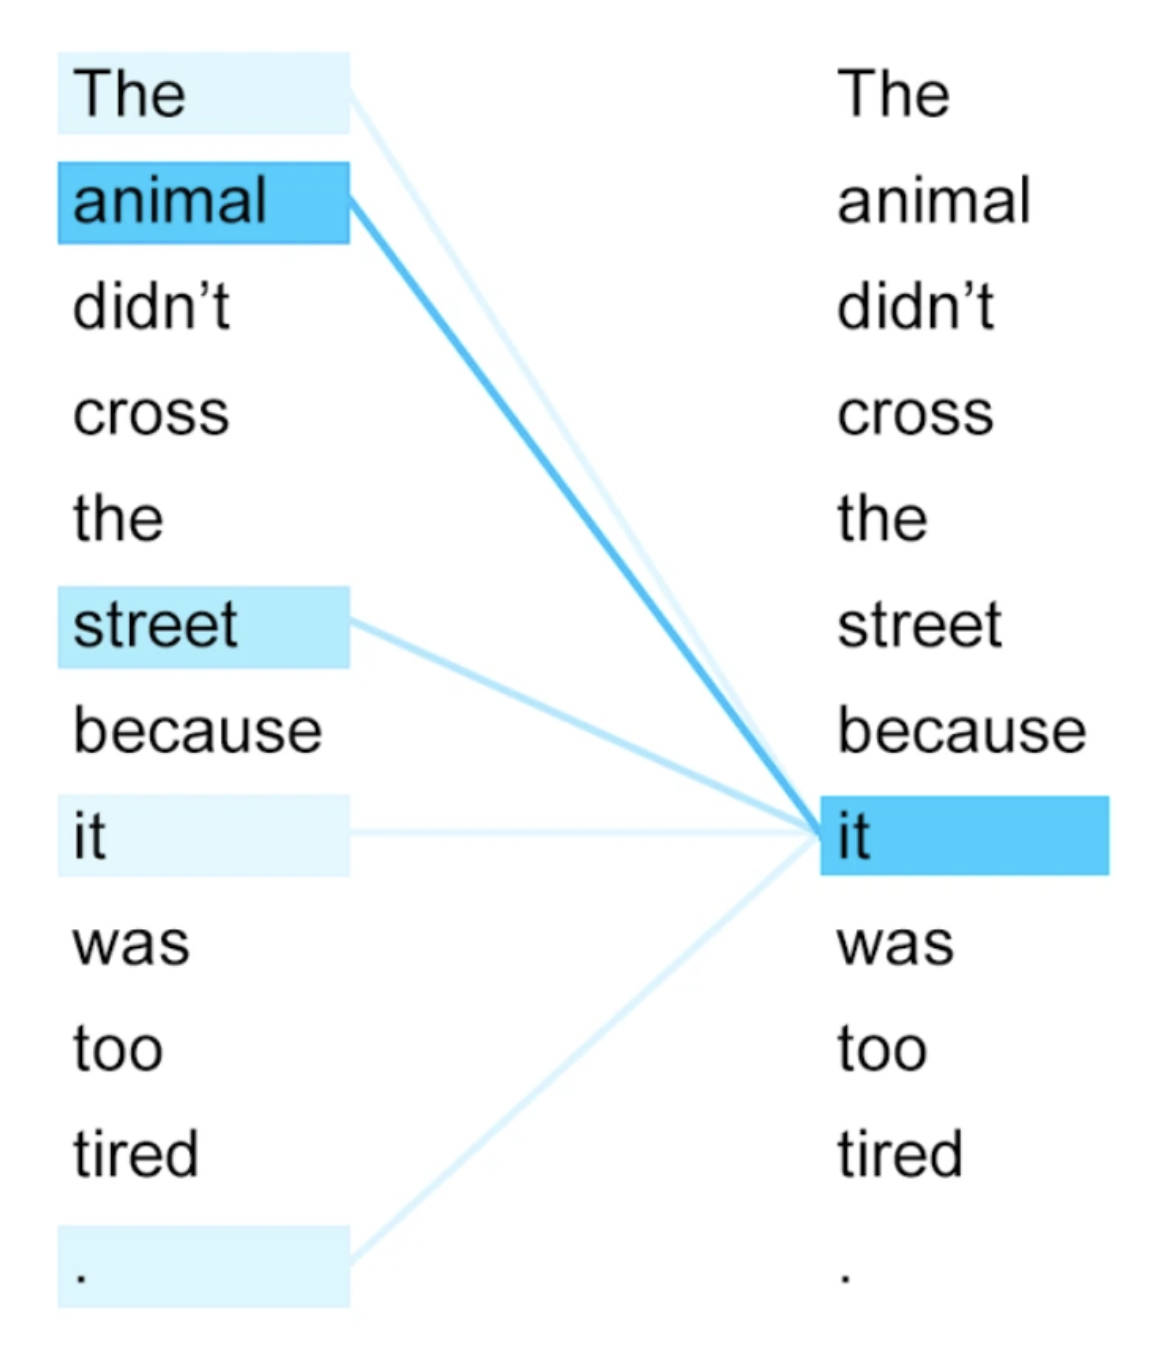
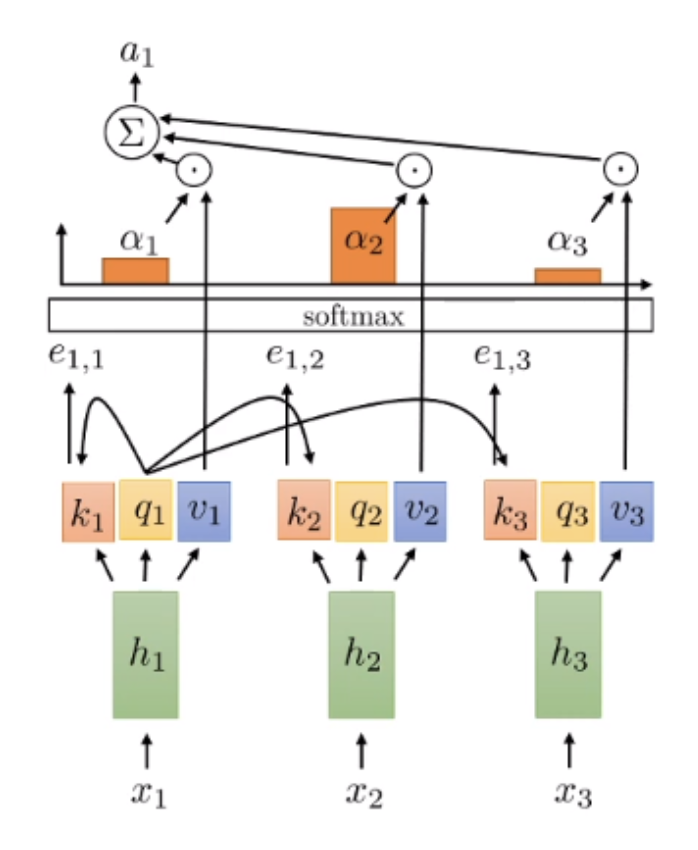
④ Self-attention이 반영된 “it”(=)의 새 embedding
출력 이 곧 “it”의 새 표현
③ 각 단어의 에 를 곱해 모두 더함
를 으로 합산
② softmax로 분포 계산
score 전체를 보고 합이 1이 되도록 정규화
① “it”(=)의 query를 모든 와 내적
을 , , 와 각각 내적하고 로 나눠 score 계산
출처: https://jalammar.github.io/illustrated-transformer/
출처: Why Self-Attention? A Targeted Evaluation of Neural Machine Translation Architectures
Non-Causal vs. Causal Attention
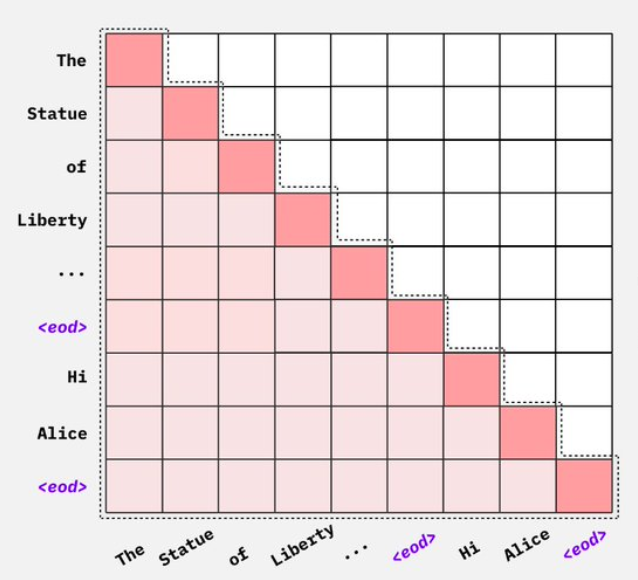
Self-Attention의 또 다른 중요한 특징은 Causal이냐, Non-Causal이냐입니다. 앞 슬라이드에서 본 “it” 예시는 사실 Non-Causal에 해당합니다. “it”의 attention을 구할 때 이 단어 앞에 있는 단어들과 뒤에 있는 단어들을 모두 사용해 계산했죠. 반면 오른쪽 그림처럼 Causal Attention에서는 자기 자신과 자기보다 먼저 나온 단어들로부터만 attention을 받도록 제한됩니다.
이 두 방식은 attention에서 참조할 수 있는 token 범위가 달라 계산 패턴에도 차이가 생깁니다. GPT 계열처럼 다음 token을 생성하는 decoder-only LLM은 일반적으로 Auto-regressive(Causal) Attention을 사용합니다. 반면 encoder 계열이나 multimodal model의 일부 attention block에서는 non-causal attention도 계속 사용됩니다.
Non-Causal Attention
앞/뒤 모든 단어를 고려 (양방향)
Causal Attention
현재 + 이전 단어만 고려 (단방향)
Prefill과 Decode
Decoder-Only LLM은 주어진 단어들로부터 다음 단어를 예측하는 일을 계속 반복합니다(Autoregressive). 이를 위해 먼저 Pretraining 단계에서 “개의 단어가 주어졌을 때 그다음 단어가 무엇인가”를 엄청나게 많이 반복 학습해 Trained Weights를 만듭니다. 학습이 끝나고 나면 같은 weight를 가지고 추론(decoding) 단계에서는 프롬프트가 들어왔을 때 그에 대한 답을 차례로 뱉어내는데, 이 과정은 다시 Prefill(프롬프트를 처리하는 단계)과 Decode(문장이 끝날 때까지 단어를 반복 생성하는 단계)로 나뉩니다.
Prefill과 Decode는 같은 model과 weight를 사용하는 두 실행 단계입니다. 다만 입력 shape과 병렬성이 크게 달라, 배포 환경에 따라 각 단계에 특화된 binary를 따로 compile하기도 합니다. 예를 들어 리벨리온에서는 Prefill과 Decode를 각각 compile해 별도의 binary로 사용합니다.
두 단계는 계산 특성이 다릅니다. 실제 추론 과정을 시간축에 펼쳐 보면 다음과 같습니다.
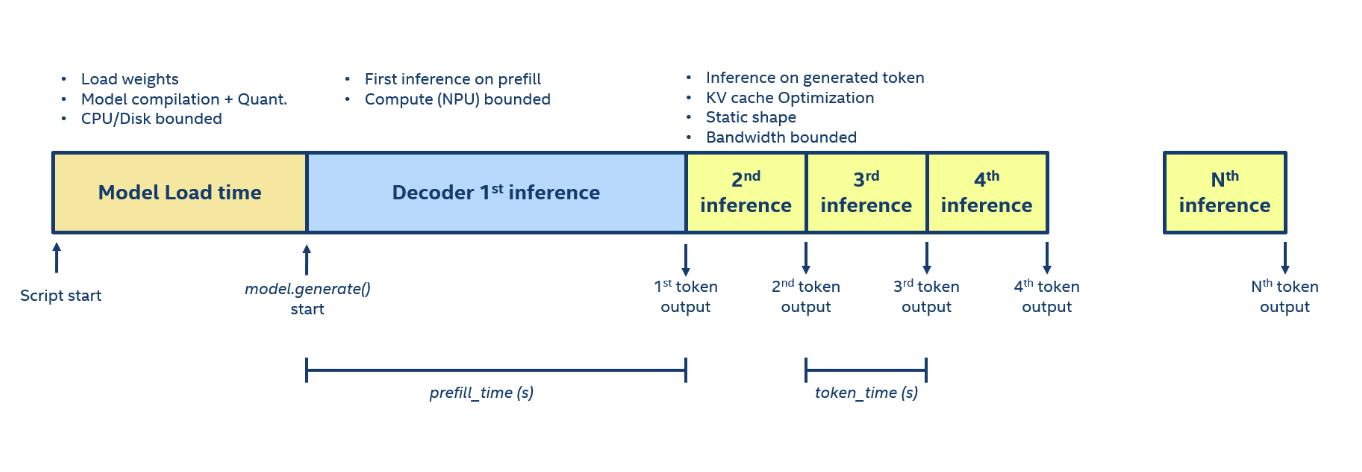
출처: https://intel.github.io/intel-npu-acceleration-library/llm_performance.html
가장 먼저 모델 로딩이 한 번 일어나고(이후로는 다시 로딩하지 않음), 거기서부터 첫 번째 토큰이 만들어질 때까지가 Prefill입니다. Prefill은 사실상 프롬프트를 이해하는 과정으로 볼 수 있습니다. 첫 토큰이 만들어진 뒤에는 한 토큰씩 차례로 만들어내며 문장이 끝날 때까지 반복하는데, 이 부분이 곧 실제 답을 만들어내는 Decode 과정입니다.
LLM 추론 성능은 Prefill과 Decode를 나누어 다음 지표로 측정합니다.
- TTFT(Time to First Token) - request가 들어온 뒤 첫 token이 반환될 때까지의 시간. Prefill이 큰 비중을 차지하지만 queueing과 scheduling 시간도 포함합니다.
- TPOT(Time per Output Token) - 첫 token 이후 output token 하나를 생성하는 데 걸린 평균 시간. 보통
(전체 latency - TTFT) / (output token 수 - 1)로 계산합니다. - ITL(Inter-Token Latency) - 연속한 두 output token 사이의 실제 시간 간격. TPOT가 request 전체의 평균이라면 ITL은 각 간격의 분포이므로 p50·p99 같은 tail latency를 확인할 수 있습니다.
- TPS(Tokens Per Second) - 일정 시간 동안 생성한 token 수. 단일 request의 평균 generation rate는 대략
1 / TPOT이고, server throughput은 동시에 처리한 모든 request의 token을 합산해 측정하므로 두 값을 구분해야 합니다.
Decode는 매 스텝 같은 모델을 돌리지만, Self-Attention이 참조할 이전 문맥(KV)은 토큰마다 길어집니다. 그래서 이론적으로는 뒤의 토큰일수록 생성 시간이 늘고 TPS가 떨어집니다.
Prefill vs. Decode: 병렬성의 차이
Prefill과 Decode는 여러 토큰을 처리하는 방식, 곧 병렬성이 다릅니다. 둘 다 “주어진 단어들로부터 다음 단어를 예측”하지만, 한 스텝에서 처리할 토큰들 사이의 의존 관계가 달라 계산의 모양이 달라집니다.
Decode 쪽이 직관적으로 이해하기 쉽습니다. 이전 토큰들은 이미(생성이든 입력이든) 모두 처리가 끝나 있고, 방금 막 만들어낸 마지막 토큰 하나로 그 다음 토큰을 예측합니다. 마지막 토큰 위치에서 self-attention을 다시 계산하고, linear layer + classification을 거쳐 다음 단어를 고르는 과정을 매 토큰마다 반복합니다. 그런데 그 다음 토큰을 만들려면 이전 토큰이 무엇이었는지가 입력으로 들어가야 하므로, 첫 번째 토큰이 끝나야 두 번째가 시작될 수 있고, 본질적으로 순차 처리(sequential)가 됩니다. 또한 누적된 토큰이 늘어날수록 self-attention에서 봐야 하는 KV도 함께 늘어납니다.
Prefill 쪽도 개념적으로는 거의 같습니다. Decoder-Only LLM이 할 줄 아는 일은 “단어들이 주어졌을 때 다음 단어를 예측하는 것” 하나뿐이니까요. 다만 Prefill에는 개 단어가 이미 주어져 있습니다. 예를 들어 프롬프트가 You are a helpful chatbot이라면, 두 번째 토큰 are를 처리할 때 “You의 다음 토큰이 무엇인지”는 이미 정해져 있고(=다음 입력 토큰 자체가 그것), 따라서 You의 처리 결과를 기다릴 필요가 없습니다. 그래서 다섯 토큰을 모두 동시에 첫 레이어부터 통과시킬 수 있습니다.
여기서 헷갈리기 쉬운 부분이 있는데, “동시에 처리해도 된다”는 건 토큰 간에 영향이 없다는 뜻이 아닙니다. attention을 통해 왼쪽 토큰이 오른쪽 토큰에 영향을 주는 것은 그대로지만, 어떤 한 토큰의 다음 토큰을 만들어내기 위한 최종 출력이 옆 토큰을 처리하는 데 필요한 입력이 아니기 때문에, 모든 토큰을 첫 레이어부터 차근차근 병렬로 진행할 수 있는 것입니다.
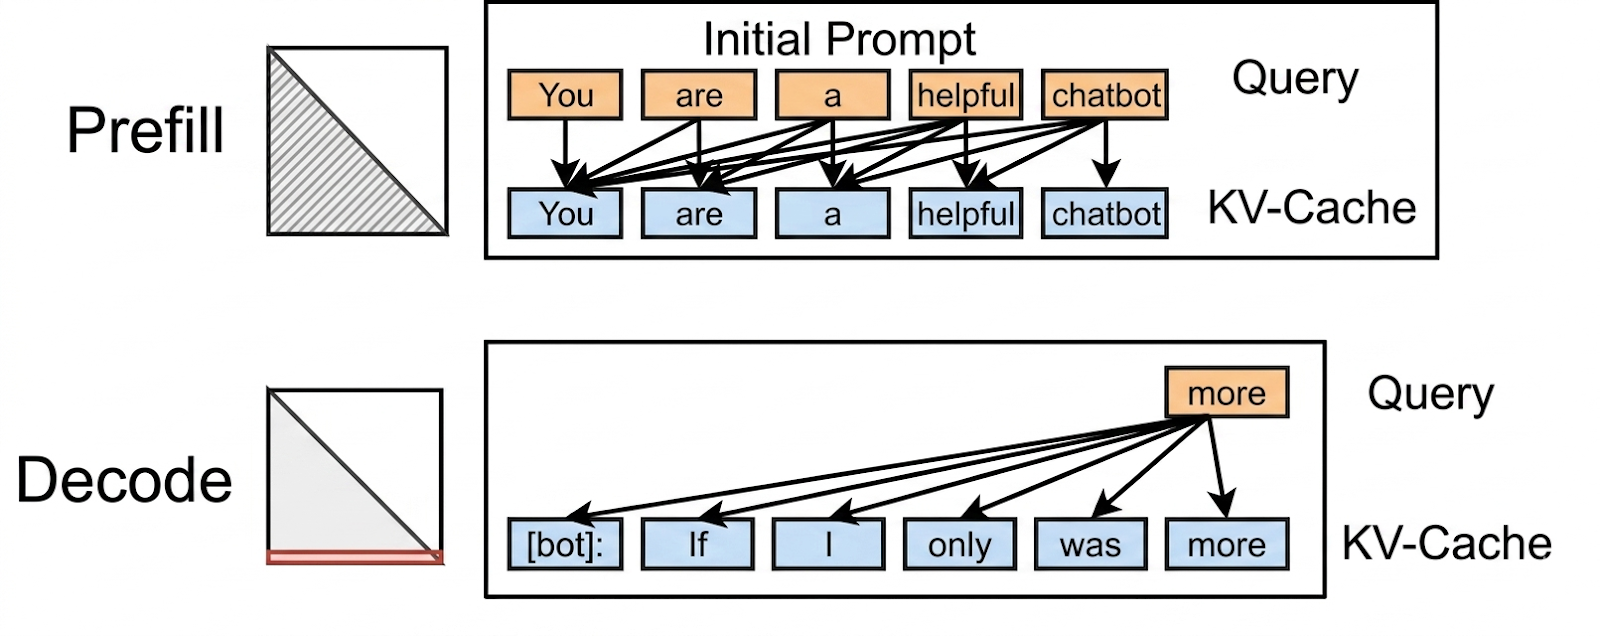
출처: https://flashinfer.ai/2024/02/02/introduce-flashinfer.html
위 위젯에서 세로축은 layer, 화살표는 attention(토큰 간 의존)을 뜻합니다. Prefill은 수직(레이어 간) + 우상향(KV 전달) 의존성만 있어 같은 레이어 안의 모든 토큰을 가로로 병렬 처리할 수 있는 반면, Decode는 새 토큰을 만들 때마다 직전 토큰의 결과가 입력으로 다시 들어가야 해서 토큰 단위로 순차 처리가 됩니다.
Q&A
강의 중 나온 질문들을 정리합니다.
Q. Transformer의 디코더와 다른 아키텍처인가요? Prefill·Decode를 두 모델로 만든다면 (Encoder–Decoder) Transformer와 비슷한 것 아닌가요? 아니요. Decoder-Only LLM 자체가 Transformer decoder만으로 구성된 구조라고 보면 됩니다. Prefill과 Decode를 개념적으로 두 모델처럼 다루는 이유는 여러 토큰을 한 번에 처리할 때의 병렬 가능성 양상이 다르기 때문이지, Encoder–Decoder 구조와는 다른 결의 구분입니다.
Q. 리벨리온이 Prefill·Decode를 두 번 컴파일한다고 했는데, 컴파일러 옵션을 달리 주는 건가요? 옵션 차이가 아니라 실제 생성되는 계산 자체가 다릅니다. 배치 사이즈도 다르고, Prefill은 한 토큰의 출력이 옆 토큰의 입력이 될 필요가 없어 모양 자체가 달라지므로, 결과적으로 별도의 binary로 빌드해 사용합니다.
Q. Prefill 그림의 화살표는 attention을 뜻하나요? 네, 여기서의 화살표는 attention을 의미합니다.
KV Cache
새 토큰 하나의 attention을 계산하려면 그 토큰의 query를 이전 모든 토큰의 key·value와 곱해야 합니다. 그런데 이전 토큰들의 K·V는 한 번 계산되고 나면 스텝이 지나도 변하지 않는 값입니다. 아무것도 저장해 두지 않는다면 새 토큰을 만들 때마다 시퀀스 전체를 첫 레이어부터 다시 통과시켜 같은 K·V를 재계산해야 하는데, 이는 매 스텝마다 prefill 하나를 통째로 다시 하는 것과 맞먹는 낭비입니다.
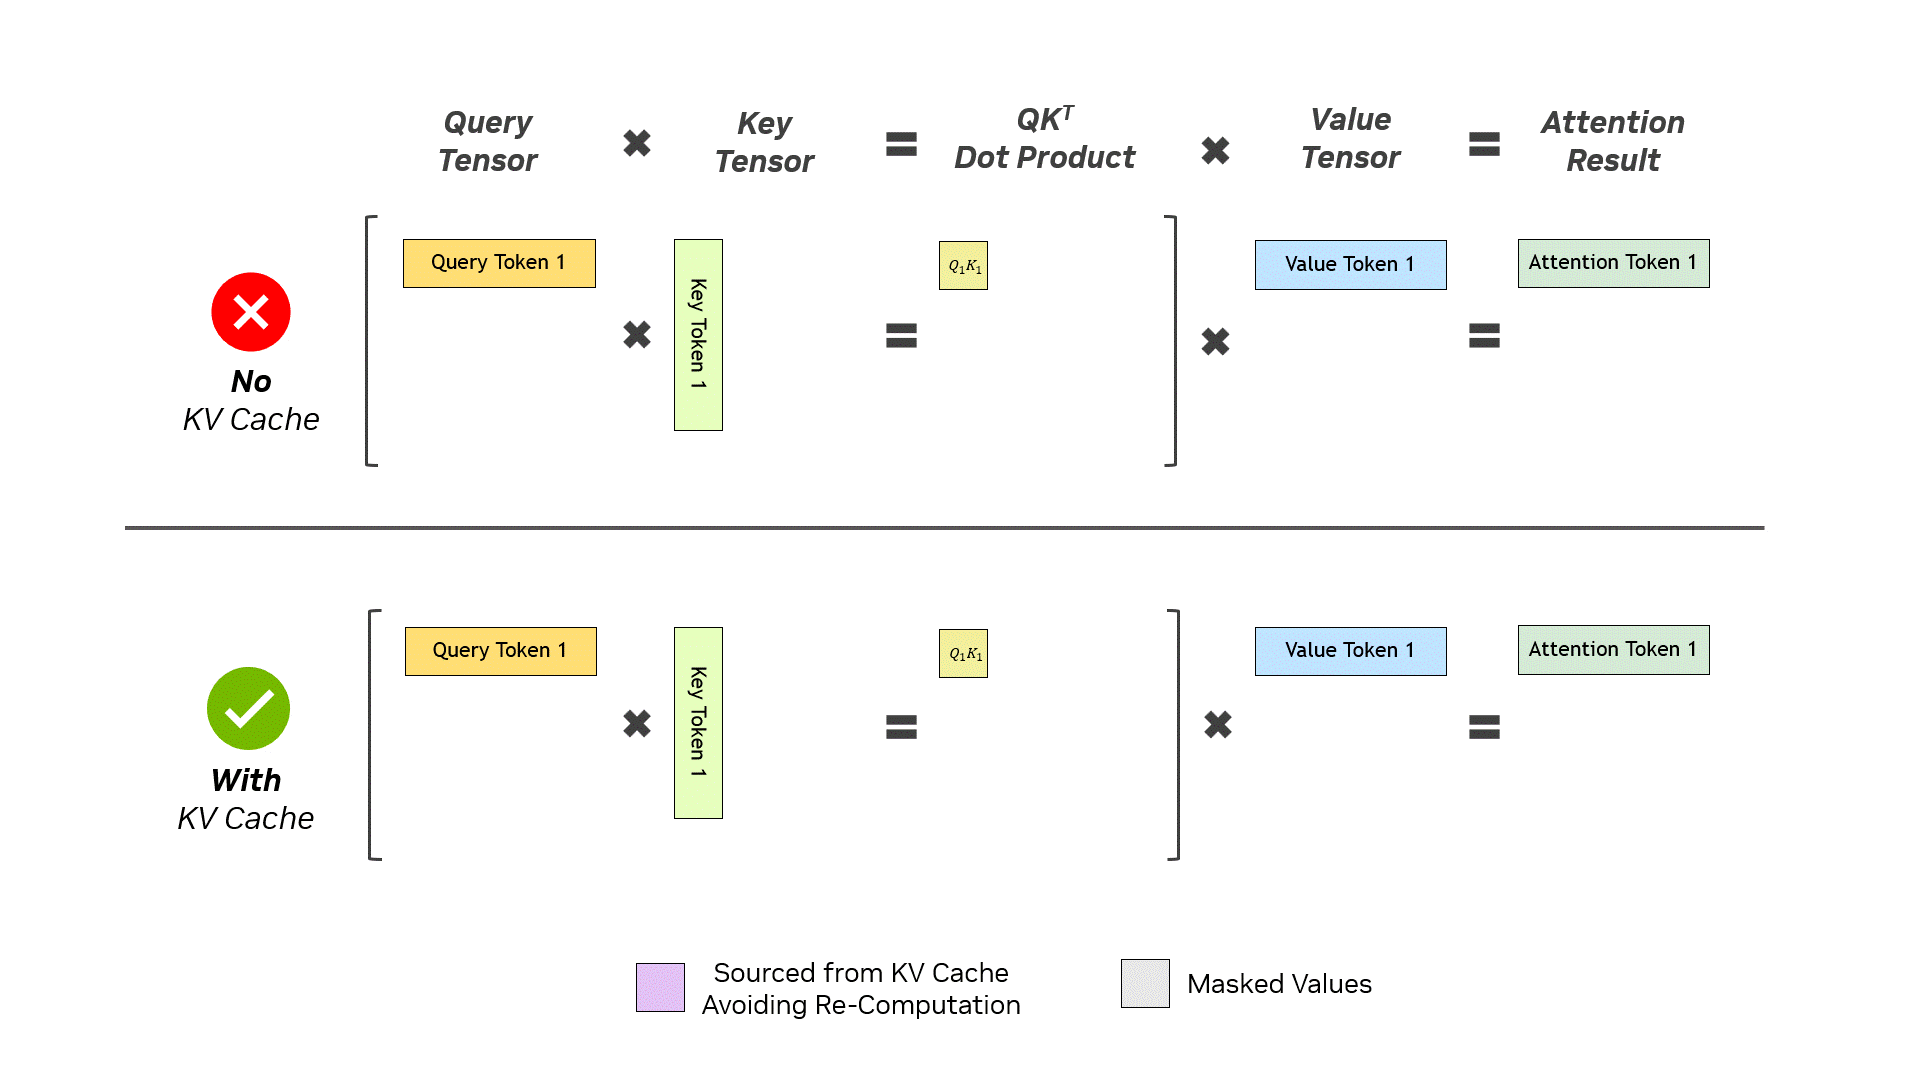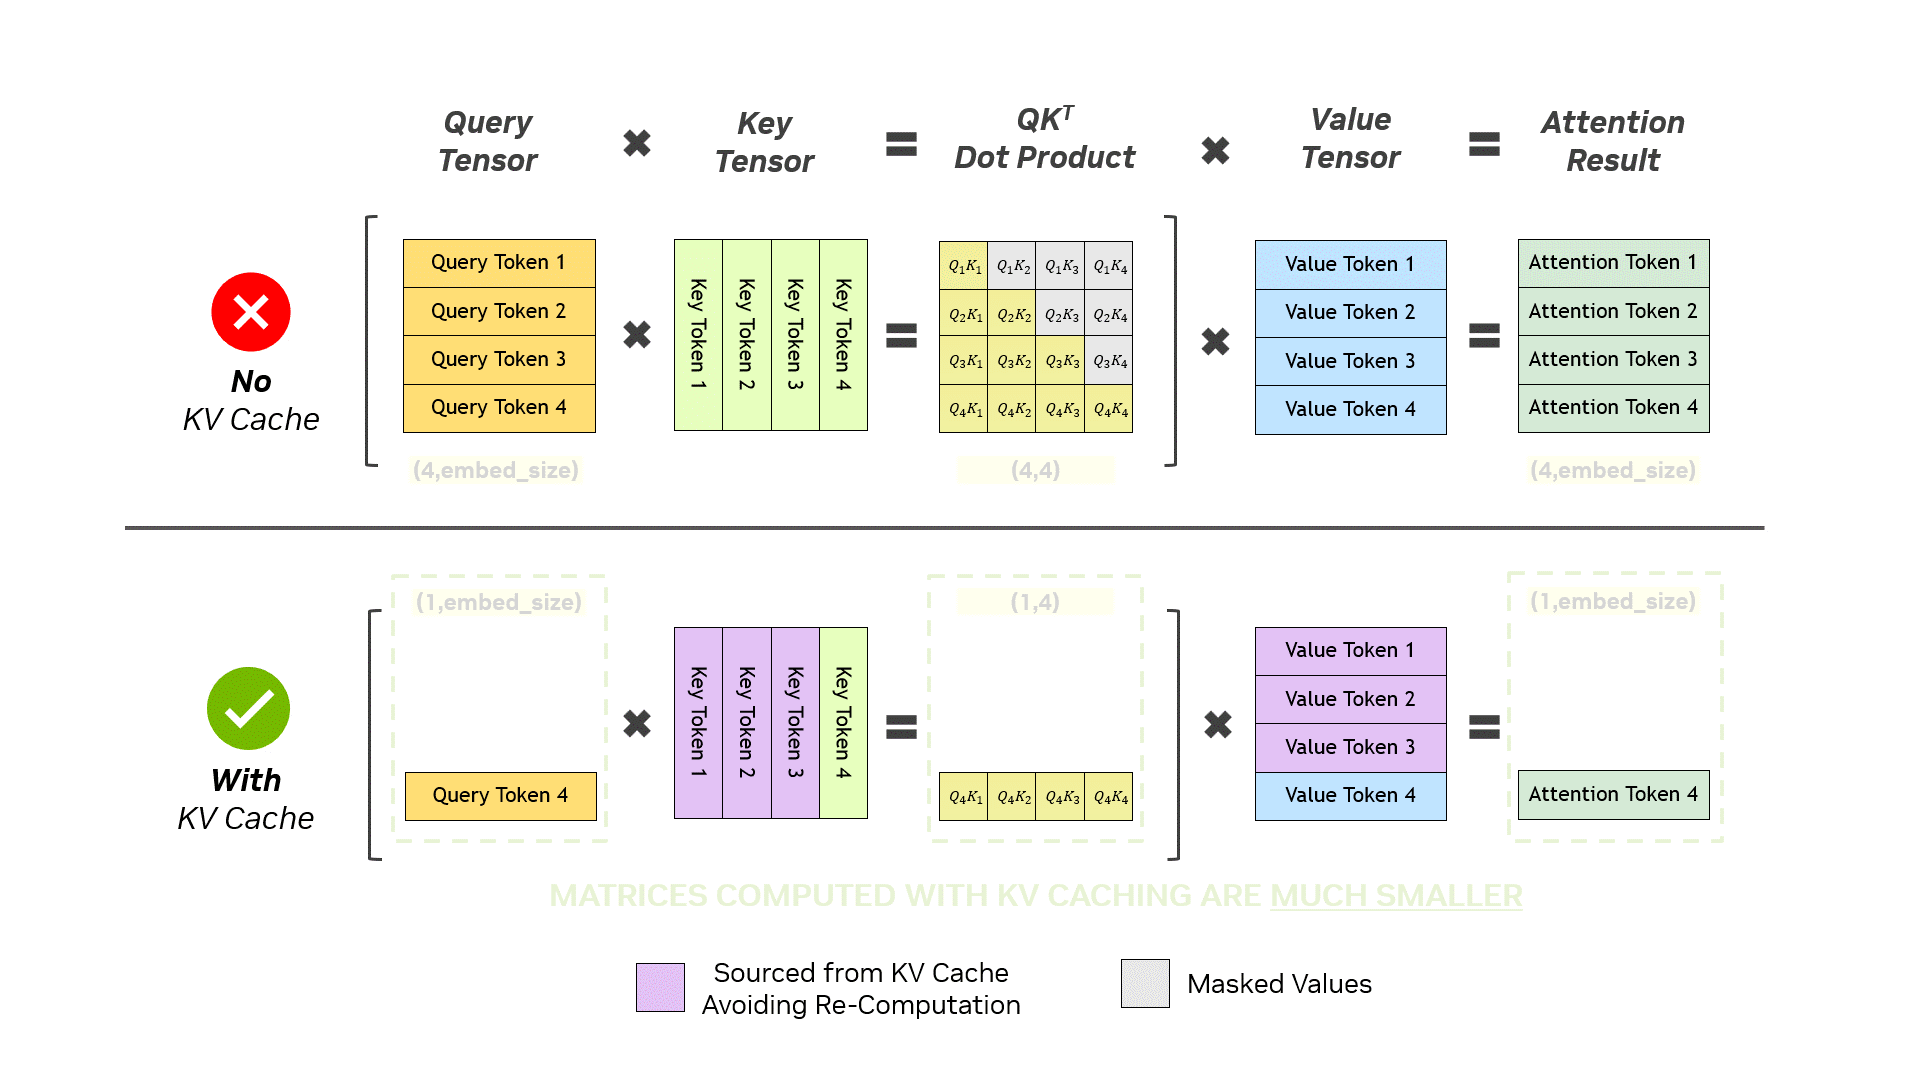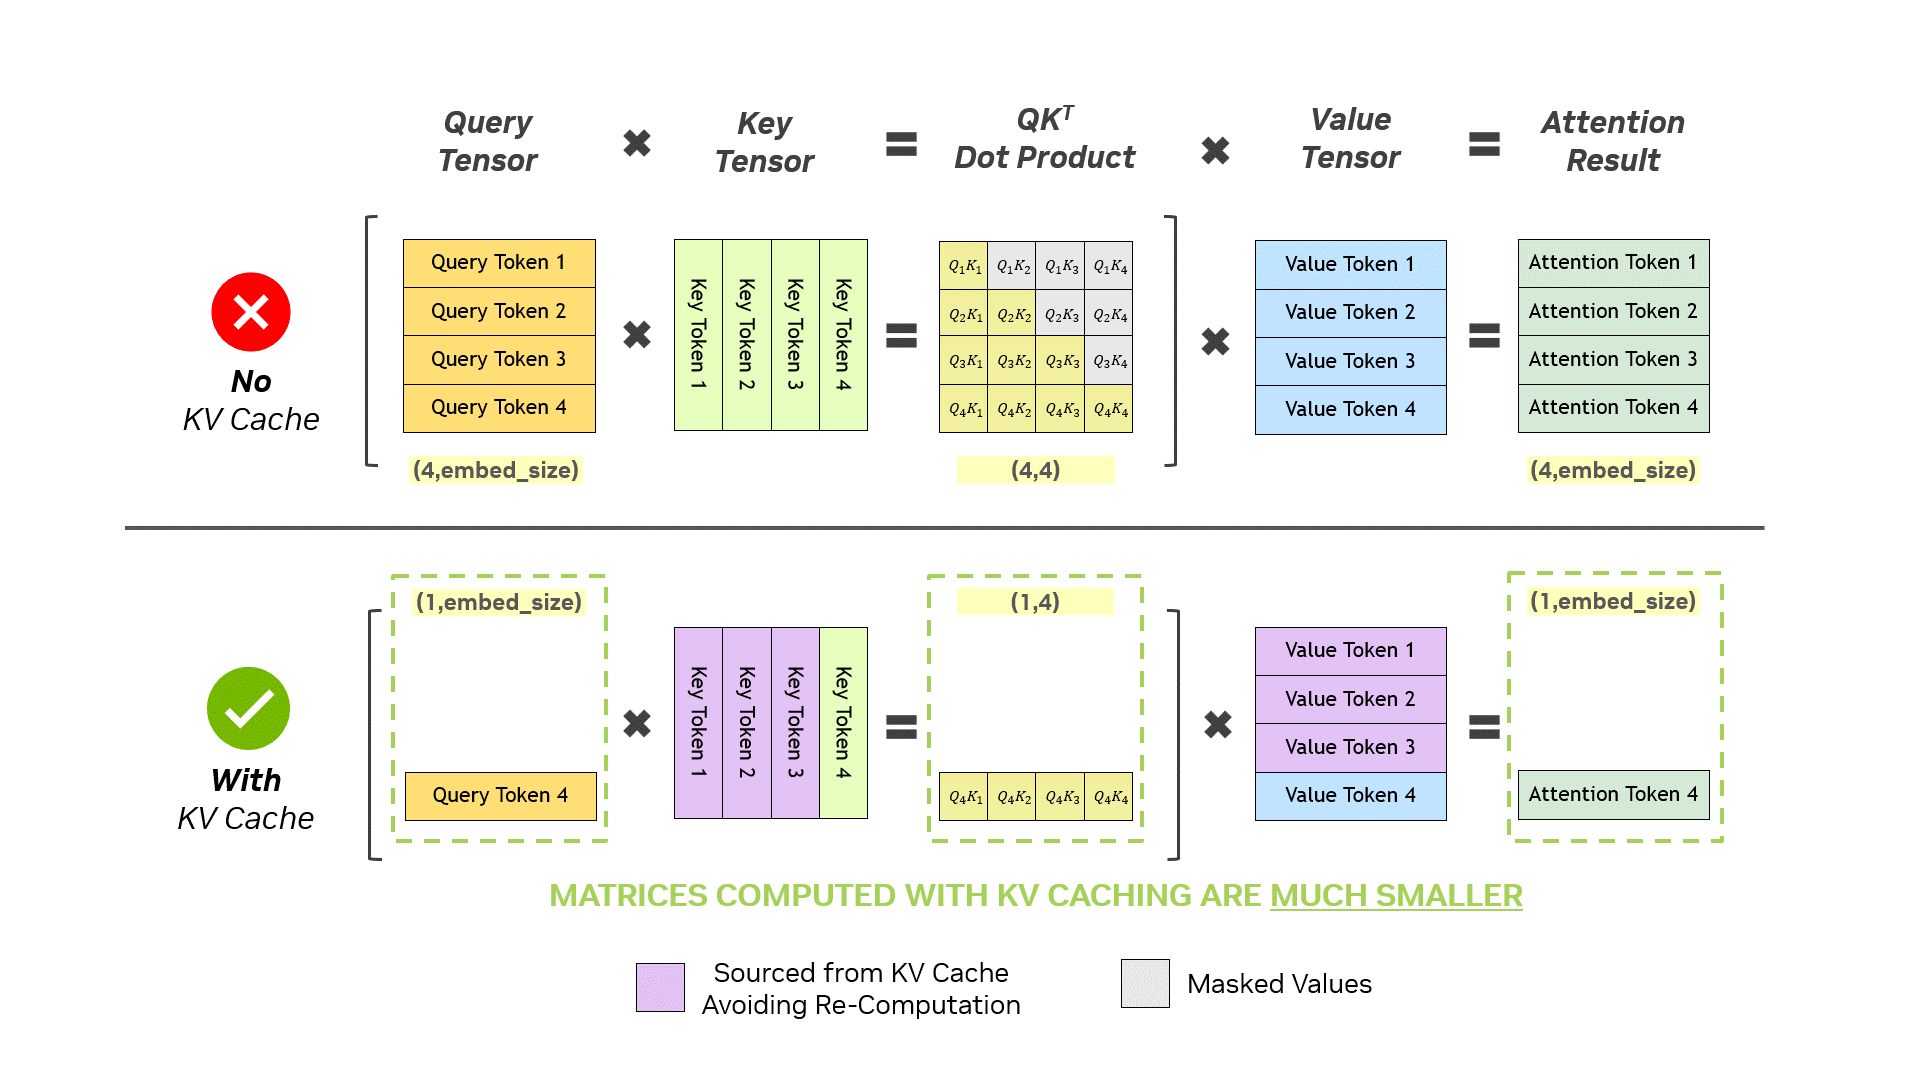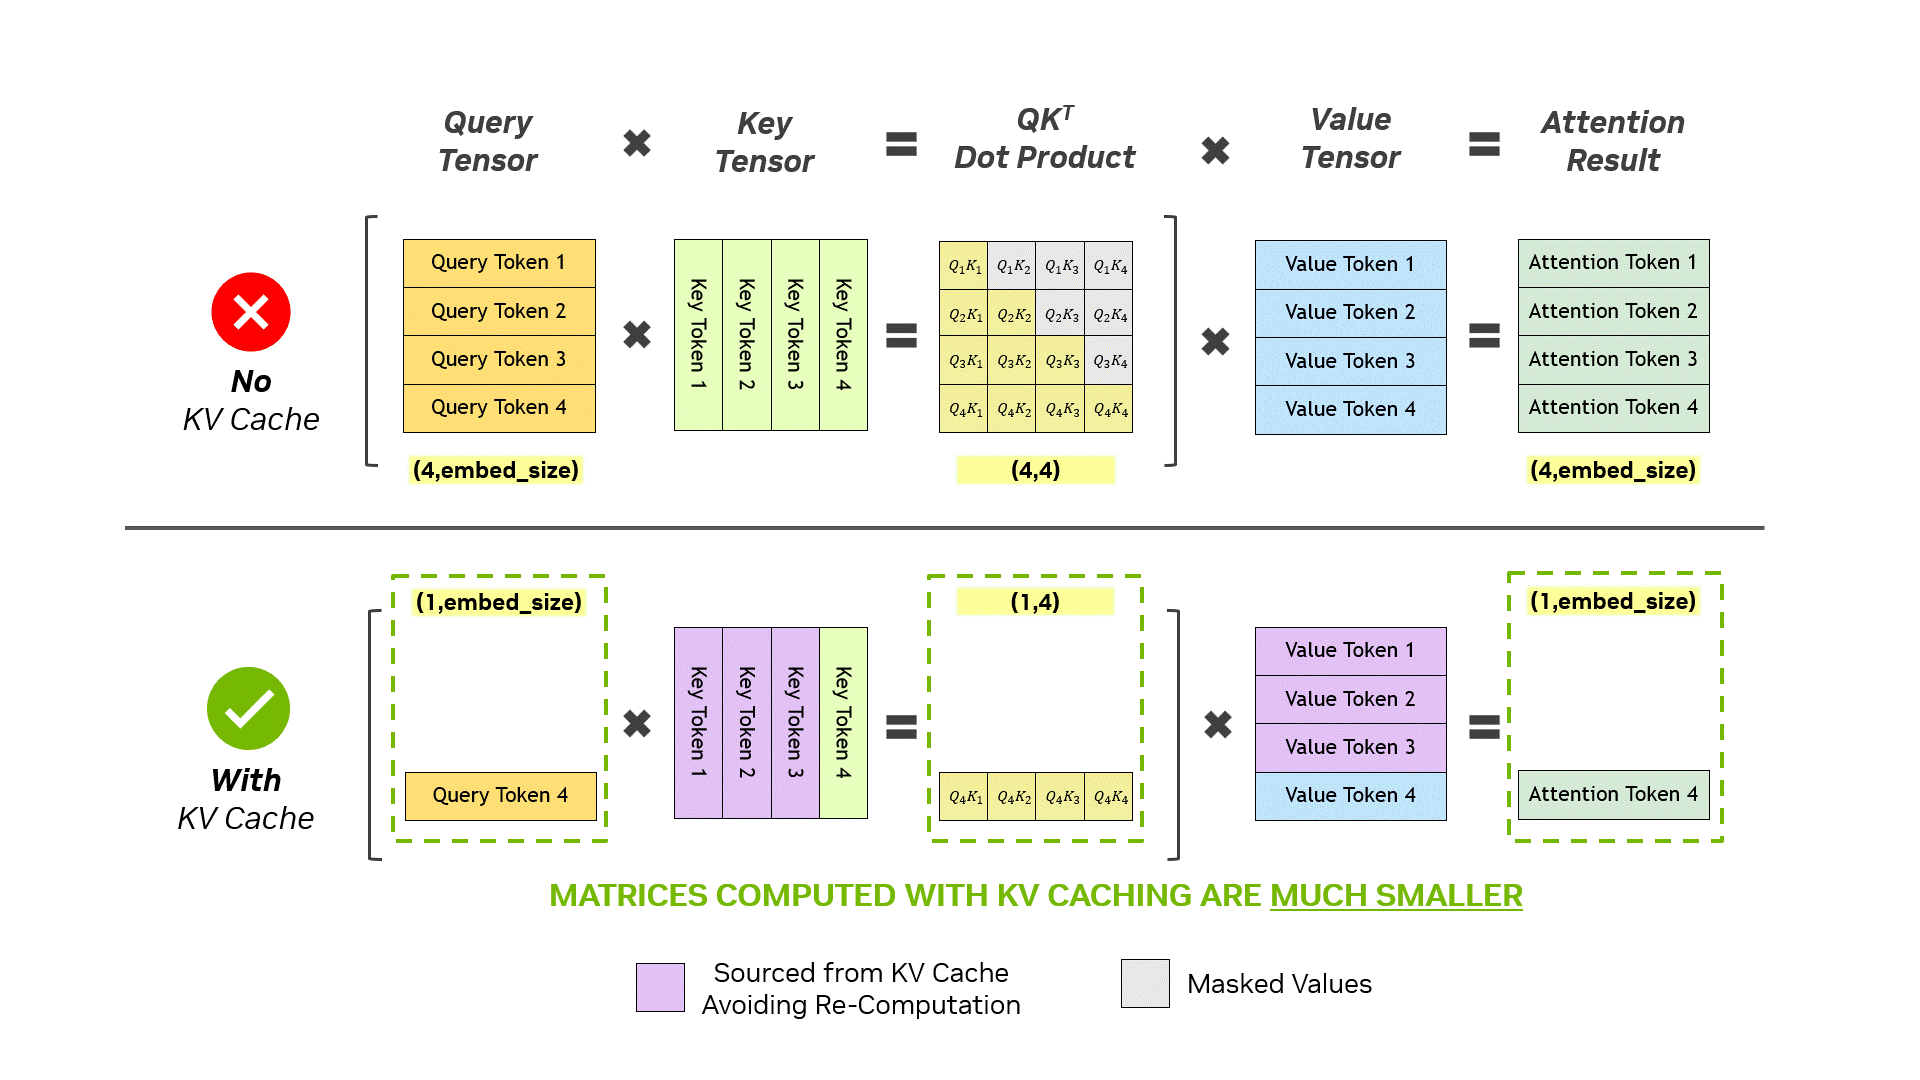
KV cache는 한 번 계산한 K·V를 저장해 두고 재사용합니다. 위 그림처럼 cache가 있으면 새 토큰의 query 하나만 가지고, K·V는 cache에서 가져와 attention을 계산할 수 있습니다. Cache의 동작은 append-only입니다. 매 스텝 새 토큰의 K·V만 계산해 cache 끝에 append하고, 기존 항목은 수정 없이 읽기만 합니다(retrieve). Prefill은 첫 토큰을 만들면서 프롬프트 전체의 KV cache도 함께 만듭니다. 뒤에서 볼 PD Disaggregation에서 Prefill 풀이 Decode 풀로 넘기는 것이 이 KV cache입니다.
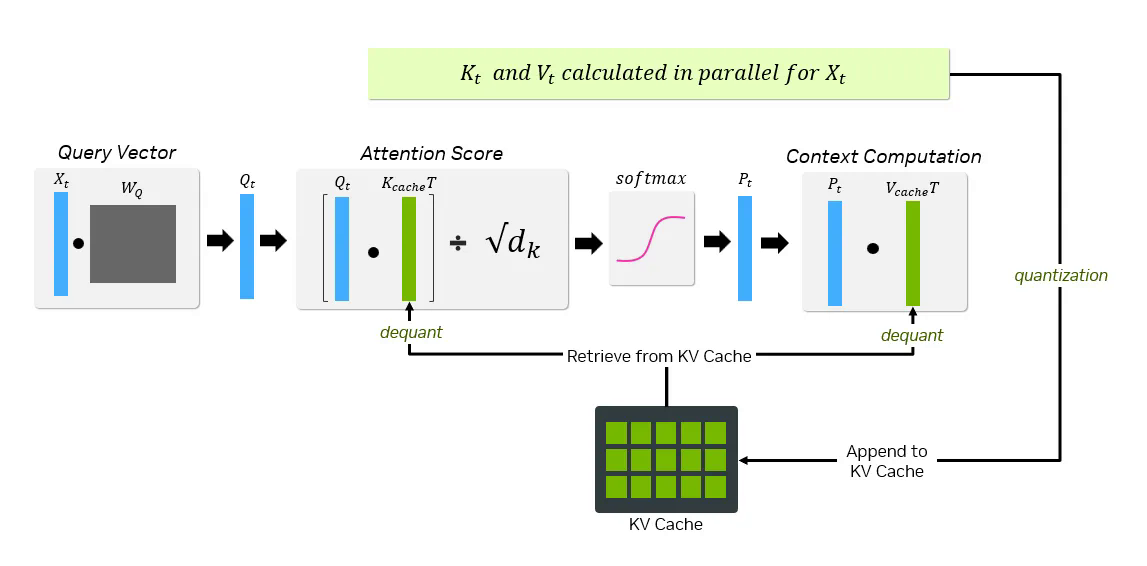
출처: Optimizing Inference for Long-Context and Large Batch Sizes with NVFP4 KV Cache (NVIDIA)
KV cache의 비용은 두 가지입니다. 시퀀스 길이에 비례해 메모리를 차지하고(크기는 뒤의 Paged Attention 절에서 계산합니다), 매 decode 스텝마다 쌓인 cache 전체를 HBM1에서 다시 읽어야 합니다. 그래서 Decode는 매 스텝 weight 전체와 KV cache 전체를 읽으면서 연산은 토큰 하나 분량만 합니다. 다음 절의 “Decode는 Memory Bound”라는 진단이 이 구조에서 나옵니다. KV cache를 FP8·NVFP4 같은 저정밀 포맷으로 양자화해 용량과 읽기 트래픽을 줄이는 것도 같은 이유입니다.
Roofline Analysis
Prefill과 Decode의 차이는 Roofline Analysis 그래프 한 장으로 정리됩니다. 아키텍처나 성능 분석을 하는 분들에게는 익숙한 그래프입니다. “Decode 쪽 Memory Bound 영역의 사선”과 “ridge point 이후 평평해지는 가로선”이 마치 지붕(roof)처럼 보인다고 해서 붙은 이름입니다.
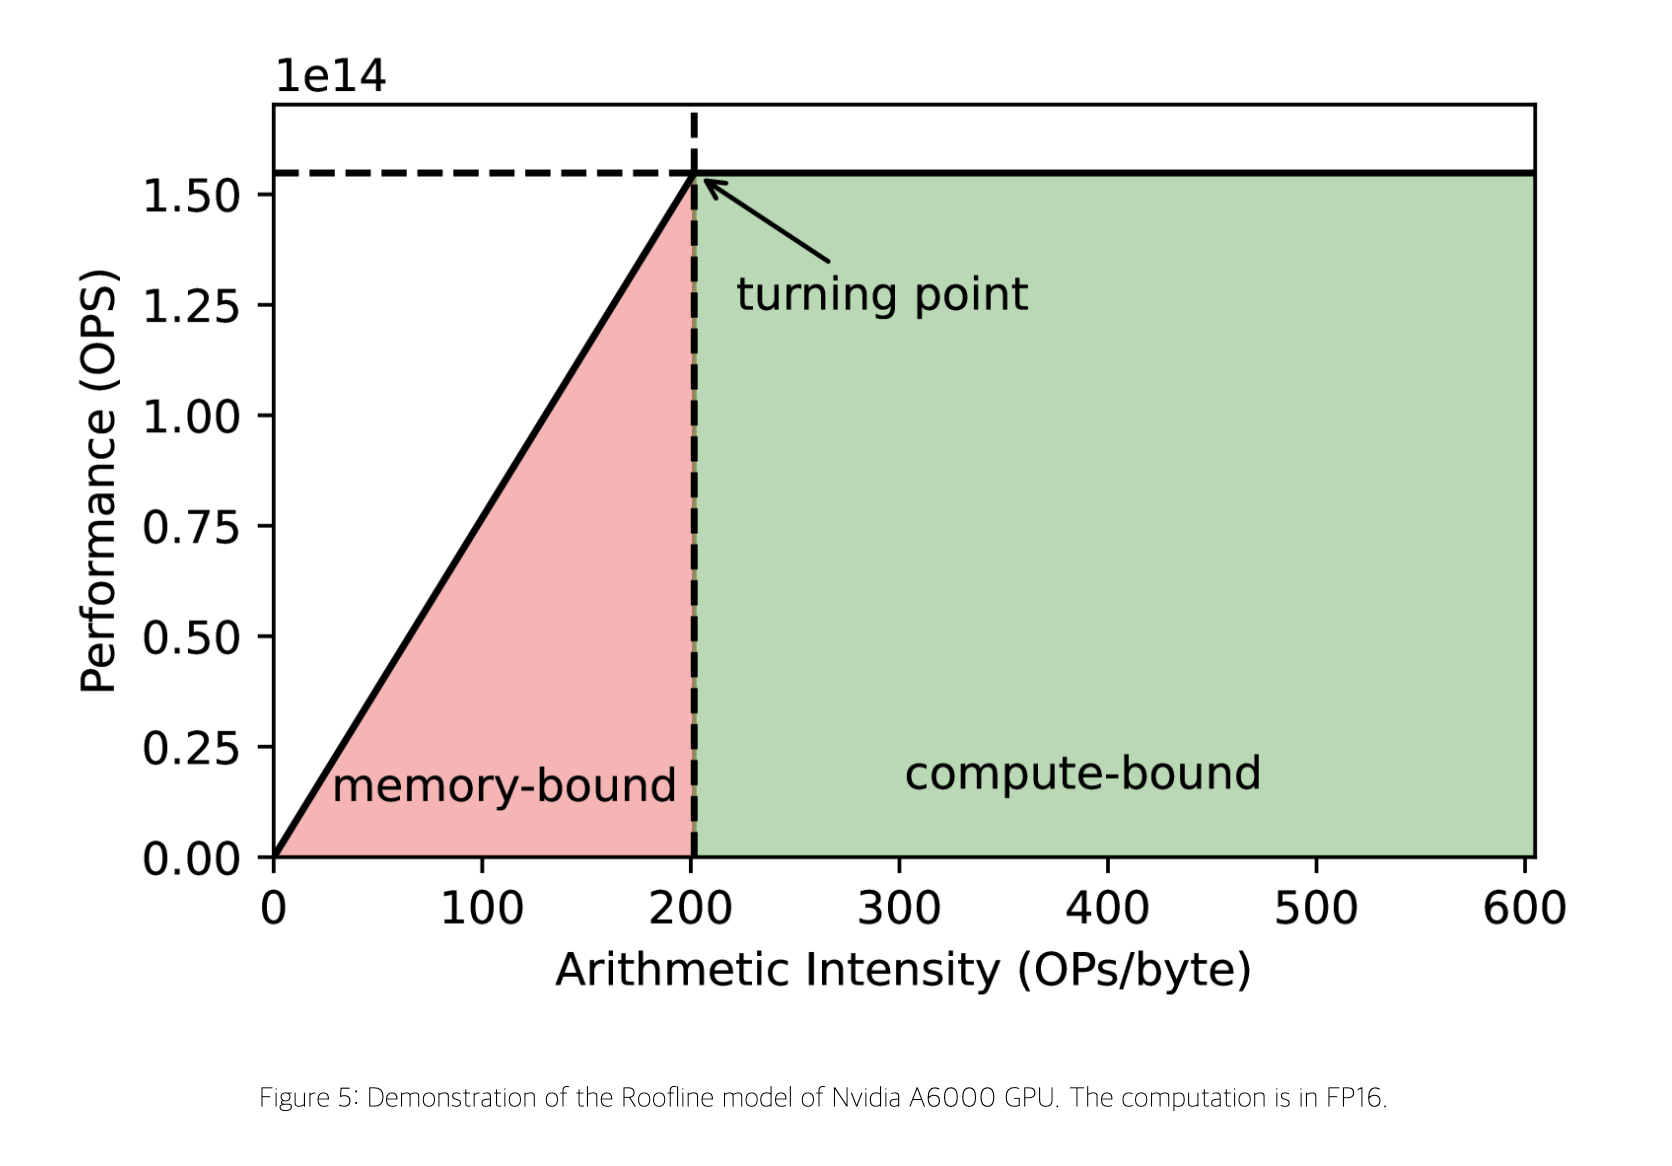
출처: LLM Inference Unveiled: Survey and Roofline Model Insights
컴퓨터를 (1) 메모리에서 데이터를 읽고 쓰는 비용 + (2) 가져온 데이터로 실제 연산을 수행하는 비용 두 가지로만 나눠 모델링했을 때, 지금 내가 어느 쪽에 묶여 있는가, Memory Bound인지 Compute Bound인지를 판별해 주는 그래프입니다.
- 왼쪽 영역 (Memory Bound) - 연산기는 아직 여유가 있는데, 데이터를 들여오고 내보내는 속도가 따라오지 못해 칩이 자기 풀스펙 연산력을 다 못 쓰는 상황
- 오른쪽 영역 (Compute Bound) - 연산기 자체가 이미 꽉 차 있어, 아무리 Arithmetic Intensity가 더 높아져도 더는 빨라지지 않는 상황
X축의 Arithmetic Intensity는 알고리즘의 고유 특성으로, “메모리에서 한 번 들고 온 데이터로 몇 번의 연산을 수행하는가”를 뜻합니다. (이 그래프와 판별 기준을 수식으로 정리한 내용은 강의 끝의 보충: Roofline을 수식으로 정리하기에서 다룹니다.)
이걸 Prefill·Decode에 대입하면 차이가 명확합니다. Prefill에서 I like my cat처럼 4개 토큰을 횡적으로 동시에 처리할 때, 한 레이어의 weight는 한 번만 들고 와서 4번 재사용됩니다. 즉 메모리 접근당 연산량이 4배라 Arithmetic Intensity가 높습니다. 반면 Decode에서 lot 한 토큰을 만들 때는 같은 weight를 들고 오지만 연산은 1번뿐이라 Intensity가 1/4 수준이 됩니다.
결과적으로:
- Decode - Arithmetic Intensity가 낮아 Memory Bound, 원하는 만큼 계산을 다 못 함
- Prefill - Arithmetic Intensity가 높아 Compute Bound, 연산기는 꽉 차 있어 더 끌어올릴 여지가 적음
Prefill은 병목이 연산기 쪽에 있어 더 끌어올릴 여지가 적다는 뜻이지, peak 성능을 낸다는 뜻은 아닙니다(kernel 효율은 별개의 문제로, 뒤의 FlashAttention 절에서 다룹니다). 이 그래프를 보면 보통 “메모리 대역폭을 늘려야 하나?”보다 “Decode가 프로세서 성능을 다 못 쓰고 있다”는 결론을 내립니다. 그래서 LLM 추론 최적화는 주로 Decode 단계를 겨냥합니다.
Q. Sparse Matrix 연산처럼 “의미 없는 계산”이 많이 끼는 경우 Arithmetic Intensity 자체가 의미가 있을까요? 그런 경우 intensity가 다소 희석되긴 합니다. 다만 머신러닝에서는 모델이 수학적으로 필요로 하는 FLOPs만 세고, 프로세서가 그 기준으로 peak의 몇 %를 내는지를 따로 재는 지표가 있습니다. MFU(Model FLOPs Utilization)입니다. Dense 계산이고 무의미한 연산 비중이 충분히 작다면 Arithmetic Intensity는 여전히 유효한 지표입니다.
Prefill–Decode Disaggregation
Prefill은 Compute Bound, Decode는 Memory Bound라 필요한 하드웨어 자원이 다릅니다. 한 GPU에 둘을 같이 두면 서로를 방해합니다. 긴 프롬프트의 Prefill이 들어오는 순간 그 GPU에서 돌던 Decode들이 밀려 토큰 생성 간격이 튀고, 반대로 Decode만 돌 때는 연산기가 놉니다. TTFT와 TPOT라는 두 지표를 한 머신 위에서 동시에 최적화하기가 구조적으로 어렵다는 뜻입니다.
일부 대규모 서빙 시스템은 Prefill 전용 instance와 Decode 전용 instance를 pool로 분리하고, Prefill이 만든 KV cache를 NVLink·RDMA 같은 interconnect를 통해 Decode 쪽으로 전달하는 Prefill–Decode Disaggregation(PD 분리)을 사용합니다. 두 pool을 독립적으로 scale하고, Prefill의 TTFT와 Decode의 throughput·TPOT를 각각 조정할 수 있습니다. DistServe, Mooncake, NVIDIA Dynamo와 vLLM·SGLang의 disaggregated serving 지원이 이 구성의 사례입니다.
앞서 Prefill과 Decode가 같은 model의 서로 다른 실행 단계이며, 환경에 따라 별도 binary로 compile할 수 있다고 했습니다. Disaggregation은 이 구분을 배포 단위까지 확장해 두 단계를 서로 다른 machine pool에서 실행합니다.
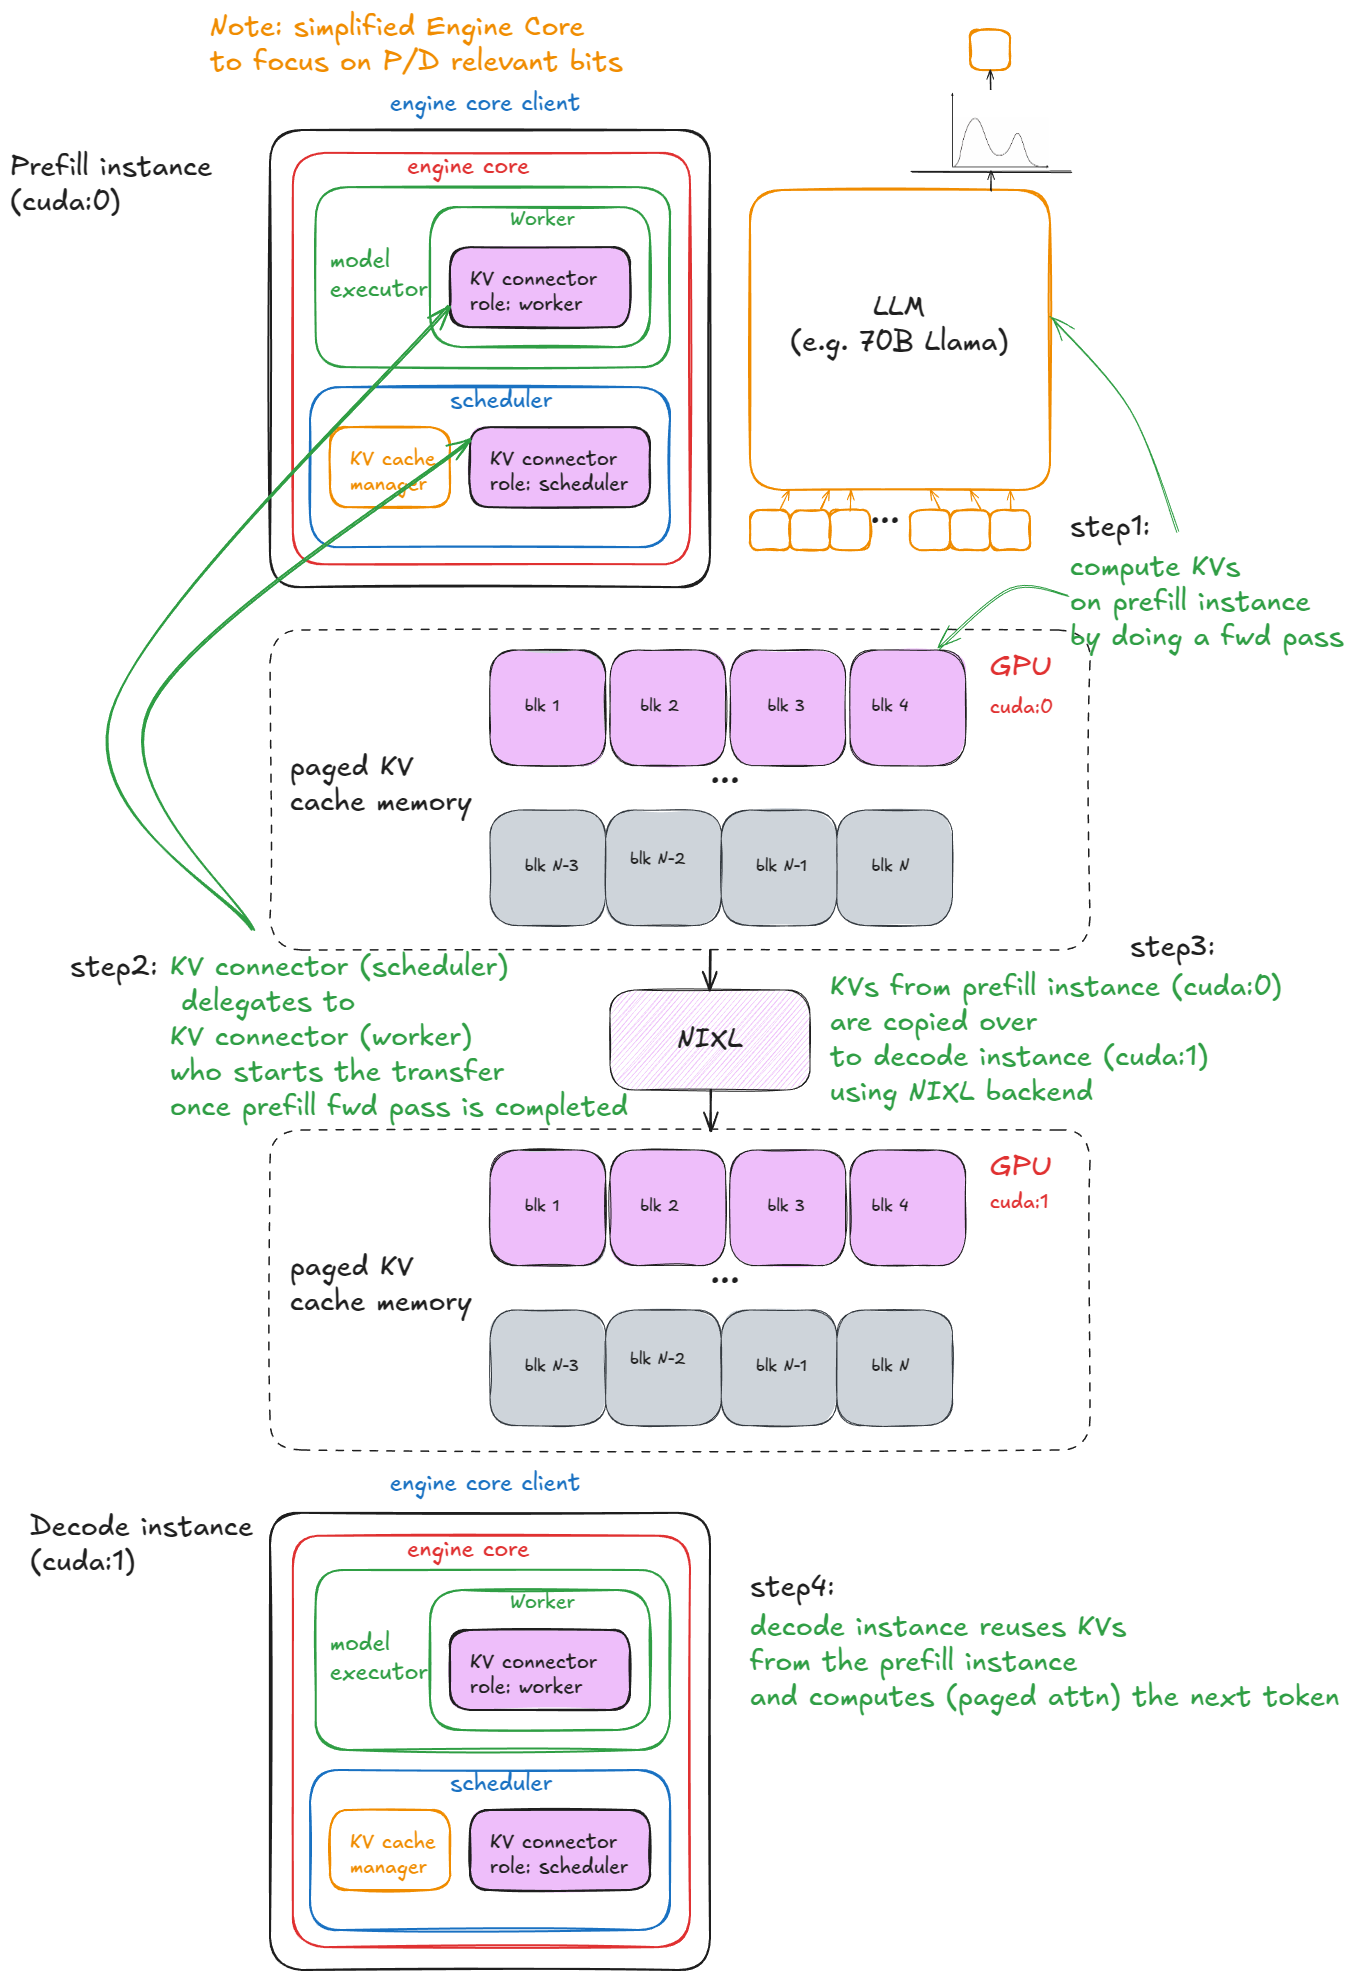
그림의 engine core는 vLLM의 scheduler + model executor 묶음이고, worker는 GPU 하나에서 forward를 실행하는 프로세스입니다. Prefill 쪽 KV connector가 forward가 끝난 KV block을 NIXL(NVIDIA Inference Xfer Library, GPU 간 전송 라이브러리)로 Decode 인스턴스의 paged KV cache에 복사합니다.
출처: Inside vLLM: Anatomy of a High-Throughput LLM Inference System
참고: DistServe: Disaggregating Prefill and Decoding for Goodput-optimized LLM Serving (OSDI ‘24)
참고: vLLM: Easy, Fast, and Cheap LLM Serving for Everyone — Simon Mo
Memory Wall
메모리 병목은 LLM 추론만의 문제가 아닙니다. 프로세서를 설계할 때도 메모리가 가장 자주 병목이 되고, 메모리 성능이 전체 시스템 성능을 좌우한다고 보는 것이 일반적입니다.
이 현상은 오래전부터 알려져 있었습니다. 아래 1995년 논문은 “Memory Wall” 이라는 용어를 처음 쓰거나 적어도 널리 알렸고, 당시에도 “프로세서의 성능은 연산을 얼마나 빨리 처리하느냐가 아니라, 데이터를 얼마나 빨리 들고 오고 내보낼 수 있느냐로 결정된다” 는 지적이 있었습니다.
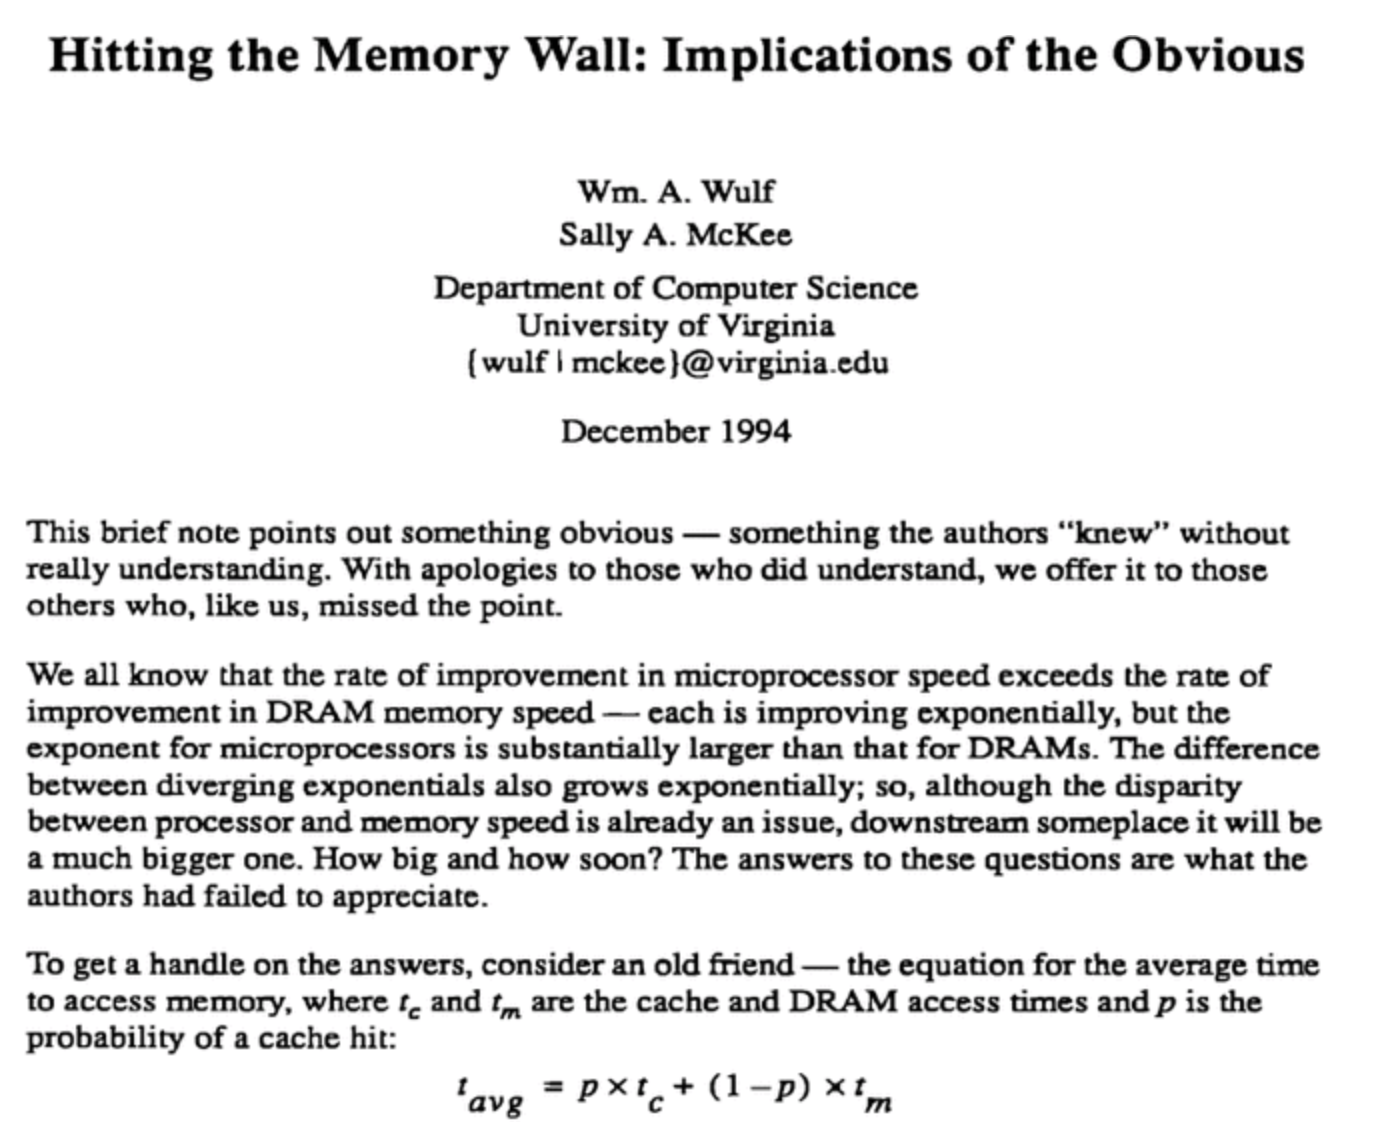
출처: Wulf & McKee, “Hitting the Memory Wall: Implications of the Obvious”, ACM SIGARCH Computer Architecture News 23(1), 1995
메모리 인터페이스도 발전하고 있습니다. HBM 같은 기술이 계속 나오면서 대역폭은 꾸준히 늘고 있습니다.
다만 하드웨어의 연산 밀도(Computing Density)는 그보다 훨씬 빠르게 늘어납니다. 두 곡선의 격차가 벌어지면서 연산 대비 메모리 성능은 시간이 갈수록 더 부족해집니다. 그래서 LLM 추론을 비롯한 대부분의 워크로드에서는 메모리 대역폭을 얼마나 효율적으로 쓰느냐가 성능을 좌우합니다.
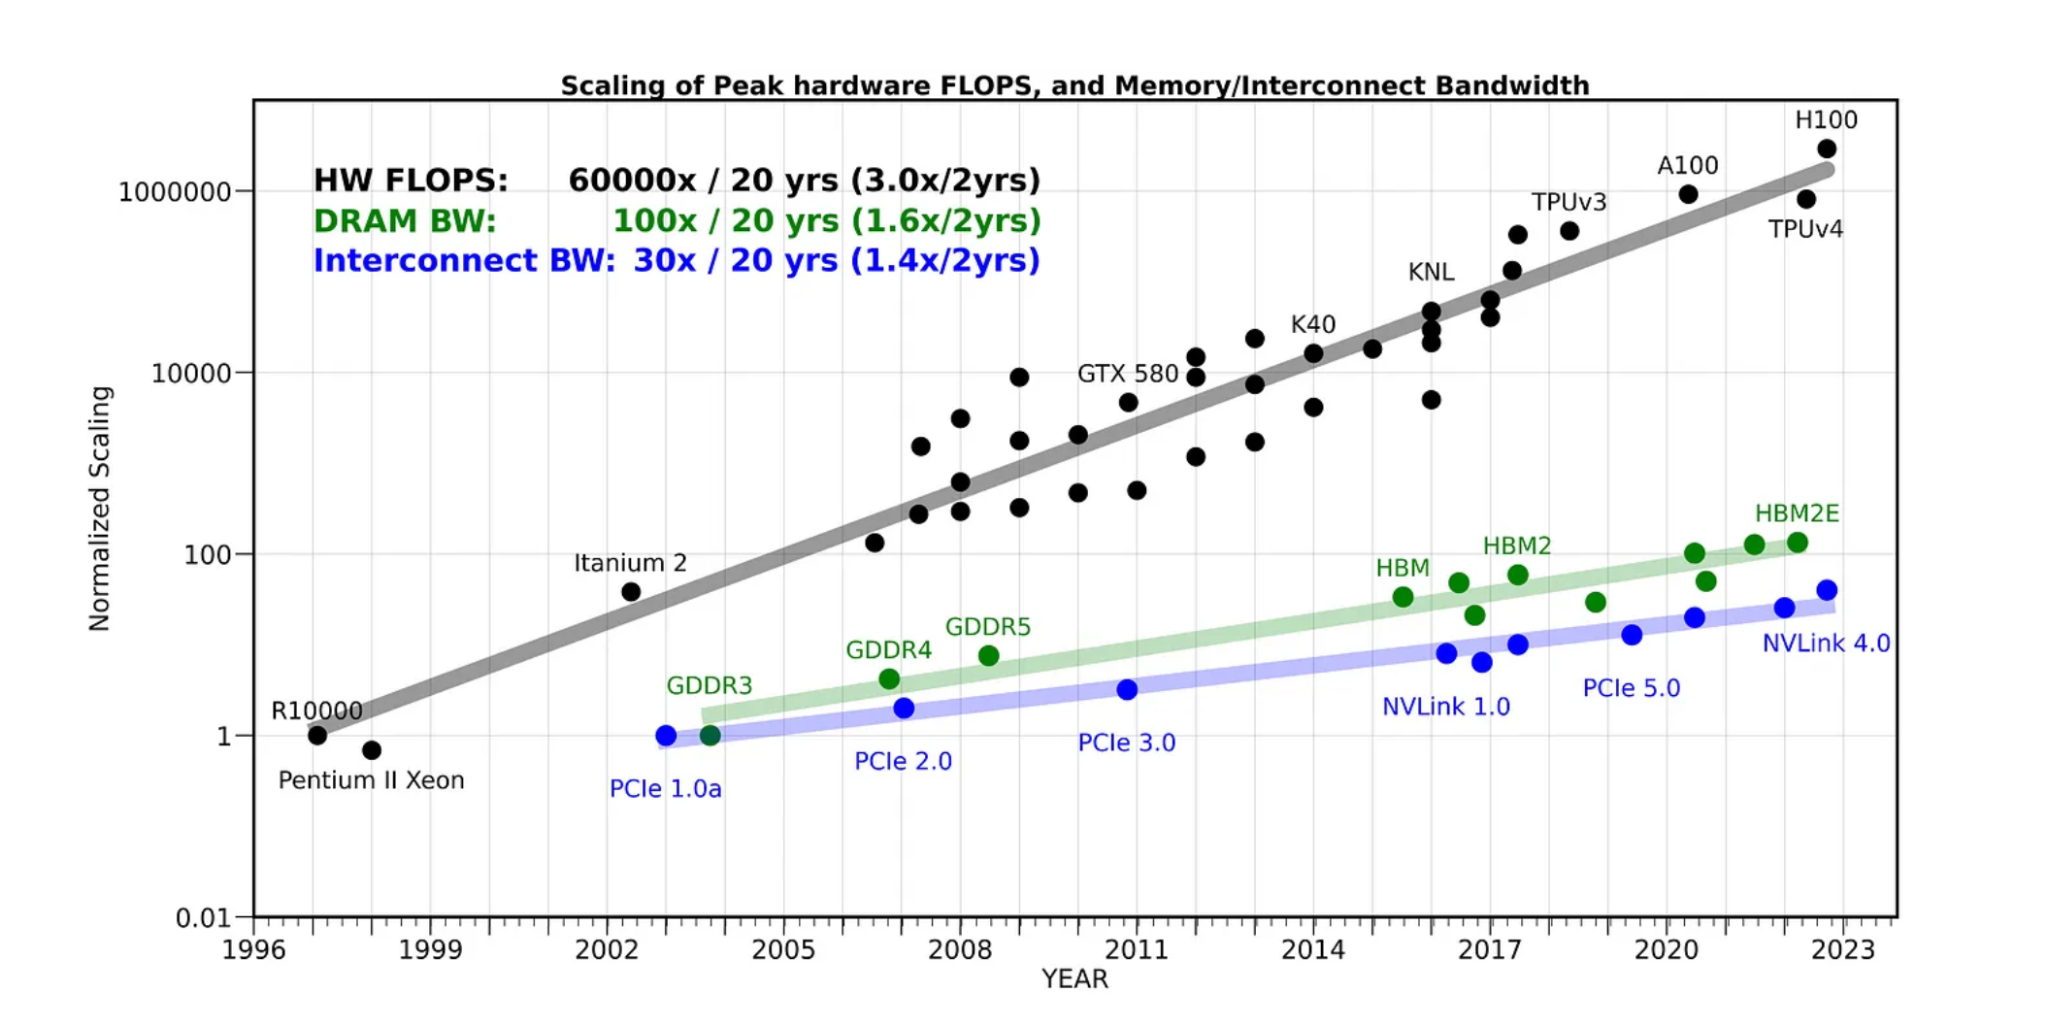
출처: AI and Memory Wall (Gholami et al., 2024)
LLM Inference 최적화 기법들
앞서 본 것처럼 Decode는 연산량에 비해 읽어야 하는 weight와 KV cache가 커서 memory-bound가 되기 쉽습니다. Memory-bound라는 분류 자체가 대역폭 활용률이 낮다는 뜻은 아닙니다. 이미 HBM bandwidth를 충분히 사용하면서도 전송해야 할 byte 수 때문에 실행 시간이 제한될 수 있습니다. 따라서 최적화는 weight·KV cache의 재사용을 늘리고, 전송량을 줄이며, 여러 request를 묶어 arithmetic intensity를 높이는 방향으로 진행됩니다. 이 절에서는 Continuous Batching, Speculative Decoding, FlashAttention, PagedAttention과 model 경량화를 살펴봅니다.
Continuous Batching
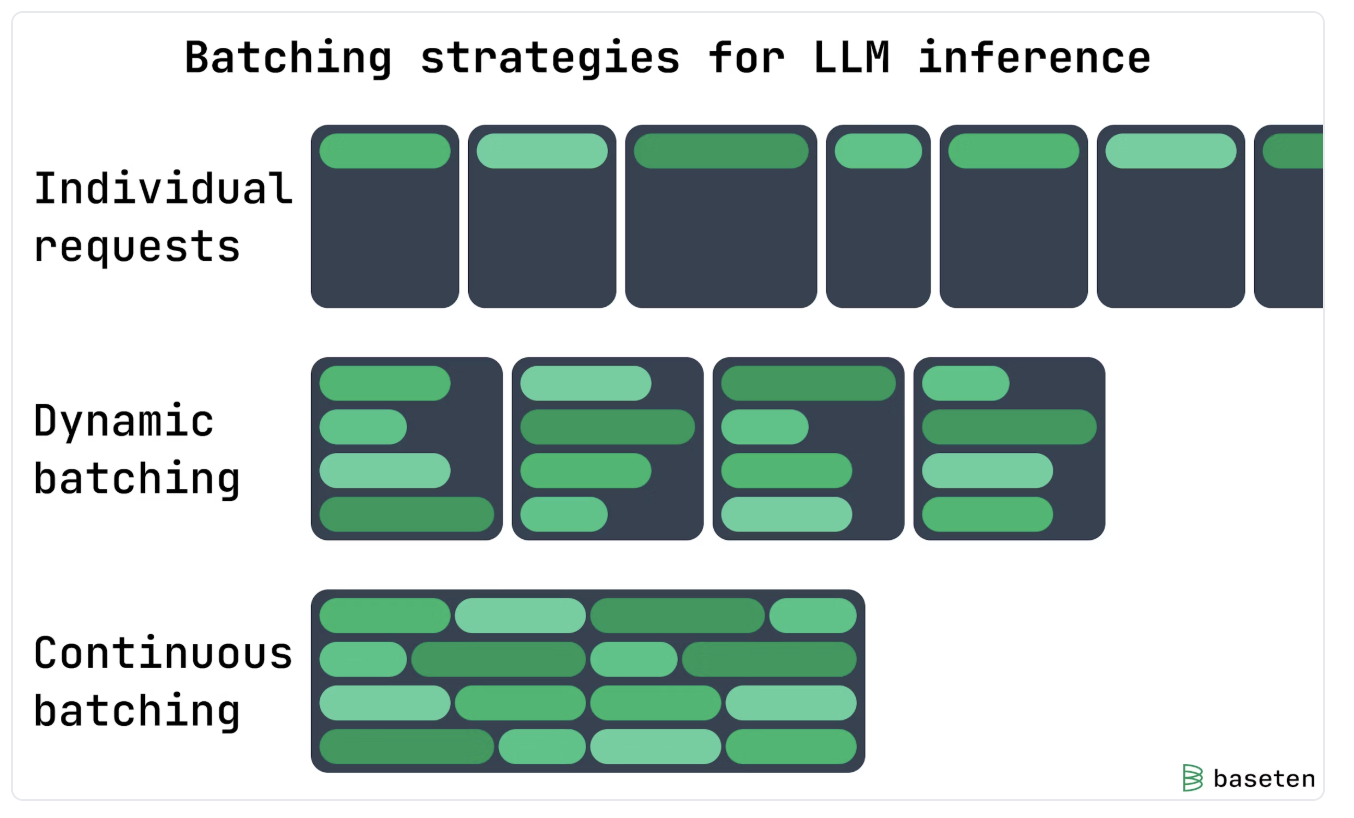
지금까지는 request 하나를 기준으로 이야기했습니다. 서빙에서는 여러 사용자의 request가 서로 다른 시점에 도착하고, 프롬프트 길이도 응답 길이도 제각각입니다. 그리고 앞서 봤듯 단일 request의 Decode는 weight 전체를 읽고 토큰 하나 분량만 계산합니다. 연산기가 놀고 있으니, 같은 스텝에 다른 request의 decode 토큰을 함께 처리하면 됩니다. weight를 한 번 읽어 개 request에 재사용하면 arithmetic intensity가 배가 됩니다. Prefill에서 토큰들이 weight를 공유하던 것처럼 request들이 weight를 공유합니다. 한 request 안의 토큰들과 달리 request 사이에는 의존성이 없어서 묶는 데 제약도 없습니다. 어떻게 묶을지는 스케줄링의 문제입니다.
가장 단순한 형태가 Static / Dynamic Batching입니다. 여러 request를 묶어서 모든 layer를 lock-step으로 동시에 진행합니다. 메모리 효율은 individual request 처리보다 분명히 올라가지만, 각 request가 얼마나 빨리/느리게 끝날지 미리 알 수 없다는 게 문제입니다. 한 배치의 모든 request가 같은 lock-step으로 가야 하므로, 가장 느린 애가 끝날 때까지 모두 기다려야 하고, 빈 자리가 생겨 원하는 만큼 성능이 안 나옵니다.
Continuous Batching은 스케줄링 단위를 request에서 decode step(iteration) 하나로 낮춥니다. 매 step이 끝날 때마다 끝난 request는 빼고 대기 중인 request를 끼워 넣어, 다음 step에서 처리할 토큰들을 그때그때 다시 묶습니다. 시퀀스 길이가 서로 달라도 빈 슬롯이 바로 채워지므로 lock-step 방식의 낭비가 거의 없어집니다.
대표적인 출발점은 서울대 전병곤 교수님의 Orca 논문이고, 이 기술을 기반으로 설립된 회사가 Friendli AI입니다. 현재 Continuous Batching은 LLM 서빙에서 사실상 필수 기술이 되었습니다.
배치 크기에는 상한이 있습니다. 배치가 커져 임계 intensity를 넘어 compute bound에 들어서면 그 뒤로는 throughput 이득이 급격히 줄어드는 반면, 한 스텝에 처리할 일이 많아져 토큰당 지연시간은 계속 늘어납니다. 그래서 실제 서빙에서 배치 크기는 throughput과 latency SLO 사이에서 고르는 트레이드오프 파라미터가 됩니다.
Speculative Decoding
앞서 Decode는 “한 토큰이 끝나야 다음 토큰을 시작할 수 있다 → 병렬화 불가”라고 했습니다. Speculative Decoding은 이 제약을 우회하기 위해 등장한 기법입니다.
큰 모델과 작은 모델이 있다고 할 때, 작은 모델이 큰 모델만큼 정확하지는 않더라도 그렇게 크게 뒤떨어지지는 않는다고 가정해 봅시다. 그렇다면 다음과 같이 두 단계로 일을 나눌 수 있습니다.
- 작은 모델(Draft Model) 로 여러 토큰의 초안을 빠르게 생성한다.
- 큰 모델(Target Model) 로 그 초안이 맞는지 검증만 한다.
검증 단계는 Prefill과 같은 구조입니다. Prefill을 병렬로 처리할 수 있었던 이유는 “어떤 토큰들을 처리할지 이미 정해져 있는 상태에서 동시에 통과시킬 수 있기” 때문이었죠. 검증해야 할 토큰들도 draft가 미리 만들어 둔, 이미 정해진 토큰 시퀀스이기 때문에 큰 모델이 이를 한 번의 forward pass로 동시에 검증할 수 있습니다.
검증 결과는 두 갈래입니다.
- 모든 토큰이 큰 모델의 예측과 일치 → 전부 accept, 그만큼 한 번에 진척
- 중간 어딘가에서 불일치 → 그 지점 이전까지만 accept하고, 불일치한 자리에는 큰 모델이 같은 forward pass에서 이미 계산해 둔 자기 예측 토큰을 넣습니다(아래 그림의 “Glitters”). 그 뒤 토큰은 폐기하고 거기서부터 다시 draft → 검증을 반복합니다. 그래서 한 번의 검증마다 최소 1개 토큰은 반드시 진행됩니다. (위 설명은 greedy 기준이고, sampling에서는 rejection sampling으로 큰 모델의 분포를 그대로 보존합니다.)
작은 모델이 통계적으로 충분히 의미 있게 동작하기 때문에 실제 효율도 높은 편입니다. Speculative Decoding은 batching과 달리 한 request 안에서 생성을 검증 문제로 바꿔, Prefill처럼 여러 토큰을 동시에 처리합니다.
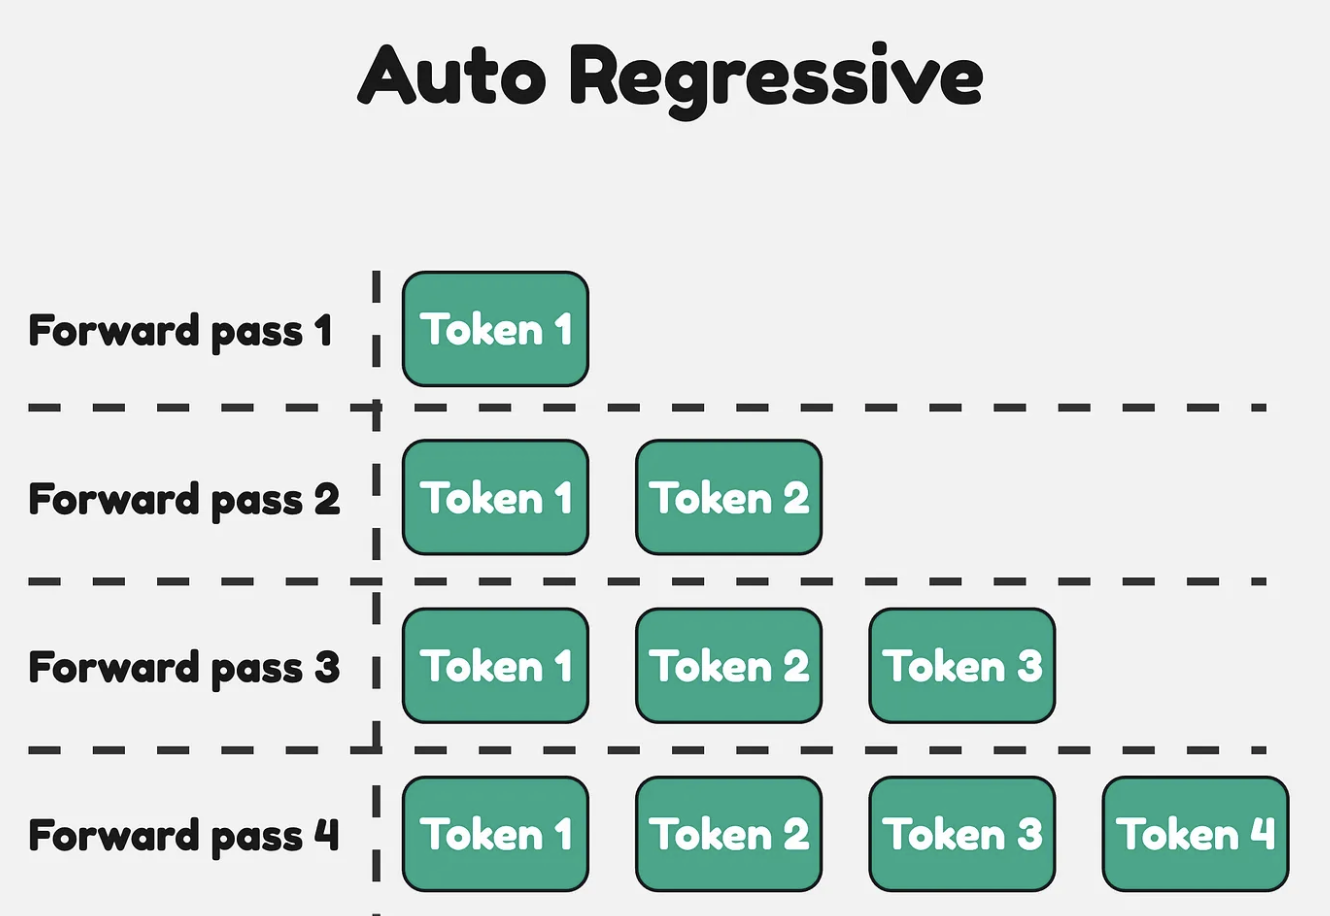
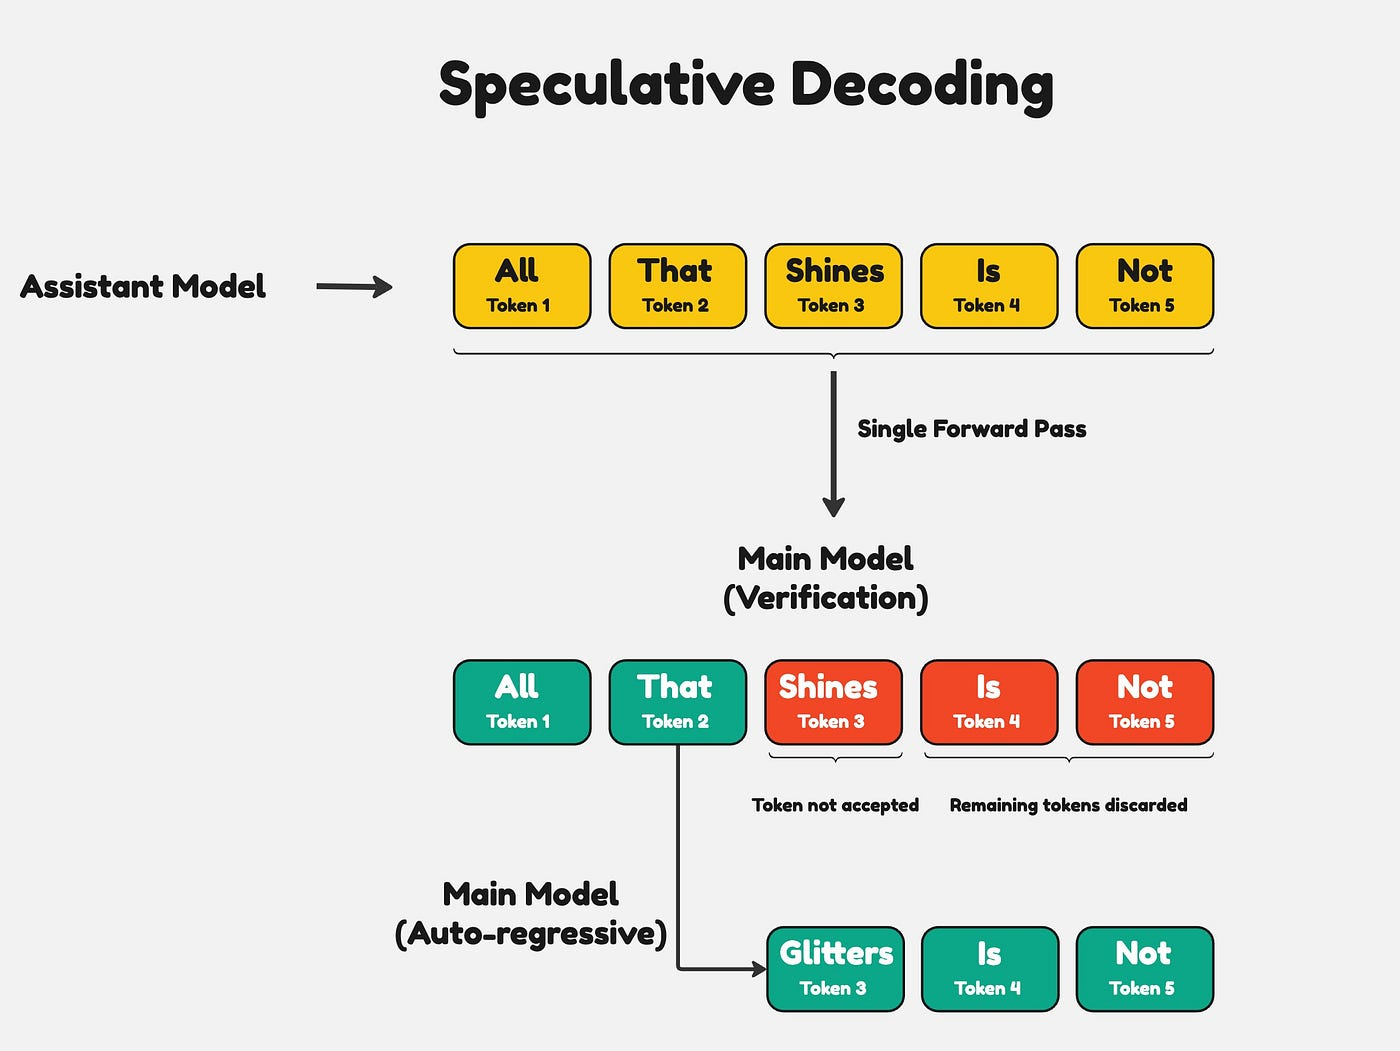
별도의 작은 Draft Model을 두는 방식은 speculative decoding의 고전적인 형태이고, 초안을 만드는 방식은 계속 바뀌고 있습니다. 최근에는 별도 모델 대신 타깃 모델 자체에 다음 여러 토큰을 미리 예측하는 head를 붙여 draft로 쓰는 MTP(Multi-Token Prediction, DeepSeek-V3 계열이 대표적)나, semi-autoregressive draft에 서빙 부하에 따라 검증량을 조절하는 confidence-scheduled verification을 결합한 DeepSeek의 DSpark 같은 변형이 등장했습니다. 형태는 달라도 “빠르게 초안 생성 → 큰 모델이 병렬 검증”이라는 골격은 같고, draft 품질(accept율)과 검증 효율을 높이는 쪽으로 발전하고 있습니다.
Attention의 비용 문제
Continuous Batching과 Speculative Decoding은 Decode를 Prefill처럼 병렬로 처리하는 기술입니다. 병렬화와 별개로 Attention 연산 자체가 비싸고, 시퀀스가 길어질수록 그 비용이 빠르게 커집니다.
마지막 토큰 하나를 처리하려면 그 전까지 생성된 모든 토큰으로부터 입력을 가져와 Attention을 다시 계산해야 합니다. 한 토큰당 비용이 이고, 그걸 번 반복하니 시퀀스 전체의 누적 시간은 입니다. 즉 시퀀스 길이 이 두 배가 되면 attention에 들어가는 누적 시간은 4배, 읽어야 하는 KV cache 메모리는 2배로 늘어나는 구조입니다. 컨텍스트가 길어지는 추세를 생각하면, 이 자승 항을 어떻게 다루느냐가 LLM 추론 효율의 또 다른 중요한 축이 됩니다.
Flash Attention
이 비용 문제를 다루는 대표적인 기법이 Flash Attention입니다. Flash Attention은 Attention의 복잡도를 줄이지 않습니다. 자승 항은 그대로 두고 더 효율적으로 처리합니다. 도구는 Tiling과 Fusion 두 가지입니다.
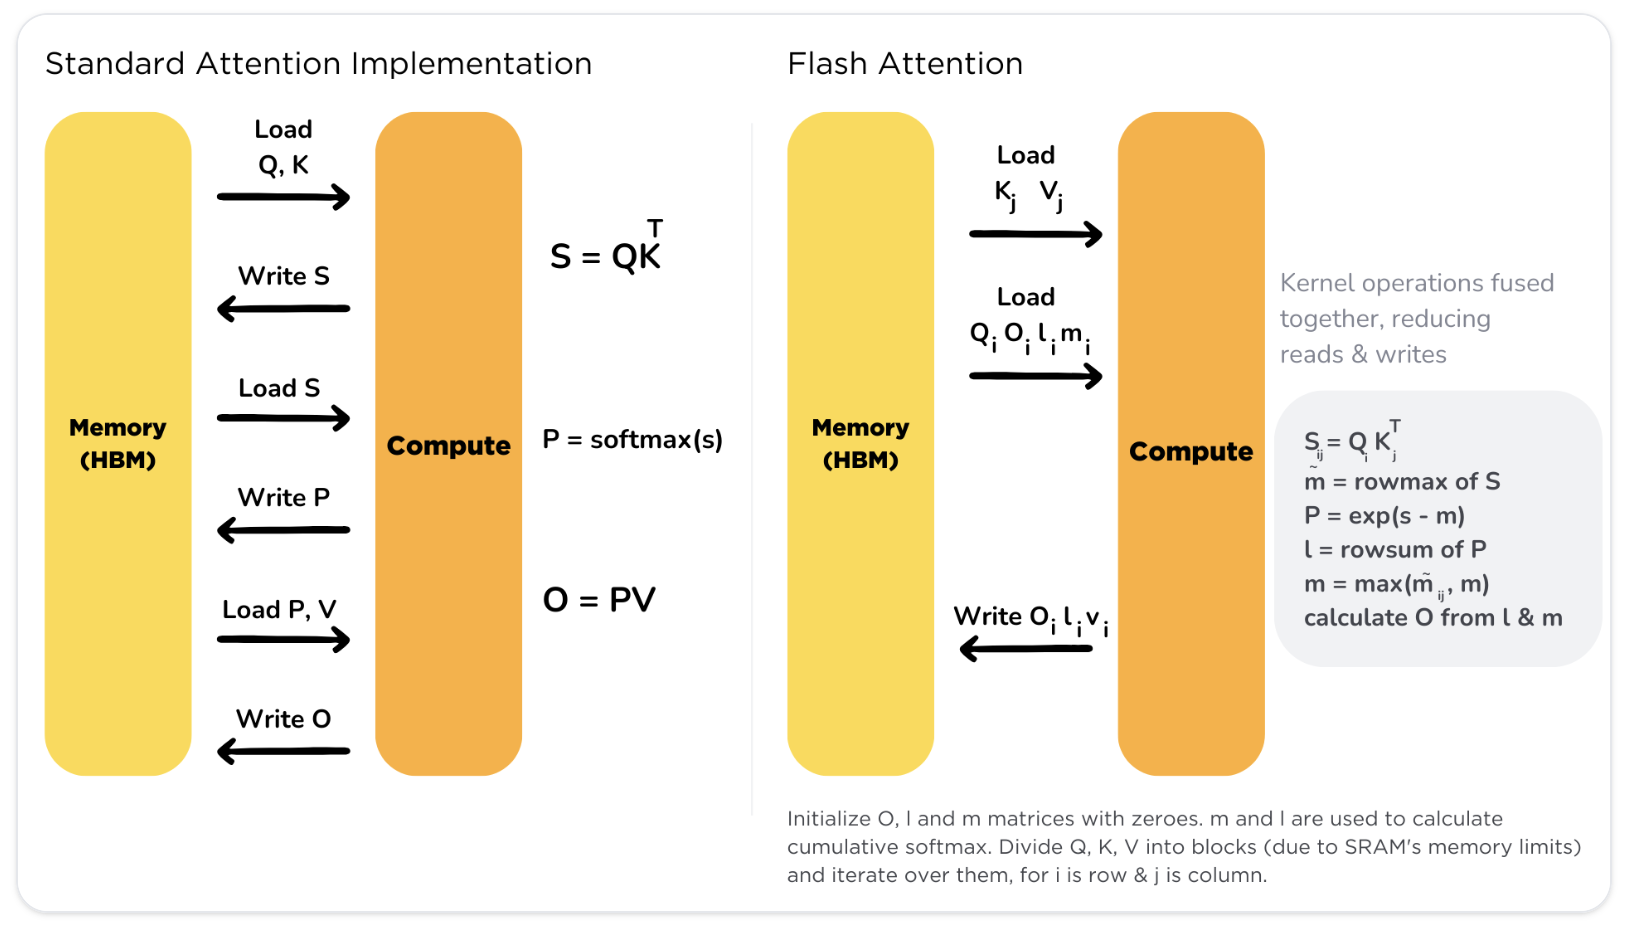
기존 Attention 구현의 가장 큰 비효율은 계산 도중에 외부 메모리(DRAM)로부터 데이터를 반복해서 들고 오고, 내보내고, 다시 들고 오는 과정에서 발생합니다. Attention은 여러 단계의 연산(QK 곱, softmax, V 곱, 합산)으로 이뤄져 있는데, 단계마다 중간 결과를 DRAM에 한 번 썼다가 다음 단계에서 다시 읽는 일이 반복되면 그 자체가 큰 오버헤드가 됩니다.
Flash Attention은 이를 타일 단위로 쪼개서(tiling), 한 타일을 처리하는 동안에는 데이터를 칩 안의 on-chip 메모리(shared memory/SRAM)에 한 번만 올려놓고 안에서 모든 단계를 끝까지 끌고 간 뒤(=fusion), attention score 행렬은 DRAM에 아예 쓰지 않고 출력 타일만 내보냅니다(FA1은 K/V block마다 출력과 통계량을 갱신하고, FA2부터는 Q block당 한 번 씁니다). 중간 행렬의 DRAM 왕복이 사라지기 때문에 같은 연산이라도 실행 속도와 메모리 사용량이 크게 좋아집니다.
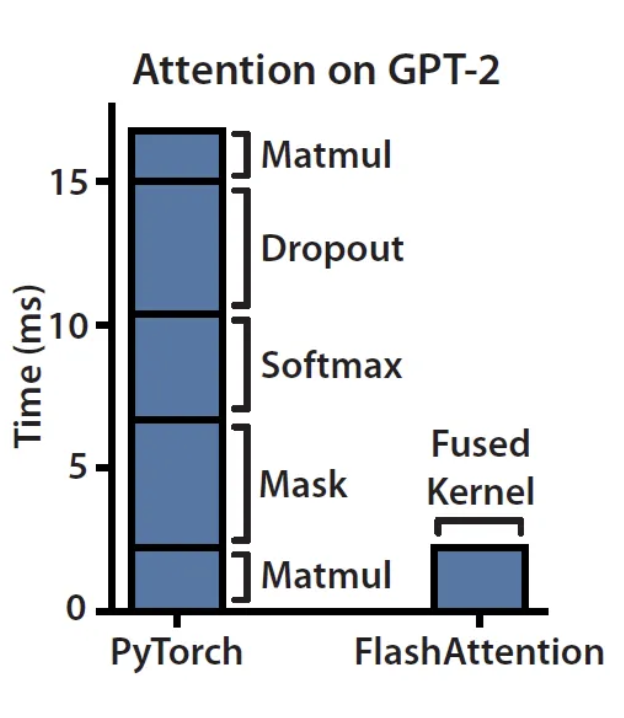
오른쪽 막대그래프가 그 효과입니다. GPT-2 attention에서 PyTorch 구현은 matmul·mask·softmax·dropout이 각각 따로 돌아 약 17ms인데, FlashAttention의 fused kernel은 약 2ms입니다. FLOPs는 오히려 더 많은데도 HBM 왕복이 줄어 빨라진 것입니다.
출처: Flash Attention
출처: FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
Paged Attention
Paged Attention은 긴 시퀀스의 비효율을 KV cache 메모리 할당 쪽에서 다룹니다.
KV cache가 실제로 얼마나 큰지 감을 잡아 보면, 토큰 하나당 저장량은 입니다( = KV head 수, = head dimension, = layer 수, 앞의 2는 K와 V). 예를 들어 LLaMA-13B(MHA)를 bf16으로 8K 컨텍스트까지 돌리면 시퀀스 하나의 KV cache가 약 6.7GB로, 배치 4면 이미 모델 weight(26GB)보다 커집니다. 이런 크기의 버퍼를 어떻게 잡아두느냐가 그대로 서빙 용량을 좌우합니다.
KV cache를 그냥 잡아두려면 기본적으로 max sequence length 기준으로 한 번에 다 할당해 둬야 합니다. 그런데 실제 들어오는 request들은 시퀀스 길이가 제각각이어서, max에 한참 못 미치는 짧은 request들에서는 잡아만 놓고 안 쓰는 메모리 공간이 잔뜩 생깁니다. 이런 “낭비된 슬롯들”(internal fragmentation) 때문에 같은 GPU 메모리(HBM)에서 동시에 처리할 수 있는 request 수가 줄어들어 처리량이 바운드됩니다.
여기에 external fragmentation이 더해집니다. Request마다 KV cache를 연속된(contiguous) buffer로 잡아야 하므로, 길이가 다른 request들이 들어오고 나가기를 반복하면 buffer들 사이에 새 request가 들어가기에는 작은 빈 구간들이 남습니다. 남은 메모리 총량이 충분해도 연속 공간이 없어 할당하지 못하는 것입니다. vLLM 논문의 측정으로는 기존 서빙 시스템에서 KV cache용 메모리 중 실제 토큰 저장에 쓰인 비율이 20.4~38.2%에 그쳤습니다.
Paged Attention은 OS의 virtual memory · paging과 거의 같은 발상으로 이 문제를 풉니다.
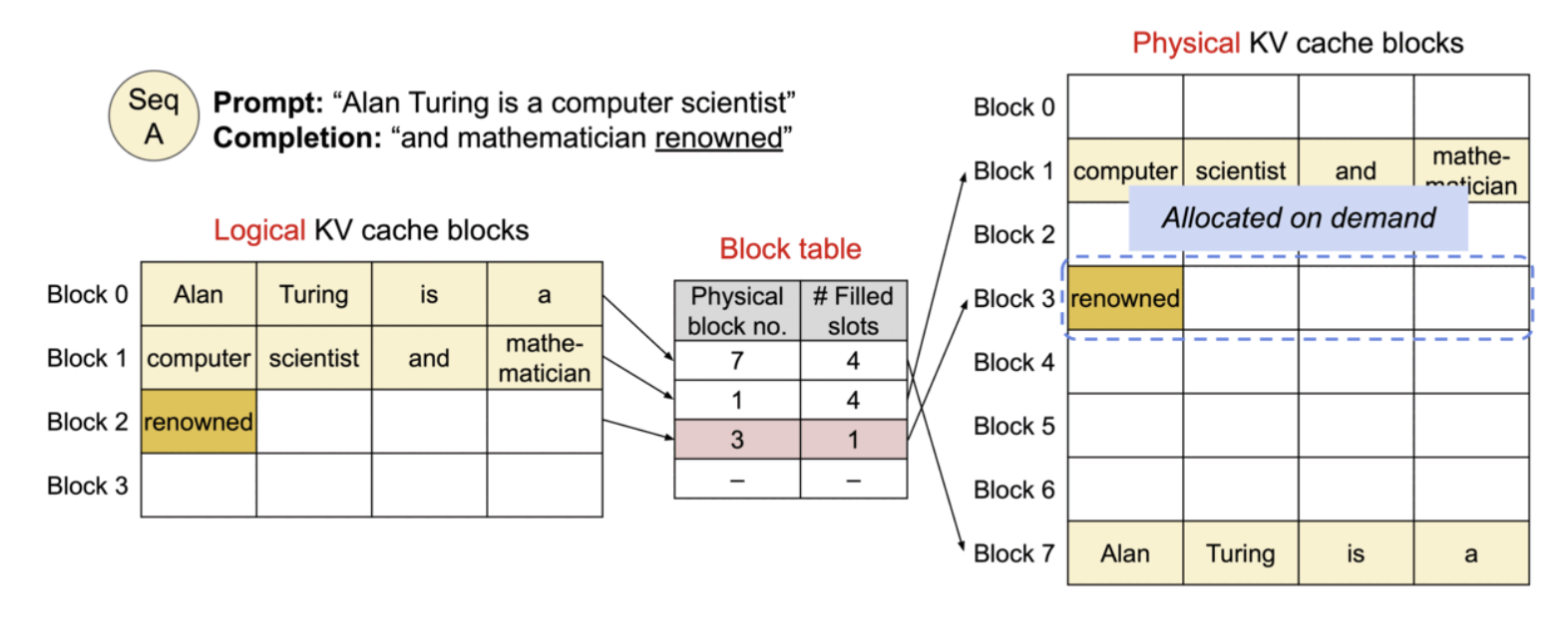
- Logical cache block - request마다 자기 시퀀스를 고정 크기 block(예: 16토큰)으로 나눈 논리적 번호. request 입장에서는 연속된 것처럼 보임
- Physical cache block - GPU DRAM(HBM) 위의 실제 한정된 메모리를 같은 크기로 나눈 block
둘을 decouple해 두고, request마다 block table이 logical block 번호를 physical block 위치로 매핑합니다(OS의 page table에 해당). 실제로 채워진 만큼만 physical block을 할당(on-demand allocation)합니다. Max를 가정한 over-provisioning이 필요 없고, 고정 크기 block은 physical 메모리에서 연속일 필요가 없어 external fragmentation도 사라집니다. 낭비는 각 시퀀스의 마지막 block에 남는 빈 자리 정도로 한정되어, 동시에 처리할 수 있는 request 수가 늘어납니다. 즉 Paged Attention은 attention 연산을 빠르게 하는 기법이 아니라 KV cache 메모리 관리 기법입니다. block 단위로 흩어진 KV를 읽어야 해서 attention kernel 자체는 논문 측정에서 FasterTransformer 대비 20–26% 느리지만, 같은 메모리에 더 많은 request를 담아 throughput은 2–4배 올라갑니다.
출처: Efficient Memory Management for Large Language Model Serving with PagedAttention
모델 경량화
이 외에도 Quantization(양자화) 이나 Sparsity(희소성) 같은 모델 압축 기술 역시 메모리 overhead를 줄이는 데 함께 활용됩니다. (이 강의에서 자세히 다루지는 않습니다.)
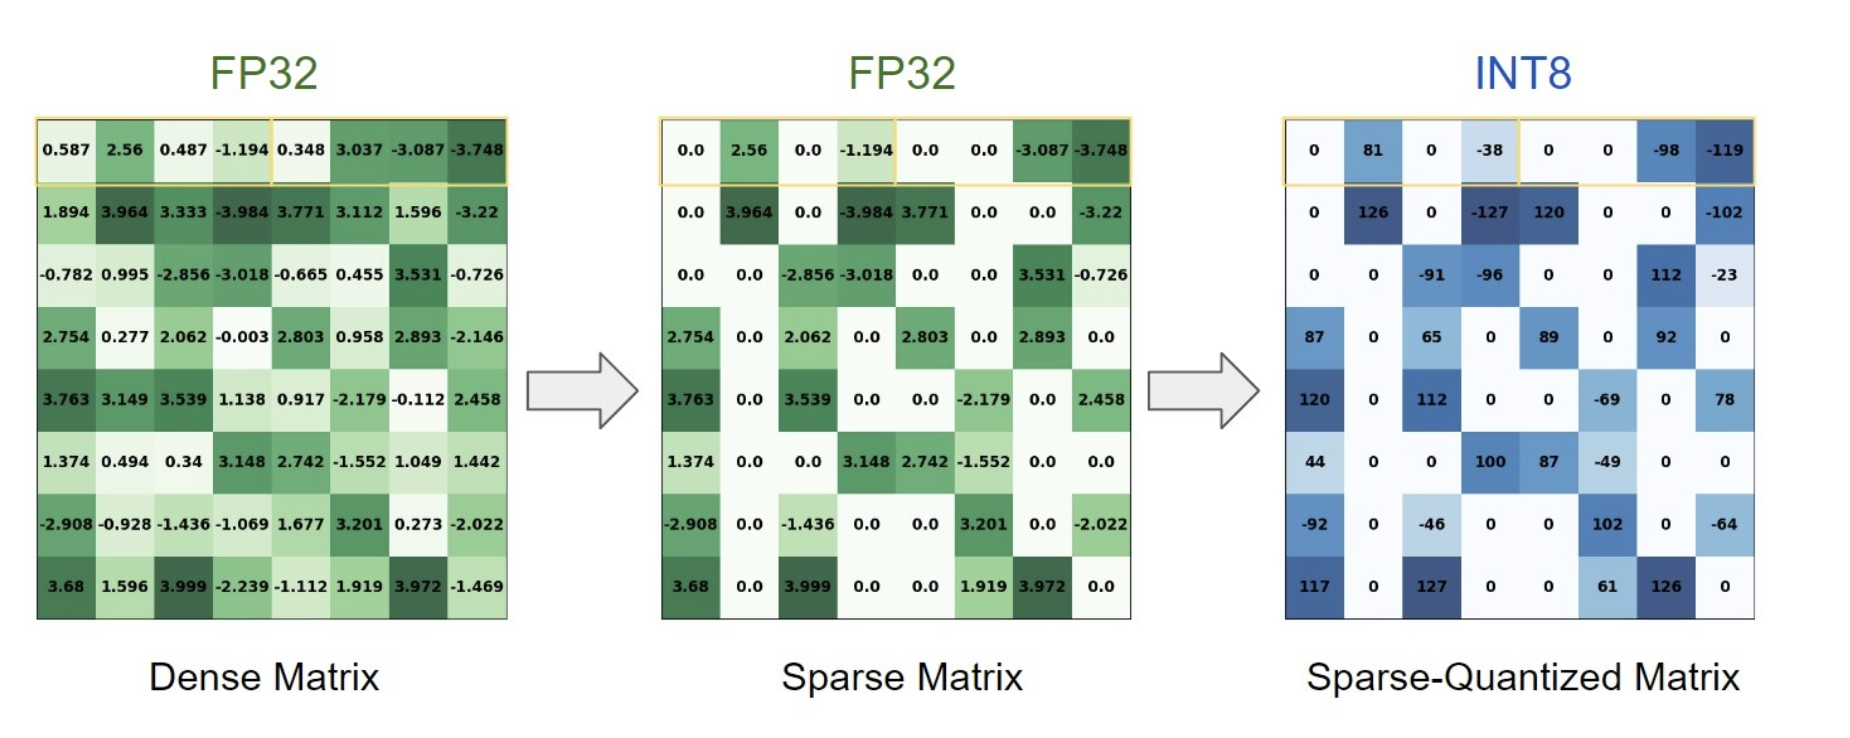
출처: Sparsity in INT8: Training Workflow and Best Practices for NVIDIA TensorRT Acceleration
Kernel Programming
Flash Attention과 IO-Aware 알고리즘
FlashAttention 같은 알고리즘은 GPU의 memory hierarchy와 실행 방식을 직접 고려합니다. 일반적인 PyTorch 코드는 미리 정의된 op을 조합하며, 각 op의 kernel 내부 tiling이나 op 사이 중간 tensor의 저장 위치를 직접 지정하지 않습니다. Compiler가 op들을 fuse하거나 scaled_dot_product_attention이 fused backend를 선택할 수는 있지만, 새로운 fused algorithm 자체를 구현하려면 더 낮은 수준의 kernel programming interface가 필요합니다.
그래서 PyTorch op보다 낮은 수준의 API로 커널을 직접 작성하고, 이를 Custom Op으로 wrap해 PyTorch에 다시 노출합니다. 다음 절들에서 다룰 Kernel Programming이 이 작업입니다.
Flash Attention이 가정하는 GPU 모델은 세 가지 요소로 이루어져 있습니다.
- Grid - 커널 하나를 실행할 때 띄우는 thread block들의 집합. 각 block은 SM 하나에 배정되어 병렬로 실행됨
- DRAM - 외부 메모리. 용량은 크지만 대역폭이 상대적으로 낮음
- Shared Memory - 블록별로 할당되는 온칩 메모리. 용량은 작지만 대역폭이 훨씬 높음
같은 데이터라도 DRAM에서 계산하는 것보다 Shared Memory에 한 번 올려놓고 그 안에서 계산하는 편이 훨씬 빠릅니다. Flash Attention은 DRAM에 있는 입력과 중간 데이터를 타일 단위로 쪼개 Shared Memory에 올리고, 곱·합 연산은 Shared Memory의 높은 대역폭으로 수행합니다.
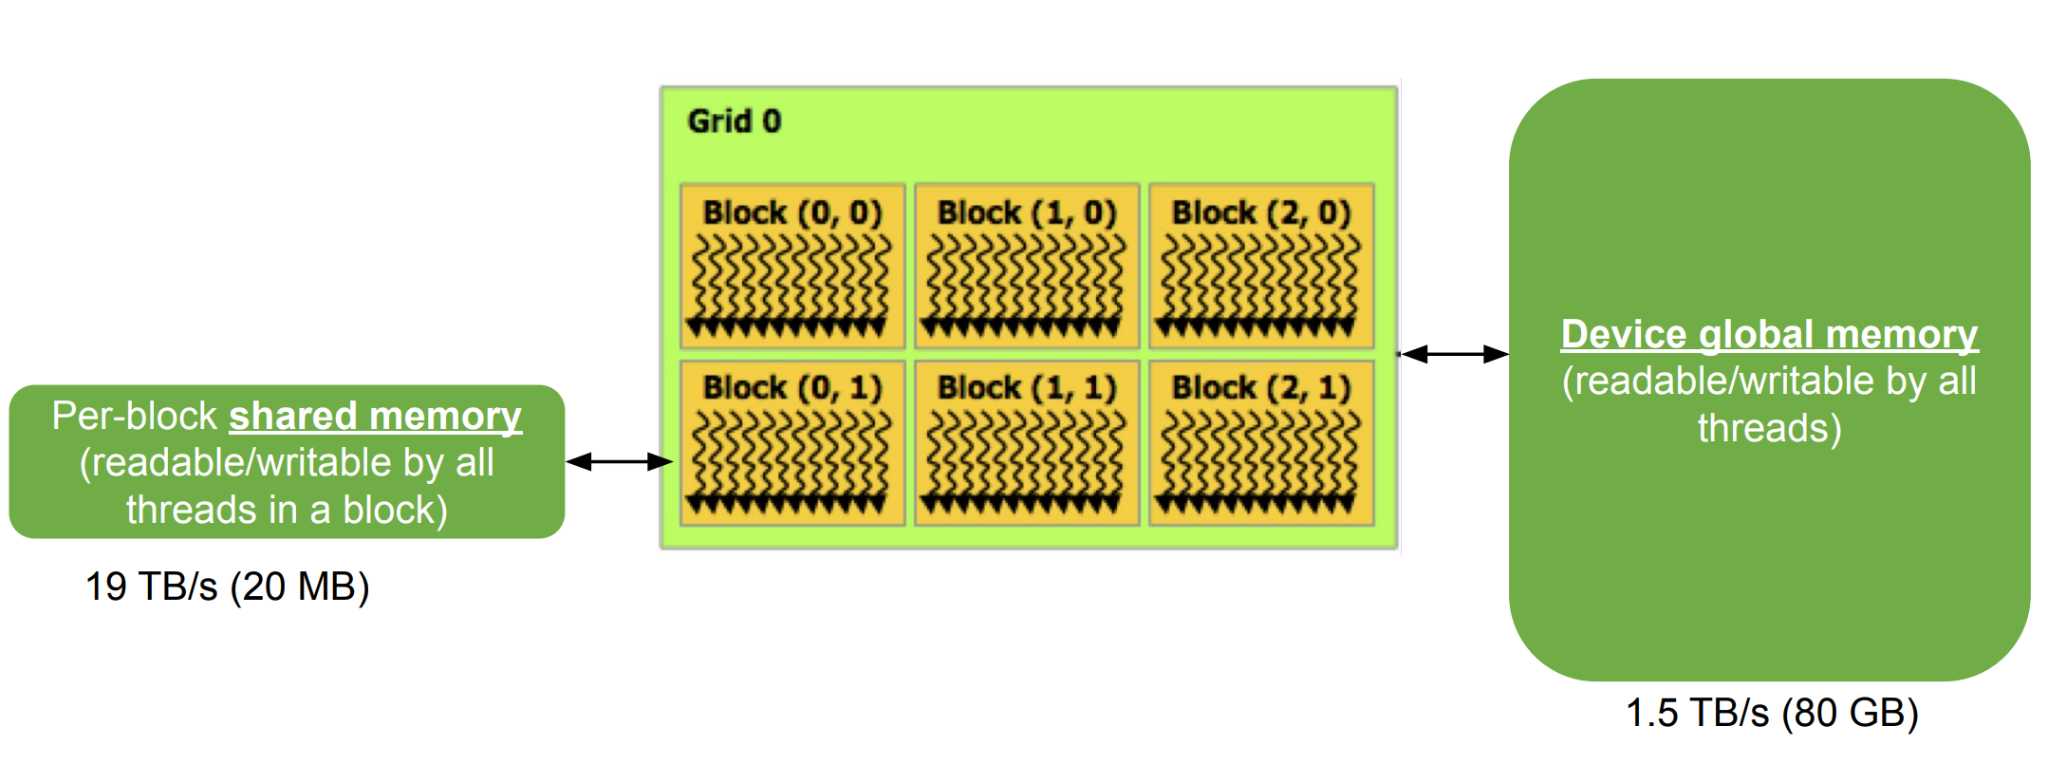
그림의 shared memory 19 TB/s (20 MB)는 A100 SM 전체의 합산치입니다. block 하나가 쓸 수 있는 shared memory는 SM당 최대 163 KB이고, global memory 1.5 TB/s (80 GB)와 비교할 대상은 합산 대역폭입니다.
같은 맥락에서, sequence가 길어질수록 attention 자체가 얼마나 무거워지는지를 한 번에 보여주는 그림은 다음과 같습니다. → mask → softmax → 로 이어지는 전 과정에서 연산량과 메모리 접근량 모두 으로 커집니다.
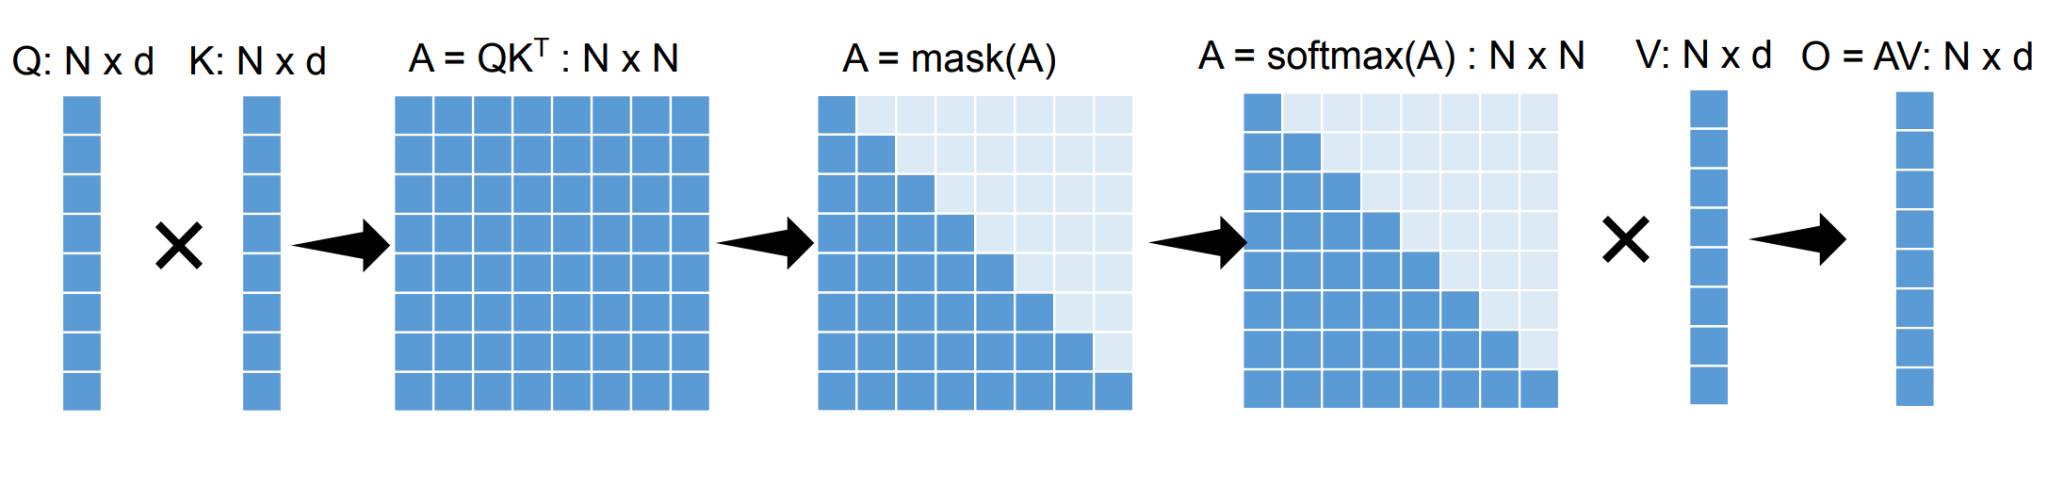
FlashAttention: Tiling, Fusion, Online Softmax
Flash Attention은 앞 절에서 본 비효율을 풀기 위해 두 가지 기법을 적용합니다.
- Tiling - 큰 계산을 작게 쪼개서, 그때그때 필요한 부분만 들고 와서 처리할 수 있게 만들어주는 방법
- Fusion - 한 계산에 필요한 데이터를 Shared Memory에 올려놓은 뒤, 중간 결과를 DRAM에 쓰지 않은 채 가능한 한 많은 연산을 이어서 끝내고 결과만 내보내는 방식
이 둘을 함께 적용해 attention을 다시 짜면, 같은 연산이라도 메모리를 훨씬 효율적으로 사용할 수 있게 됩니다.
Tiling
큰 행렬을 통째로 처리하는 대신, 결과 행렬을 작은 타일로 쪼개고 각 타일을 만드는 데 필요한 입력 조각만 한 번씩 Shared Memory에 올려 곱·누적합니다. 같은 데이터를 여러 번 DRAM에서 다시 읽지 않고 재사용할 수 있어, 메모리 트래픽이 크게 줄어듭니다.
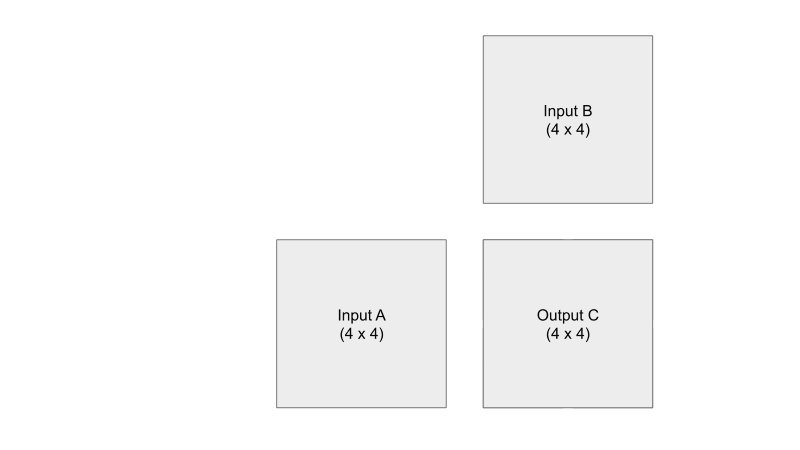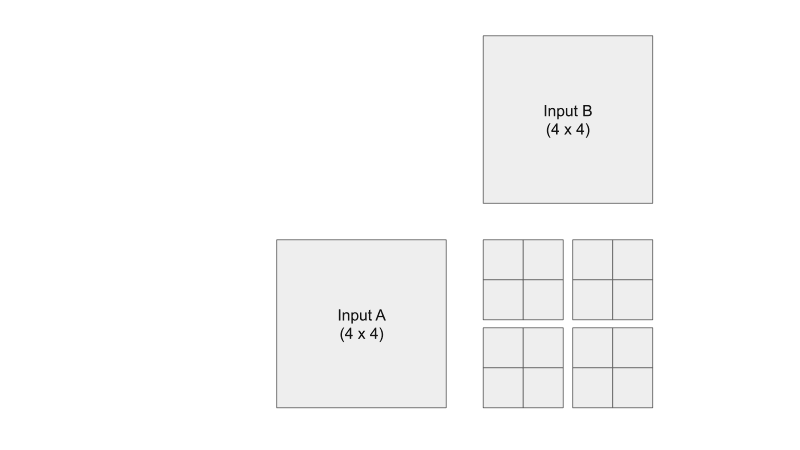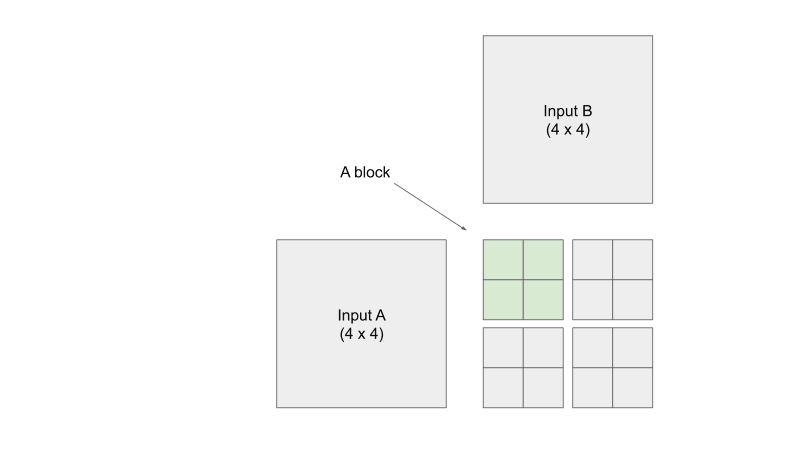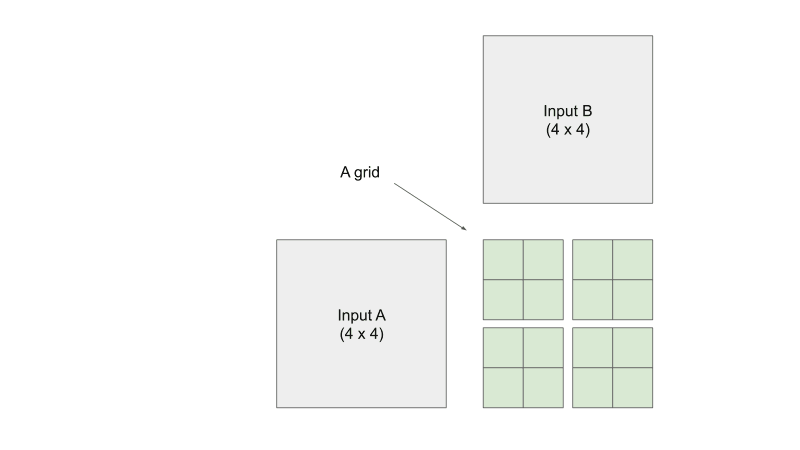
Fusion
여러 op이 한 줄로 이어진 연산 그래프(예: )를 그대로 실행하면, op마다 결과를 DRAM에 썼다가 다음 op이 다시 읽어가는 DRAM 왕복이 반복됩니다. 인접한 op들을 하나의 커널로 합치면(fusion), 중간 결과는 Shared Memory/레지스터 위에 머물고 최종 결과만 DRAM에 한 번 내보낼 수 있습니다.
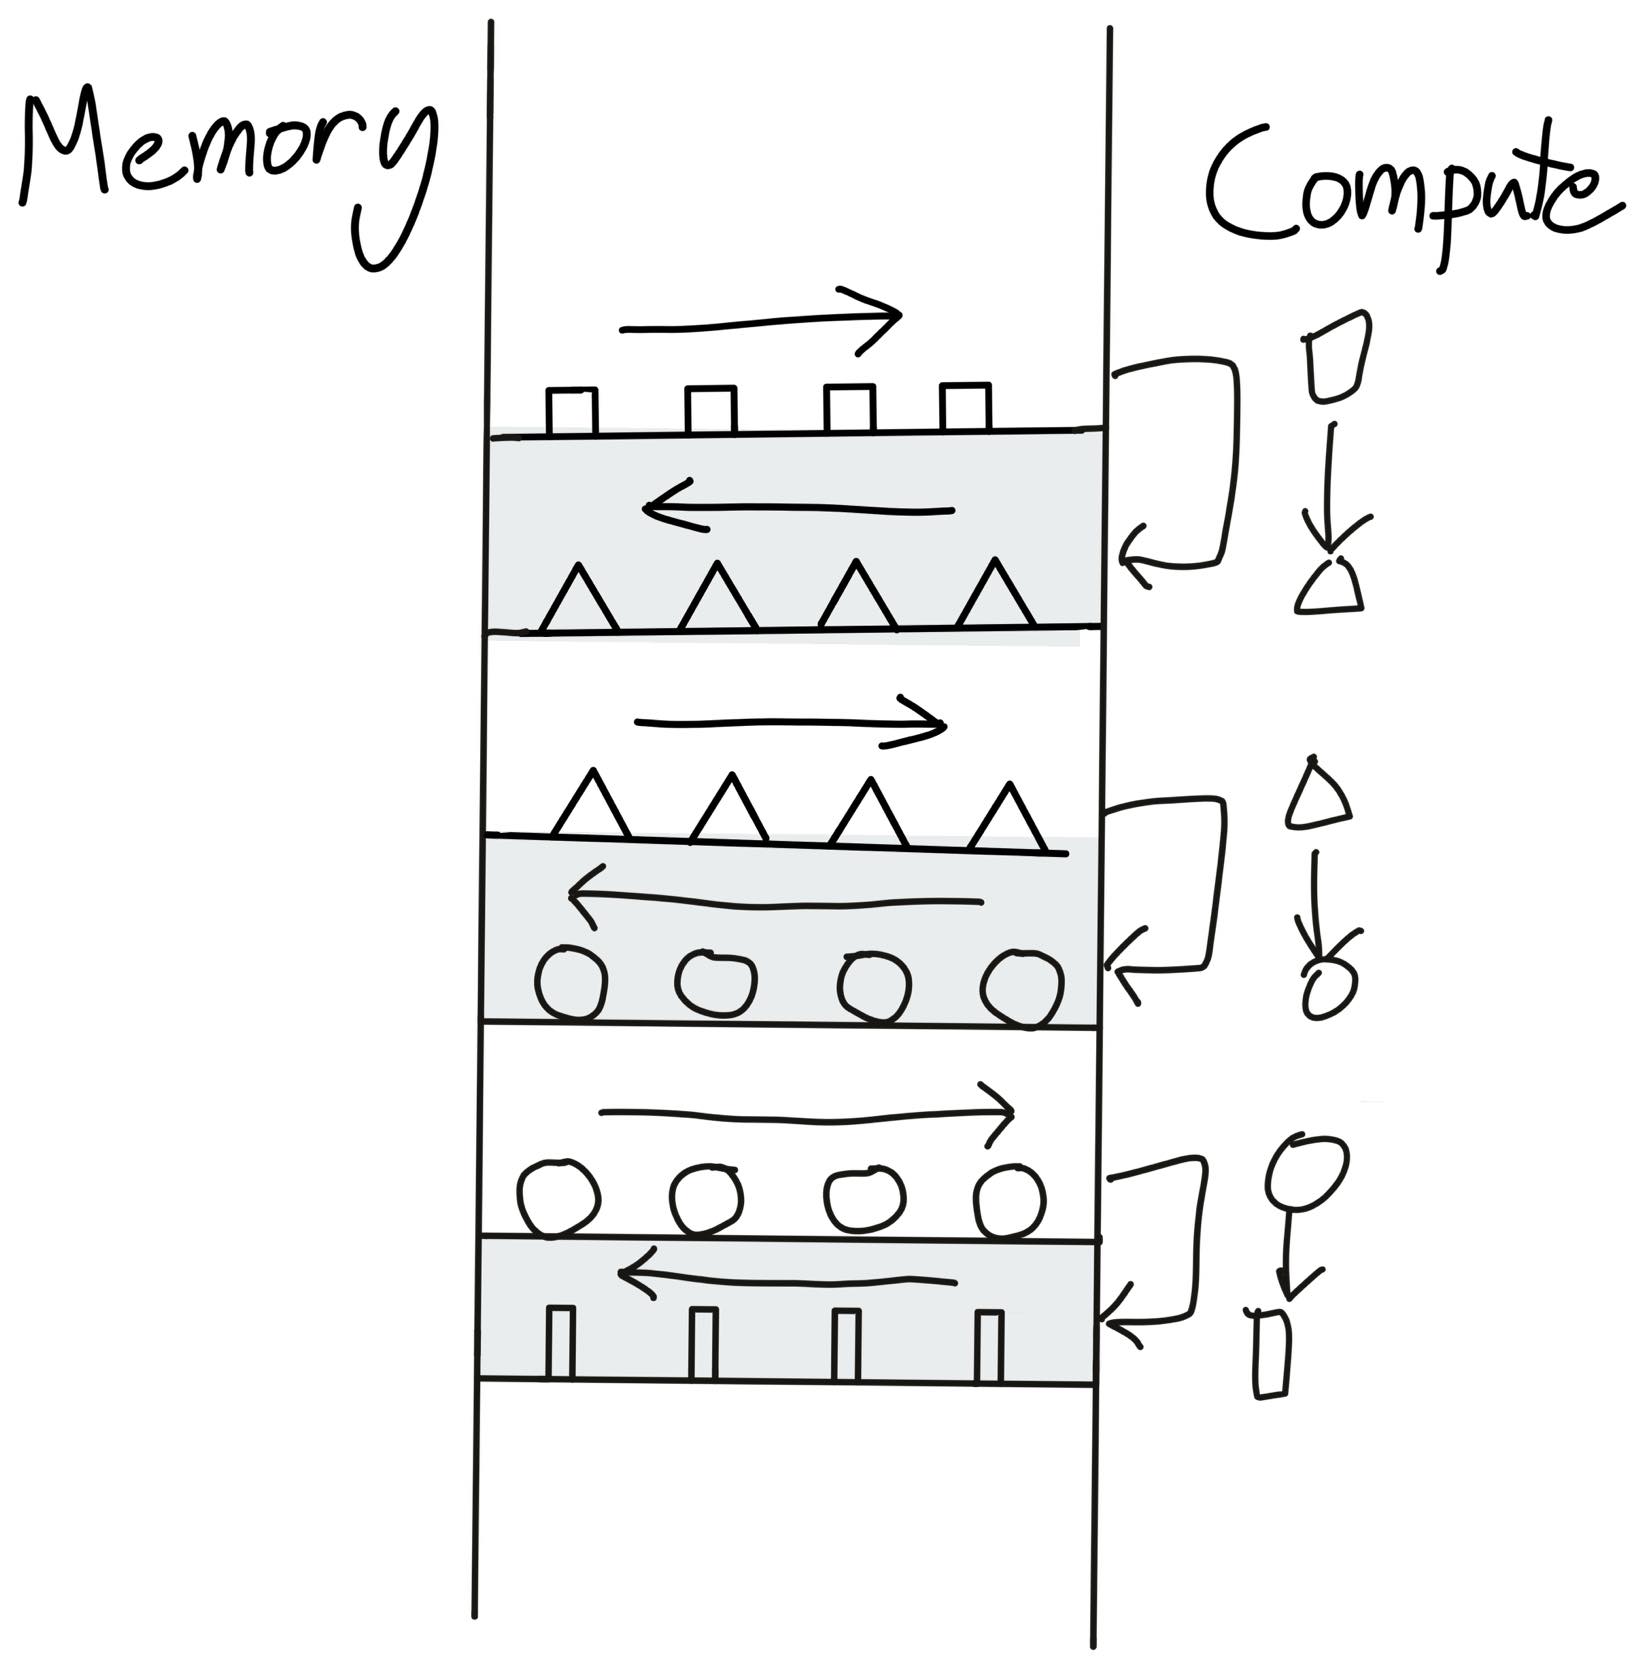
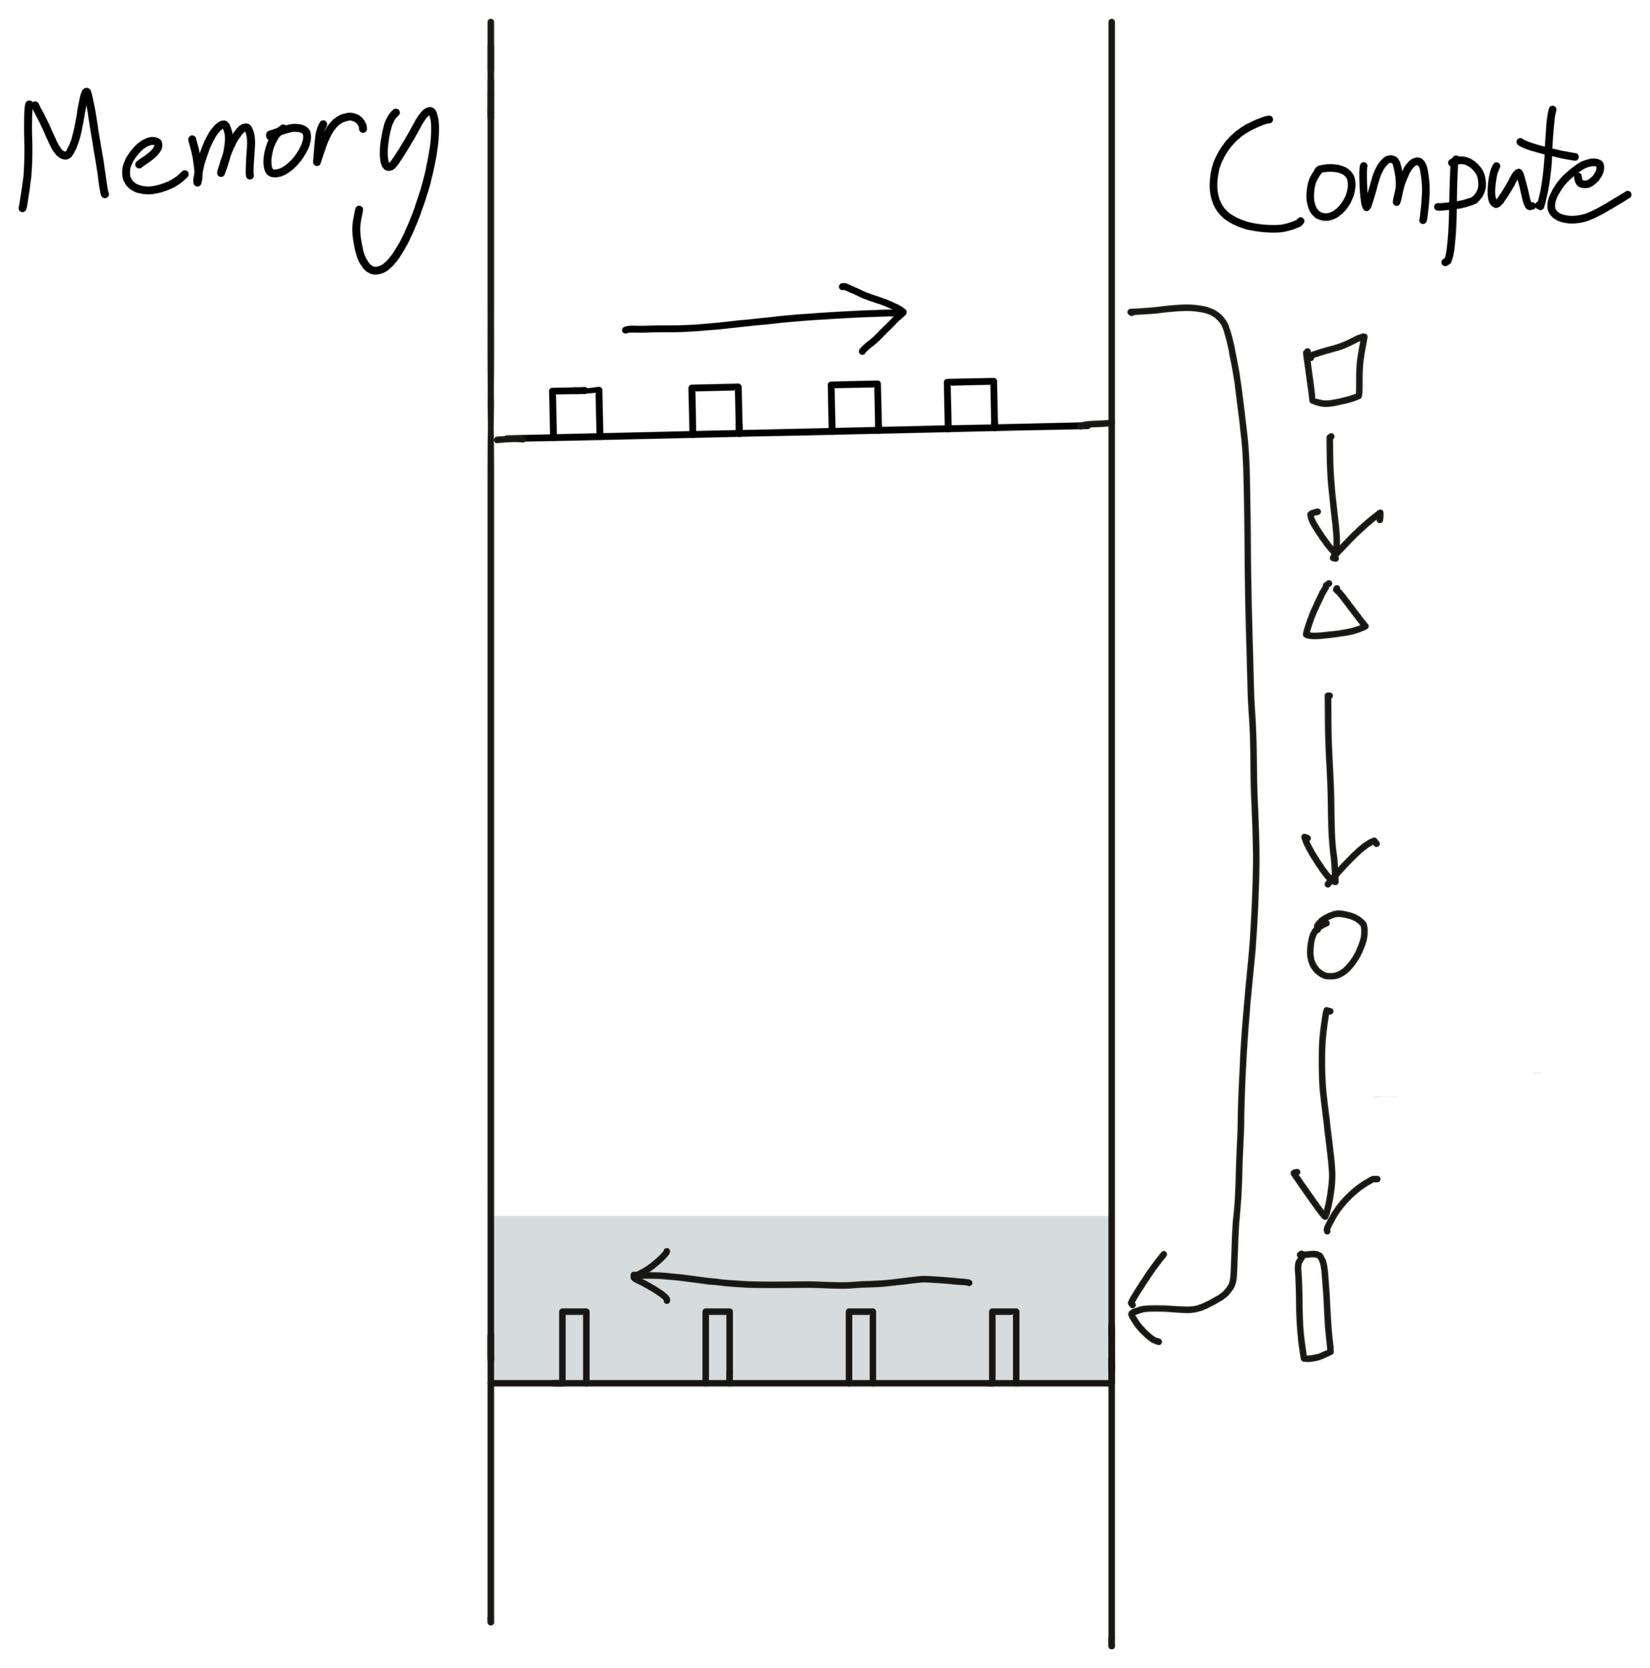
Attention에 적용하기
이제 이 두 도구를 attention에 그대로 얹어 봅시다. Attention 연산 안에서 각 연산이 tiling과 어울리는 정도는 다릅니다.
- 곱셈 (QK, …V): tiling 적용 가능
- Masking: 마찬가지로 tiling 가능
- Softmax: 전체 분포를 봐야 하므로 tiling이 까다로움
앞의 attention 그림에 표시하면 다음과 같습니다.
곱셈과 masking에는 tiling을 바로 적용할 수 있지만, 그 사이의 softmax는 그렇지 않습니다. softmax는 N개 값을 모두 본 뒤 정규화하는 연산이라, 이를 나눠서 부분적으로 계산하는 방법이 Flash Attention의 주된 기술적 과제입니다(다음 절 Online Softmax).
정리
FlashAttention은 tiled matrix multiplication과 online softmax를 하나의 fused kernel 안에서 구성해, attention score 전체를 HBM에 materialize하지 않습니다. 사용자는 PyTorch의 scaled_dot_product_attention을 통해 이러한 fused backend를 사용할 수 있지만, FlashAttention 같은 backend 구현 자체는 CUDA·CUTLASS·Triton과 같은 kernel programming 도구로 작성됩니다.
Softmax의 도전: Online Softmax
먼저 softmax가 무엇이었는지 다시 한 번 정리해 봅시다. 입력 이 주어지면, 각각을 지수 함수()로 변환하고 그 합으로 나눠 합이 1이 되도록 정규화하는 연산입니다.
Naive softmax (2-pass)
가장 직관적인 형태는 다음과 같습니다.
분모의 합을 먼저 구해야 하기 때문에 두 번의 pass가 필요합니다.
- Pass 1 - 메모리에서 를 한 번 읽어 계산 + 누적합 를 구함
- Pass 2 - (또는 )를 다시 읽어 합으로 나눠 최종 계산
즉 같은 데이터를 메모리에서 두 번 읽어야 끝나는 알고리즘입니다.
Safe softmax (3-pass, 수치 안정성 확보)
여기서 또 하나의 문제가 있습니다. 수치 안정성(numerical stability) 입니다. softmax는 가 들어가기 때문에 가 조금만 커져도 값이 폭발적으로 커집니다. float 표현에는 상한이 있어서, exp 결과가 그 상한을 넘으면 overflow로 inf가 되고 분모까지 inf가 되면 결과는 NaN이 됩니다.
회피하는 방법은 생각보다 간단합니다. 모든 입력에서 최댓값 를 빼주는 것입니다. 분자와 분모에 공통 인자 가 곱해진 것이라 약분되어 결과는 변하지 않으면서, 지수의 입력은 항상 으로 묶여 exp 결과가 범위에 머물게 됩니다.
이걸 safe softmax라고 부릅니다. 다만 이번에는 최댓값을 먼저 구하는 pass가 추가로 필요해서 총 3-pass가 됩니다.
- Pass 1 - 를 읽어 계산
- Pass 2 - 를 다시 읽어 의 합 계산
- Pass 3 - 를 다시 읽어 계산
수치 안정성은 보장되지만, 순서대로 따라가면 같은 데이터를 세 번 읽는 알고리즘입니다. 행 하나가 통째로 SRAM에 들어가면 pass 수는 문제가 되지 않습니다. 그러나 attention에서는 한 행의 score 개가 tile 단위로 나뉘어 도착하므로 max와 합을 미리 알 수 없고, 이를 구하려고 다시 읽으면 앞서 본 DRAM 왕복이 생깁니다.
일반적인 softmax (2-pass)
↑ Sum을 구하는 pass가 추가로 필요
Numerical stability를 고려한 safe softmax (3-pass)
↑ Max를 구하는 pass가 추가로 필요
FlashAttention의 single-pass 트릭
FlashAttention은 safe softmax와 같은 결과를 tiling·fusion된 single pass로 구합니다. 이때 쓰는 도구가 online algorithm입니다.
Online algorithm이란 모든 데이터를 한 번에 보고 처리하는 게 아니라, 그때그때 들어오는 값만으로 점진적으로 계산을 보정해 나가는 알고리즘 패러다임을 말합니다. 아이디어는 다음 두 가지입니다.
- 진짜 를 미리 구하지 않는다. 대신 지금까지 본 값 중 최댓값 만 유지한다.
- 새 값이 들어와 가 업데이트되면, 이전 max로 스케일해 두었던 누적 분모를 새 max에 맞게 다시 보정한다.
이 보정 과정만 잘 정의해주면 single-pass로도 safe softmax와 동등한 결과를 얻을 수 있습니다. 이걸 safe softmax의 online 버전이라고 부르고, FlashAttention은 이 아이디어를 그대로 attention 전체로 확장합니다. tile 하나가 들어올 때마다 max를 update하고 누적된 분모와 출력을 그에 맞춰 보정하면, 한 번의 pass로 attention을 끝냅니다. tile 단위로 진행하므로 tiling·fusion도 함께 적용됩니다.
알고리즘을 의사코드로 적으면 다음과 같습니다. (설명을 위해 한 번에 key 하나, 즉 column 하나씩 처리하는 형태로 적었으며, 실제 FlashAttention은 같은 recurrence를 column들의 블록(tile) 단위로 수행하고, 매 step 나누는 대신 정규화 전 값을 누적했다가 마지막에 으로 한 번만 나눕니다. 아래 형태는 Zihao Ye의 노트 From Online Softmax to FlashAttention을 따랐습니다. 기호는 = 지금까지 본 score의 최댓값, = 그 max 기준으로 누적한 분모, = 그 시점까지의 출력(정규화된 상태)이고, 초기값은 , , 입니다.)
Algorithm FlashAttention
for do
end
Q는 모든 step에 동일
, query는 한 row 고정
K는 번째 column만 읽어들임
, 순차 streaming load (실제 구현은 tile 단위)
매 step마다 max값 update
Update된 max값으로 보정
를 로 rescale
최종 결과를 DRAM에 저장
, single write
이렇게 하면 수치 안정성을 유지한 single-pass tiled·fused 알고리즘이 됩니다.
이 과정 전체를 요약하면 FlashAttention은 attention 계산 순서를 재구성해 HBM read/write를 줄인 알고리즘입니다. QK matmul, masking, softmax, value matmul을 각각 실행하면 attention score 같은 중간 tensor가 materialize될 수 있습니다. FlashAttention v1은 이 단계를 tiled·fused kernel로 구현해 중간 tensor의 HBM 왕복을 줄였습니다. 현재 PyTorch의 scaled_dot_product_attention은 조건에 따라 FlashAttention 계열을 포함한 fused backend를 자동 선택할 수 있습니다.
FlashAttention의 진화: v1 → v2 → v3 → v4
버전별 진화는 다음과 같이 정리할 수 있습니다.
Standard attention
Low utilization
FlashAttention v1
Tiling
Fusion
25–40% utilization
FlashAttention v2
Fewer non-matmul FLOPs
Better warp partitioning
50–73% utilization
FlashAttention v3
Optimized for Hopper
(async copy · low-precision)
~75% utilization
FlashAttention v4
Optimized for Blackwell
(softmax 재설계 · 새 pipelining)
B200: cuDNN 1.3× · Triton 2.7×
v1: CUDA 기반의 첫 구현
FlashAttention v1은 NVIDIA Apex의 FMHA 커널(CUTLASS 2.x 기반)을 출발점으로 CUDA로 구현되었습니다. Standard Attention 대비 속도는 분명히 빨라졌지만, GPU utilization은 A100 기준 이론 최대 FLOPs/s의 25–40%에 그쳤습니다.
v2: CUTLASS로 warp 파티셔닝 개선
FlashAttention v2는 CUTLASS를 사용합니다. CUTLASS는 CUDA 위에 올라간 C++ template 라이브러리로, NVIDIA GPU의 하드웨어 구조(warp2, Tensor Core의 행렬곱 명령인 MMA(Matrix Multiply-Accumulate) 등)를 템플릿 형태로 모델링해 두어 코드 자체를 GPU 파이프라인에 맞춰 짤 수 있게 해줍니다. v2는 CUTLASS 3.x와 그 core 라이브러리 CuTe 위에서 warp 단위 분할(warp partitioning)을 훨씬 정교하게 설계하고 softmax 쪽의 non-matmul FLOPs를 줄였습니다. 그 결과 GPU utilization을 50–73%까지 끌어올렸습니다.
v3: Hopper의 새 기능 활용
이후 NVIDIA Hopper 아키텍처가 등장하면서 새로운 기능들이 추가됐습니다. 저정밀(low-precision) 연산 지원 강화, 비동기 데이터 복사(TMA3)와 warp 4개(warpgroup)가 함께 발행하는 비동기 Tensor Core 연산(WGMMA, Warpgroup MMA) 등이 그 예입니다. 그런데 v2를 그대로 Hopper에서 돌리면 이 새 기능들을 활용하지 못해 utilization이 오히려 30%대로 떨어집니다. 이를 다시 끌어올리려고 새로 짠 것이 FlashAttention v3이고, Hopper에서 utilization을 약 75%까지 회복했습니다.
v4: Blackwell 세대, 그리고 CuTe DSL
FlashAttention v4는 Blackwell(그리고 Hopper)을 타깃으로 다시 작성된 버전으로, Hot Chips 2025에서 처음 공개되었습니다. 구현 언어는 C++ CUTLASS가 아니라 CUTLASS의 Python 프론트엔드인 CuTe DSL입니다. 또 softmax의 exp 계산을 특수 함수 유닛(SFU) 대신 일반 연산 유닛의 다항식 근사로 옮기는 등, 알고리즘 자체를 새 하드웨어의 자원 밸런스에 맞춰 재설계했습니다. 논문 기준으로 B200(BF16)에서 cuDNN 9.13 대비 최대 1.3배, Triton 구현 대비 2.7배 빠릅니다. FA3와의 직접 비교는 논문에 없고, Hot Chips 발표 수치(B200 FA4 약 1.6 PFLOPs/s vs H100 FA3 약 0.74 PFLOPs/s)는 서로 다른 GPU 사이의 비교입니다. v3에 이어 v4에서도 하드웨어 세대가 바뀌자 커널을 다시 작성했습니다.
출처: FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling
FlashInfer: Serving용 Attention Engine
FlashInfer는 paged KV cache, variable-length batch와 Prefill·Decode별 실행처럼 LLM serving에 필요한 attention kernel을 제공하는 library입니다. FlashAttention의 tiling·fusion·online softmax를 기반으로 serving shape에 맞는 kernel을 JIT compile하며 vLLM, SGLang과 TensorRT-LLM 등에 integration되어 있습니다. 어떤 backend가 기본으로 선택되는지는 framework version, GPU architecture, dtype과 attention 형태에 따라 달라집니다.
출처: FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
CUDA, CUTLASS와 Triton의 추상화 수준
CUDA C++는 낮은 수준의 제어를 제공하지만, 그것만으로 고성능이 자동 보장되지는 않습니다. 최근 GPU의 Tensor Core, TMA와 software pipeline을 효과적으로 사용하려면 CUTLASS·CuTe 같은 hardware-aware abstraction이나 Triton compiler를 활용할 수 있습니다. 다음 절에서는 각 도구가 programmer와 compiler에 맡기는 역할을 비교합니다.
GPU 아키텍처의 진화와 CUTLASS
GPU 아키텍처는 CUDA가 가정했던 깨끗한 SIMT4 아키텍처에서, 다양한 최적화 기능이 추가되면서 현저히 복잡해졌습니다.
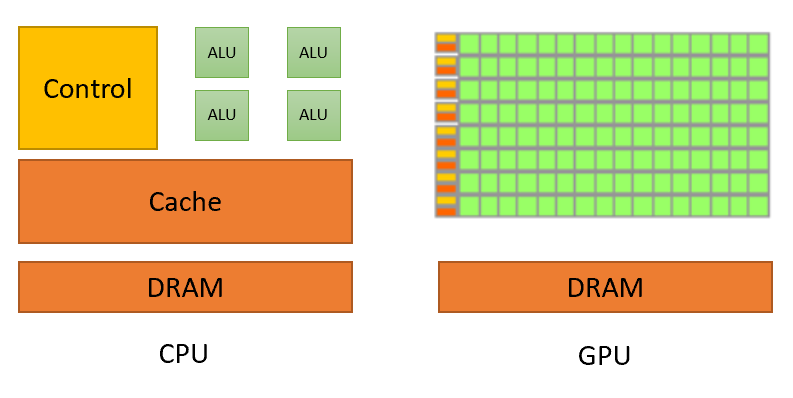
CUDA가 가정한 GPU: 작은 control에 수많은 동일한 ALU (SIMT)
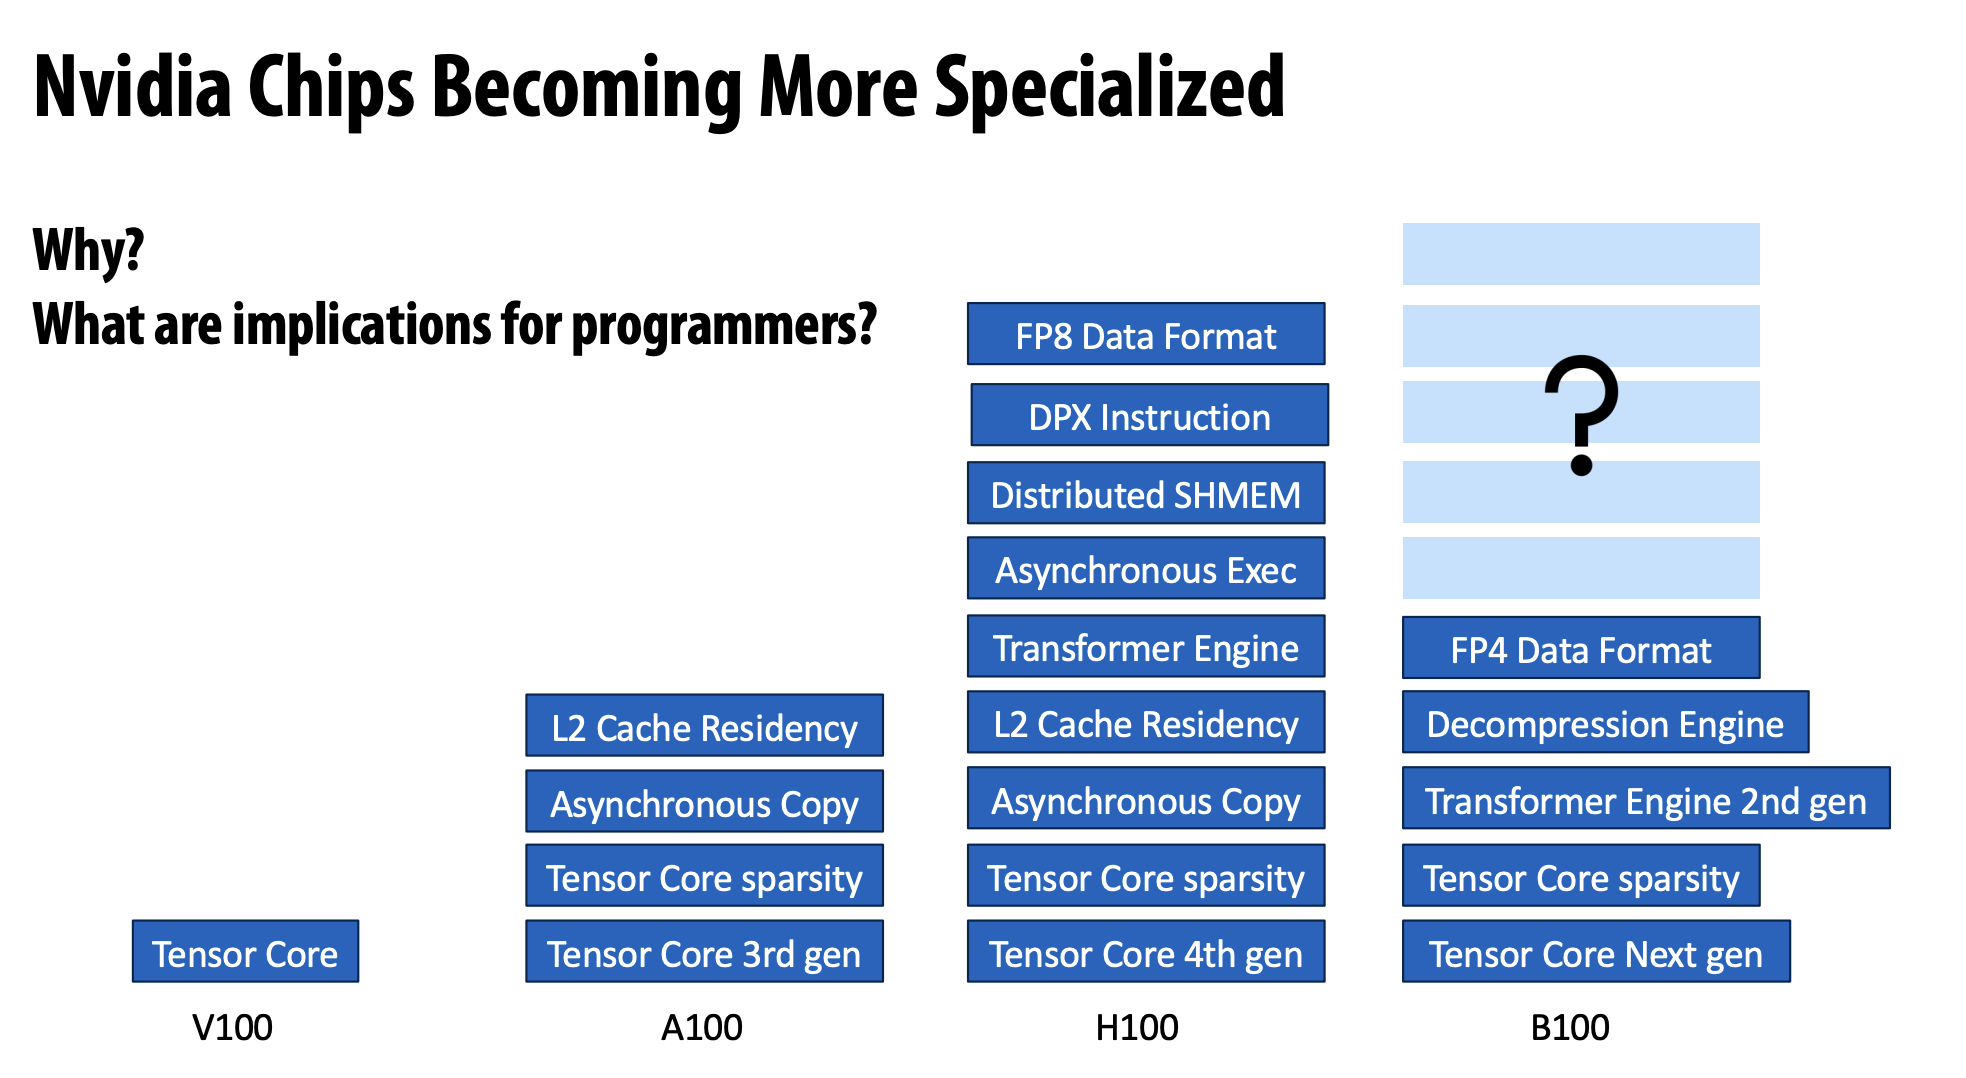
세대마다 전용 기능이 쌓여 복잡해진 최근 GPU (V100 → B100)
CUTLASS는 이렇게 복잡해진 GPU의 계층적 병렬 수행을 개발자가 직접 control할 수 있도록 C++ template을 제공하는 라이브러리입니다.
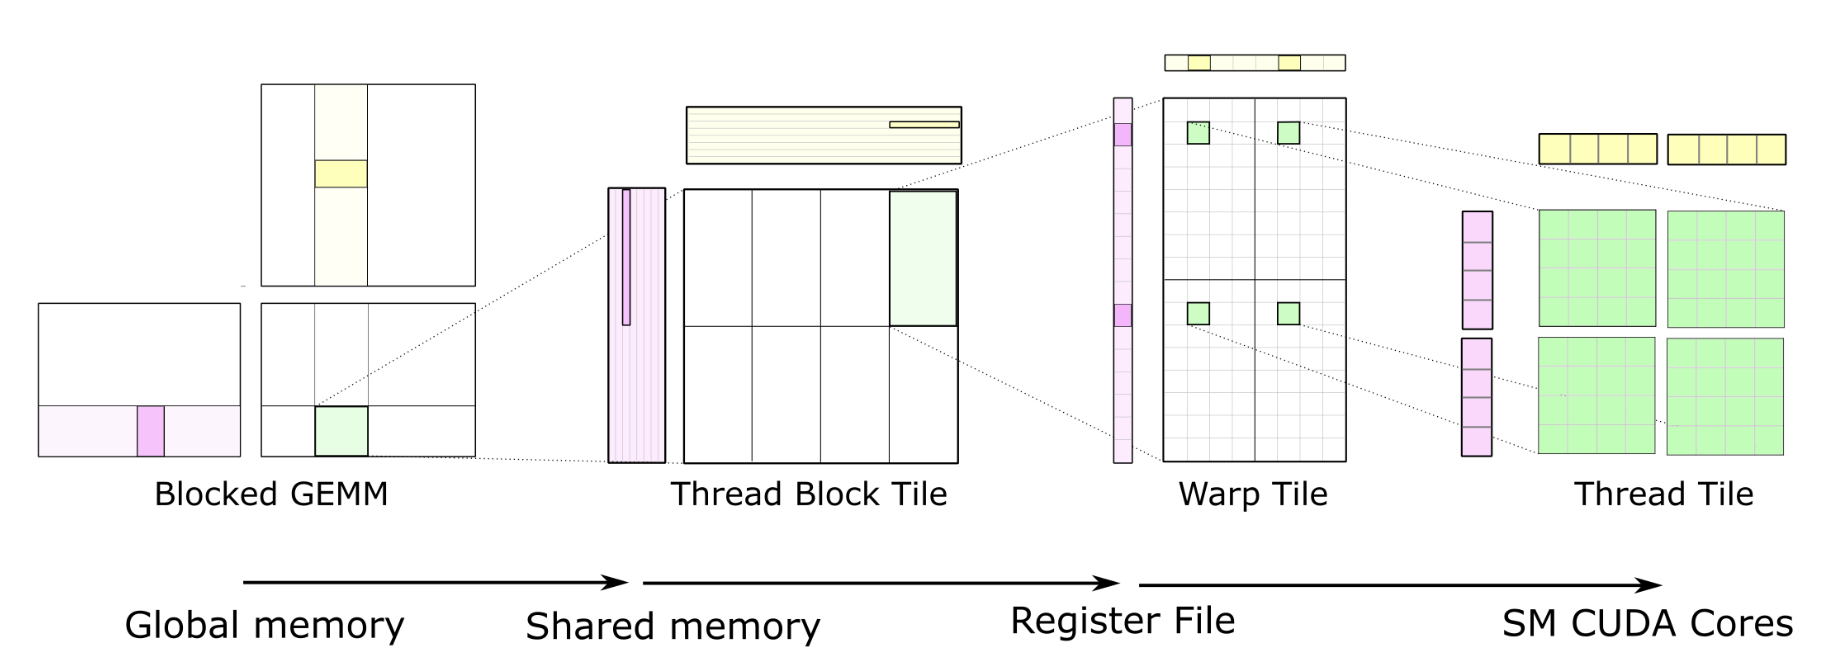
하지만 최적화된 CUDA Kernel을 작성하는 것은 여전히 만만치 않습니다. GEMM 커널 하나를 GPU peak 성능에 가깝게 끌어올리는 데 어떤 기법을 거쳐야 하는지가 다음 슬라이드 한 장에 잘 드러납니다.
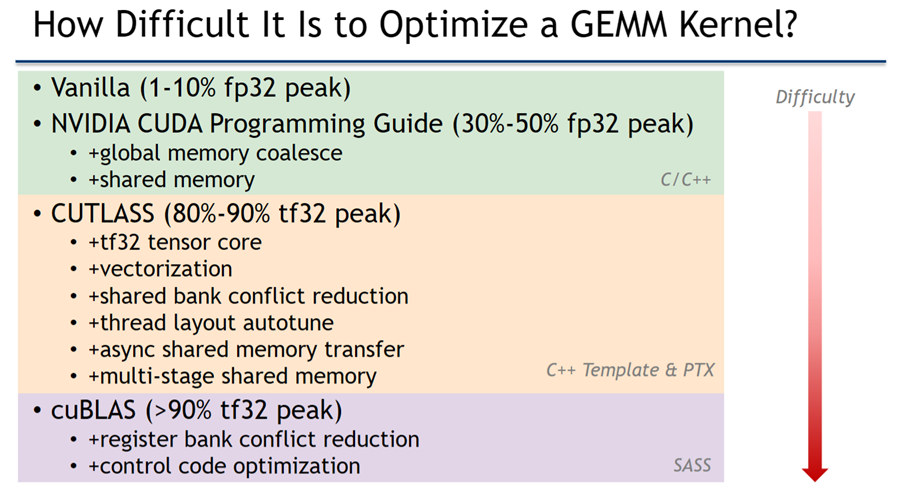
정리하면 다음과 같습니다.
- 아무 최적화 없는 vanilla 코드 - fp32 peak의 1–10%
- CUDA Programming Guide 수준(coalescing, shared memory)까지 적용한 코드 - fp32 peak의 30–50%
- CUTLASS 같은 가속화 템플릿을 잘 활용 - tf32 peak의 약 80–90%까지 도달 가능
- 그래도 마지막 10%는 안 채워짐 - CUTLASS로도 표현되지 않는 세부 하드웨어 최적화(register bank conflict, control code)가 존재하고, 이건 SASS 수준에서 작성된 NVIDIA의 비공개 구현(cuBLAS5, >90%)에만 반영되어 있습니다. cuBLAS 자체는 누구나 호출할 수 있지만, 그 수준의 커널을 직접 쓰는 것은 NVIDIA 바깥에서는 어렵습니다.
GPU에서 peak 성능을 끌어내려면 이처럼 여러 단계의 최적화가 필요합니다.
출처: Towards Agile Development of Efficient Deep Learning Operators
출처: Practical Performance Optimization for Deep Learning Applications
Triton: Tile-level Kernel Programming
Triton은 Philippe Tillet이 시작하고 OpenAI가 공개한 tile-level GPU kernel language와 compiler입니다. PyTorch 2.0 이후 Inductor의 NVIDIA·AMD GPU code generation 경로에 사용되면서 활용 범위가 넓어졌습니다.
Triton에서는 programmer가 tile의 shape과 data flow를 기술하고, thread-level mapping과 일부 hardware-specific optimization을 compiler가 담당합니다. Triton은 CUDA C++보다 높은 수준의 추상화를 제공하면서도 tiling·fusion을 직접 표현할 수 있습니다.
이 강의에서는 Triton 문법보다 kernel programming이 필요한 이유와 tiling·fusion으로 줄일 수 있는 memory traffic에 초점을 맞춥니다.
“OpenAI’s Triton is very disruptive angle to Nvidia’s closed-source software moat for machine learning.”
출처: Dylan Patel, How Nvidia’s CUDA Monopoly In Machine Learning Is Breaking (SemiAnalysis, 2023)
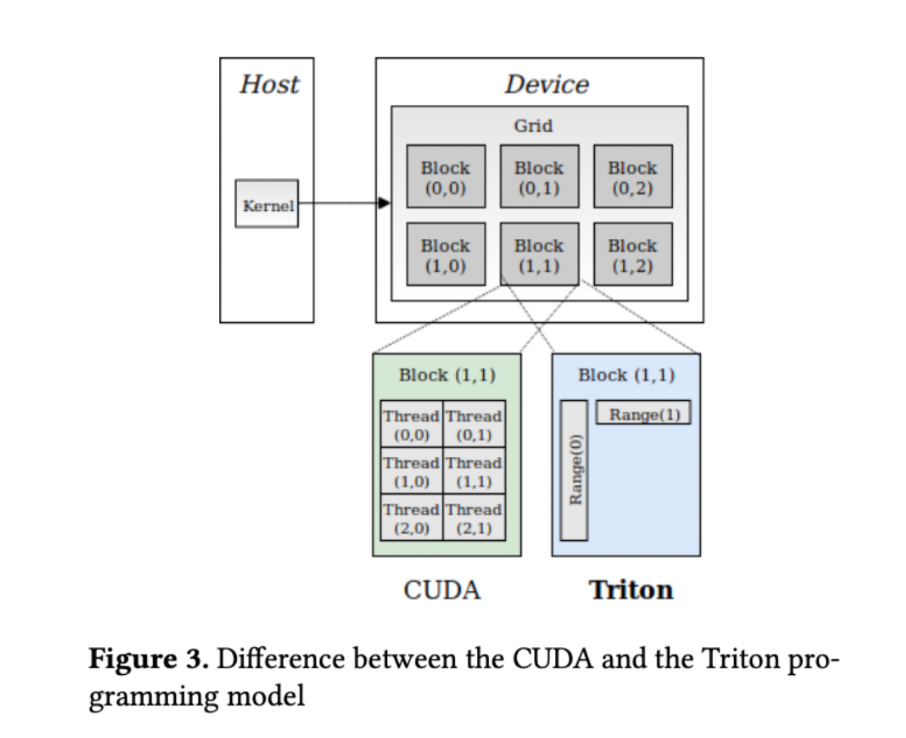
출처: Tillet et al., Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations (MAPL 2019), Figure 3
Triton은 block 단위 프로그래밍 모델을 씁니다. 프로그래머는 프로그램이 여러 block으로 나뉜다는 것만 알면 되고, block 안의 thread 배치·memory 계층·Tensor Core 사용은 컴파일러가 맡습니다.
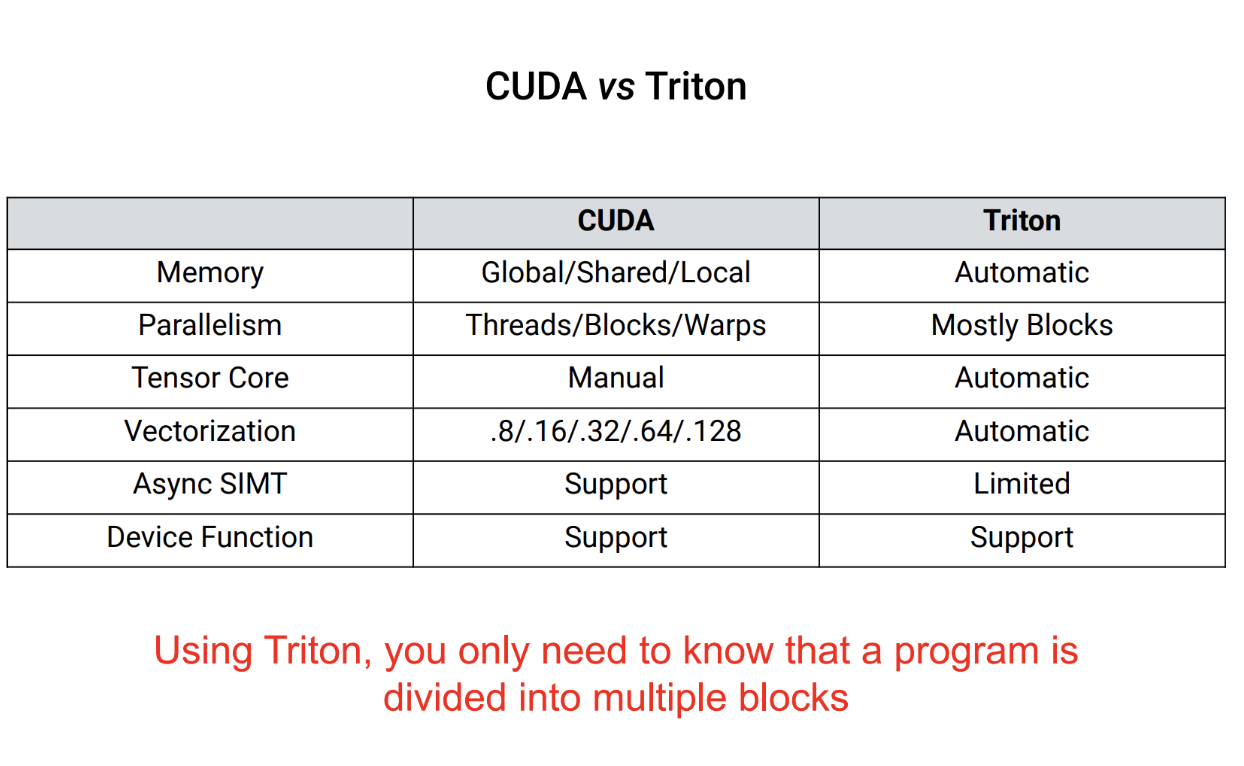
- CUDA: memory 계층(global/shared/local), thread/warp/block, Tensor Core, vectorization을 모두 프로그래머가 지정
- Triton: 프로그래머는 block 단위의 계산만 기술하고 나머지는 컴파일러가 자동 처리
- 대신 async SIMT 같은 세밀한 제어는 제한적
Triton 백엔드는 NVIDIA GPU에 한정되지 않고 AI 가속기와 CPU로 넓어지고 있습니다. Triton Conference 2024 기준으로 다음 백엔드들이 공식적으로 언급됩니다.
이 목록에는 upstream backend뿐 아니라 각 vendor와 community가 개발 중인 backend도 포함됩니다. Triton IR과 programming model을 여러 accelerator에 적용하려는 시도는 넓지만, 지원 op와 성능, 유지보수 수준은 backend마다 다르므로 같은 kernel이 모든 target에서 수정 없이 같은 성능으로 동작한다고 볼 수는 없습니다.
CUDA Tile과 cuTile
CUDA 13.1에는 CUDA Tile programming model과 Python DSL인 cuTile이 추가되었습니다(C++ 지원은 CUDA 13.3부터). Programmer는 tile 단위의 계산과 data movement를 표현하고, Tile IR compiler가 이를 target hardware instruction으로 lowering합니다.
NVIDIA는 Triton을 CUDA Tile IR로 lowering하는 backend도 공개했습니다. 강의 시점에는 별도 build가 필요한 개발 단계의 backend이므로, 기존 Triton CUDA backend를 전면 대체한 production default로 해석해서는 안 됩니다. 두 프로젝트는 tile-level abstraction을 사용한다는 공통점이 있지만 frontend, compiler stack과 지원 범위는 서로 다릅니다.
출처: Focus on Your Algorithm—NVIDIA CUDA Tile Handles the Hardware
출처: Advancing GPU Programming with the CUDA Tile IR Backend for OpenAI Triton
Serving 최적화 Framework
커널 위쪽에는 서빙(serving) 레이어가 있습니다. Continuous Batching, Speculative Decoding 같은 기법은 점점 서빙 프레임워크의 기본 기능이 되고 있습니다. 오늘날 LLM 추론 스택에서는 모델·커널 위에 Inference Engine과 Inference Server가 있고, batching·decoding·KV cache 관리가 이 층에서 동작합니다.
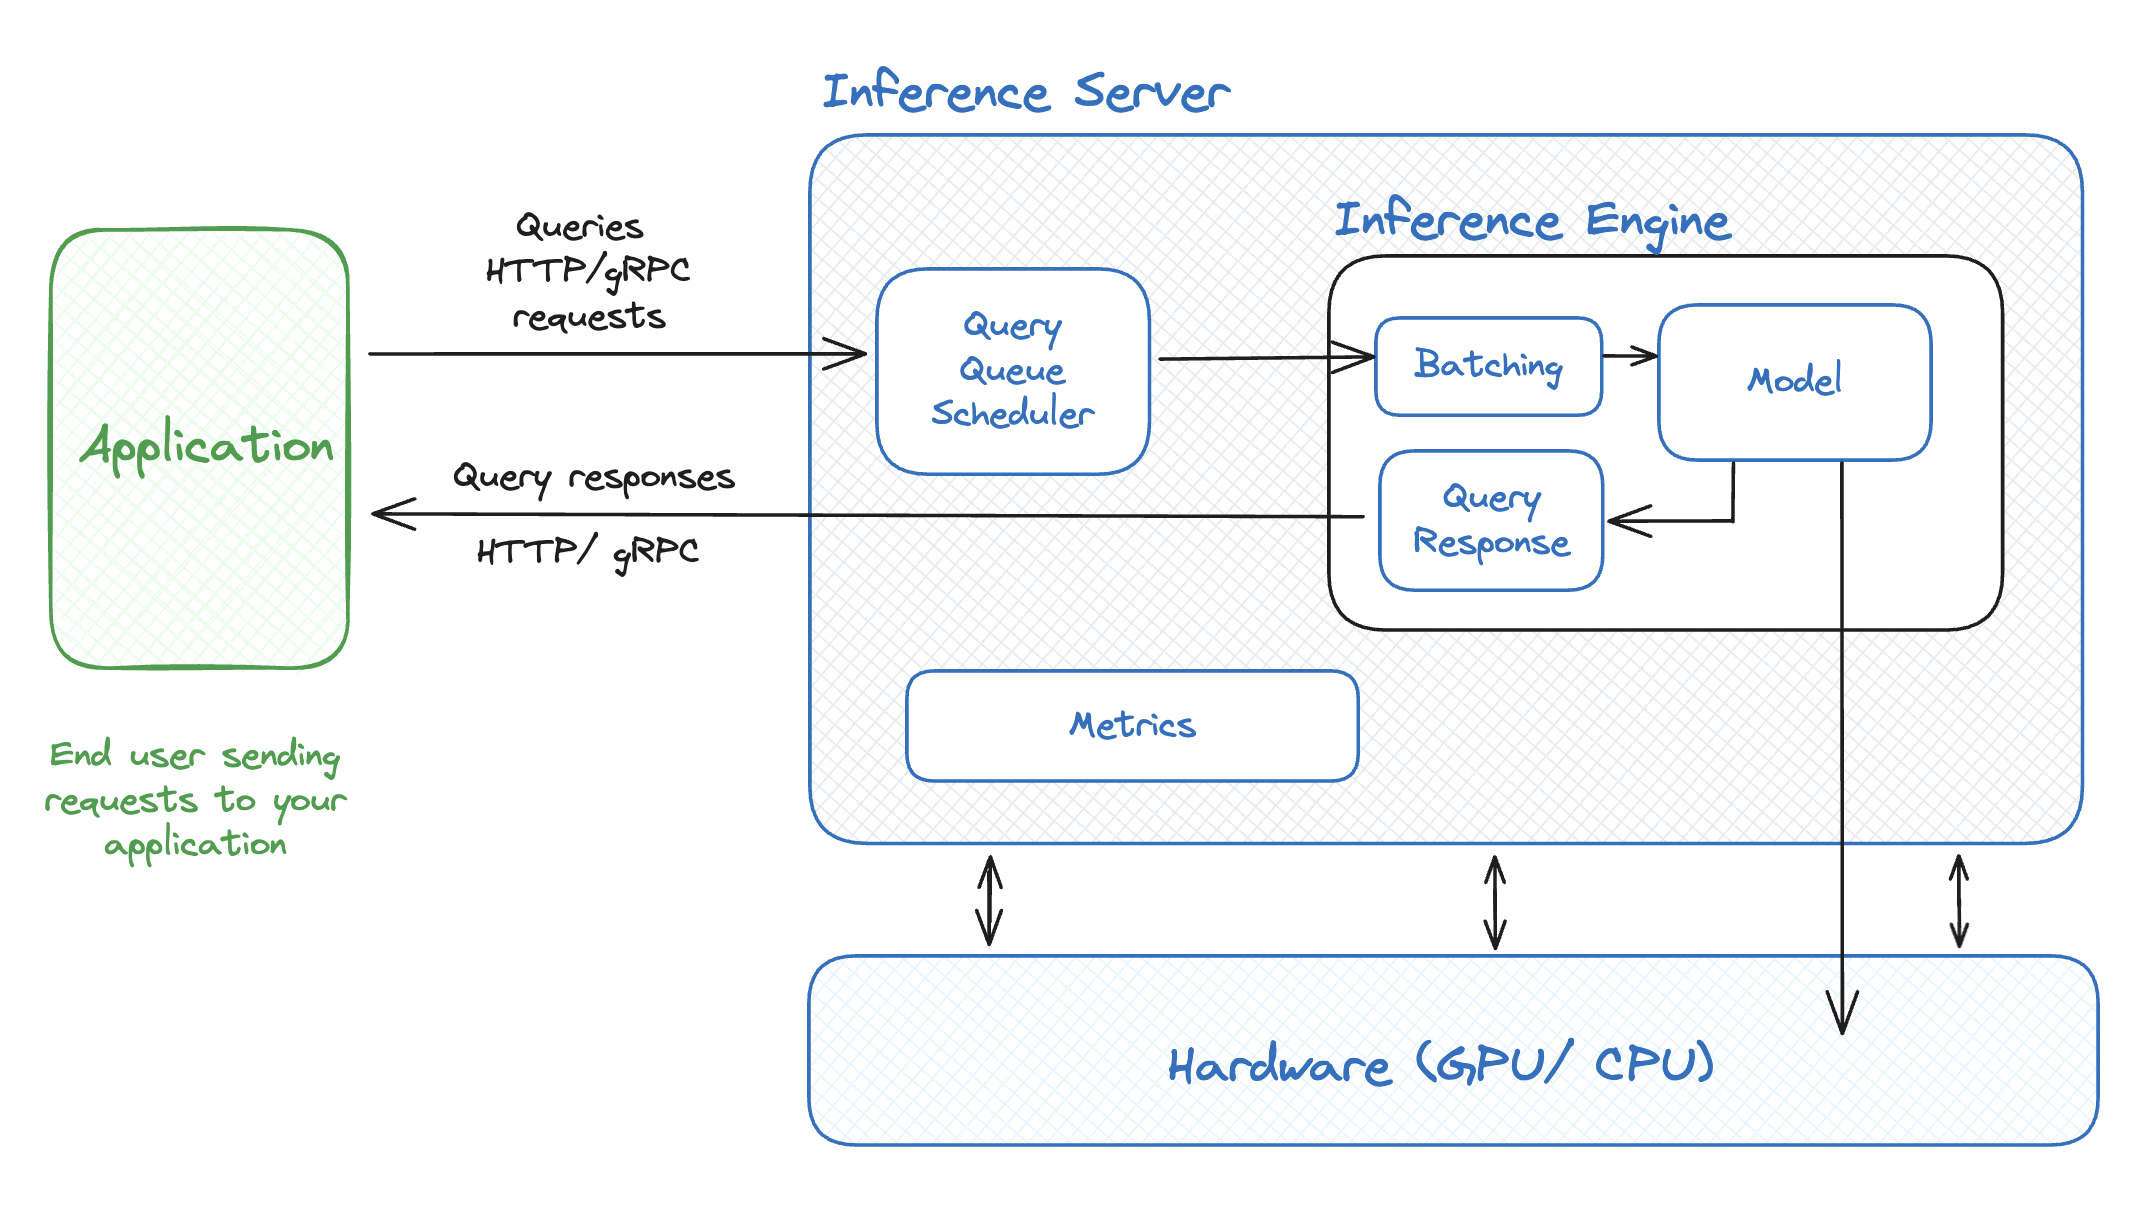
vLLM: 오픈소스 LLM Serving Engine
vLLM은 PagedAttention을 제안한 UC Berkeley 연구진이 시작한 오픈소스 LLM serving engine입니다. Continuous batching, KV cache 관리와 distributed serving을 통합하며 여러 production 환경에서 사용됩니다. 2025년에는 PyTorch Foundation의 hosted project로 합류했습니다.
vLLM에 반영된 주요 최적화 기법
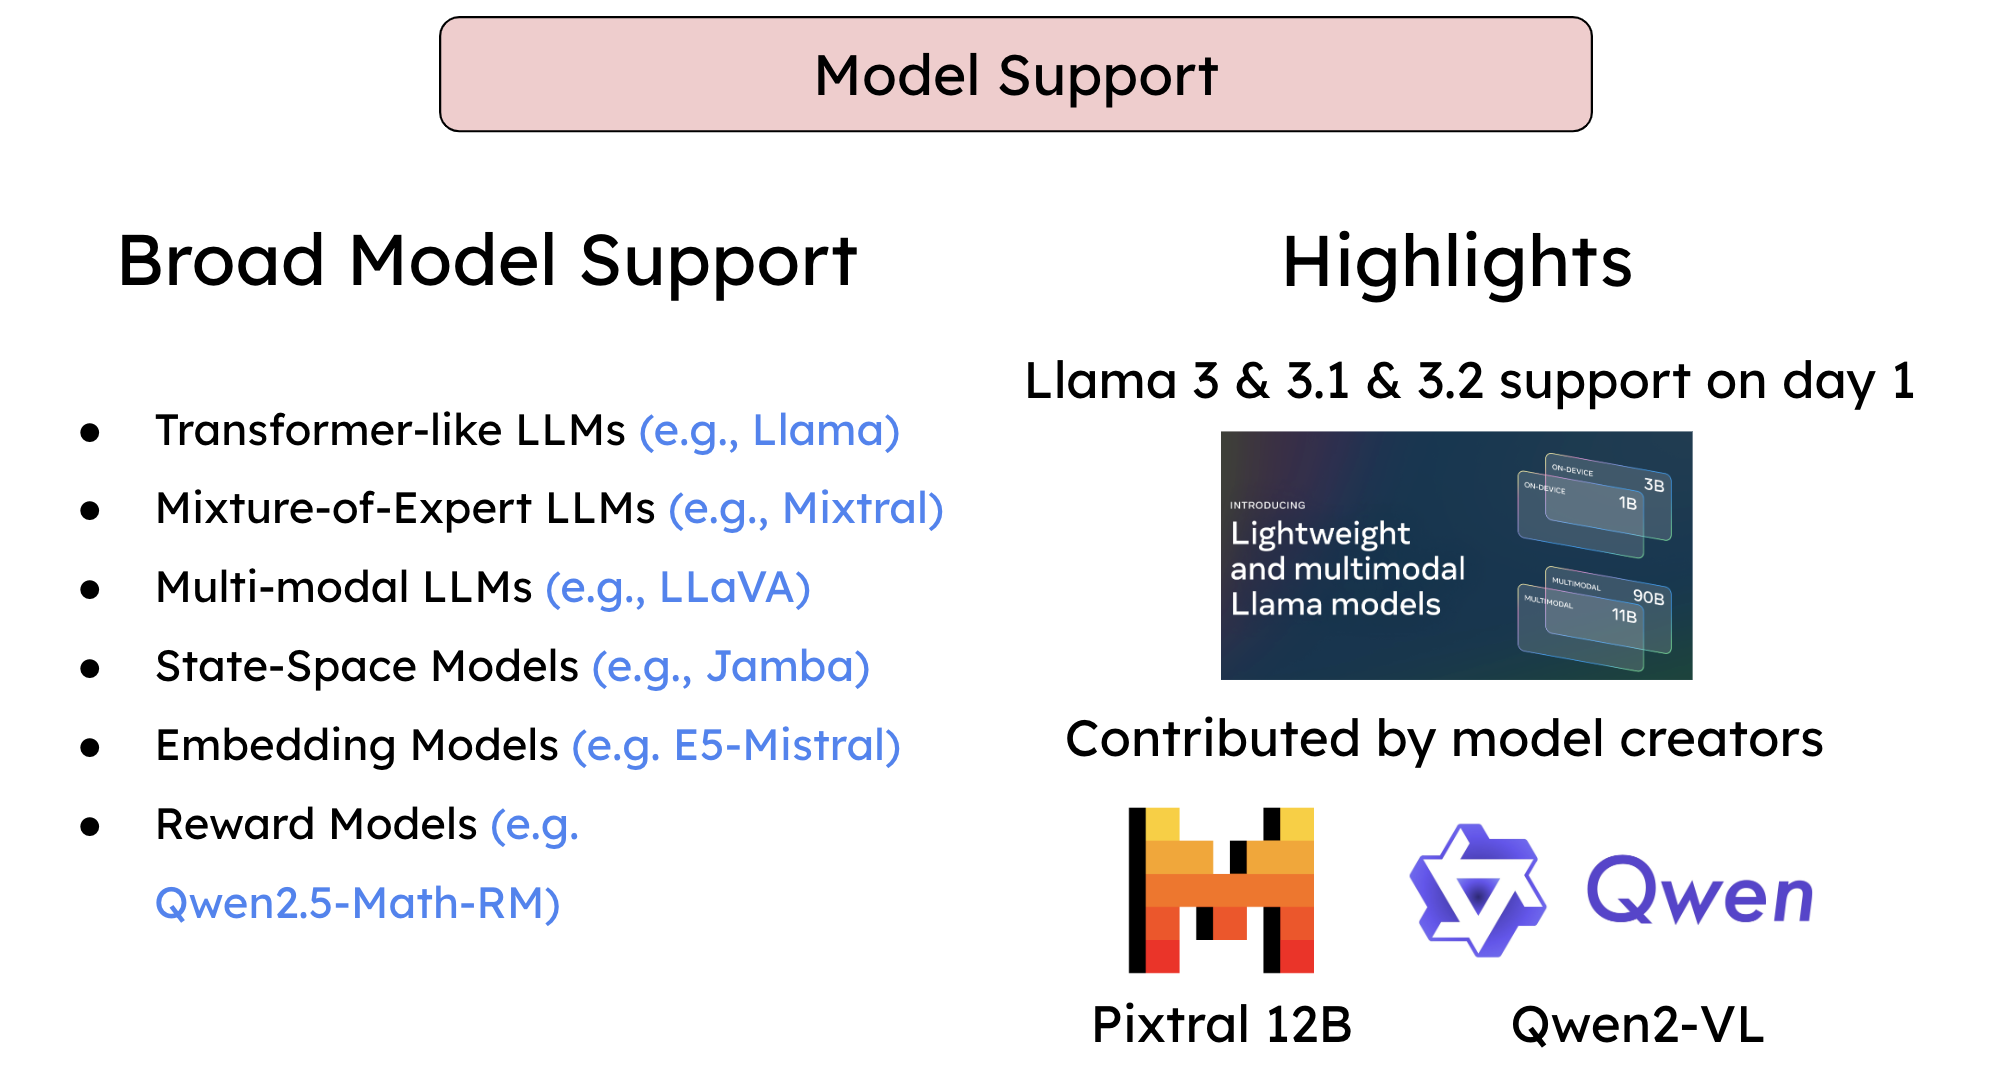
먼저 지원 모델의 폭입니다. Transformer 계열 LLM뿐 아니라 MoE, multi-modal, state-space, embedding, reward 모델까지 다루고, 주요 모델은 출시 당일 지원됩니다. 그리고 앞서 다룬 최적화 기술들이 대부분 vLLM에 들어 있습니다. 아래 네 장이 그 예입니다.
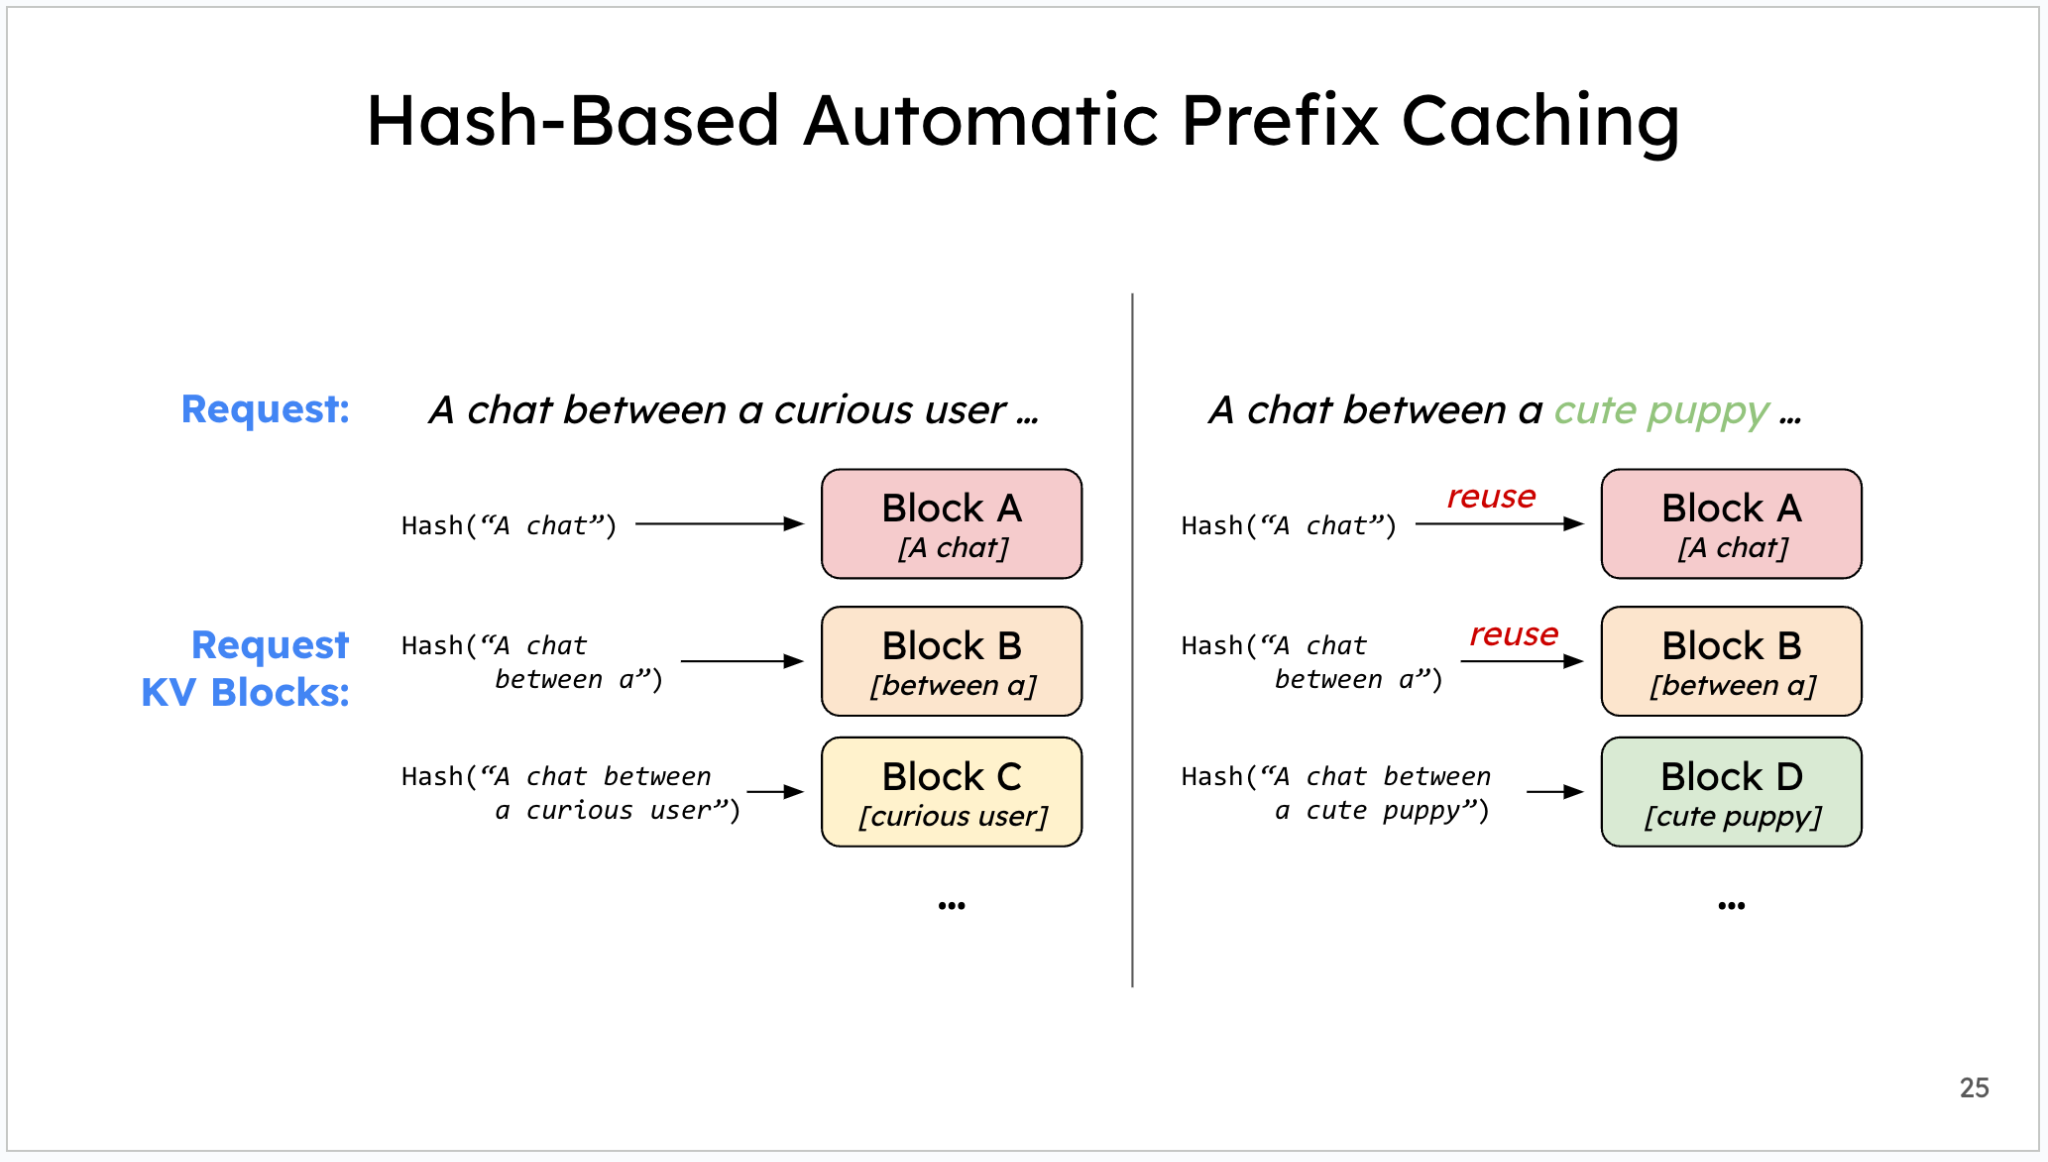
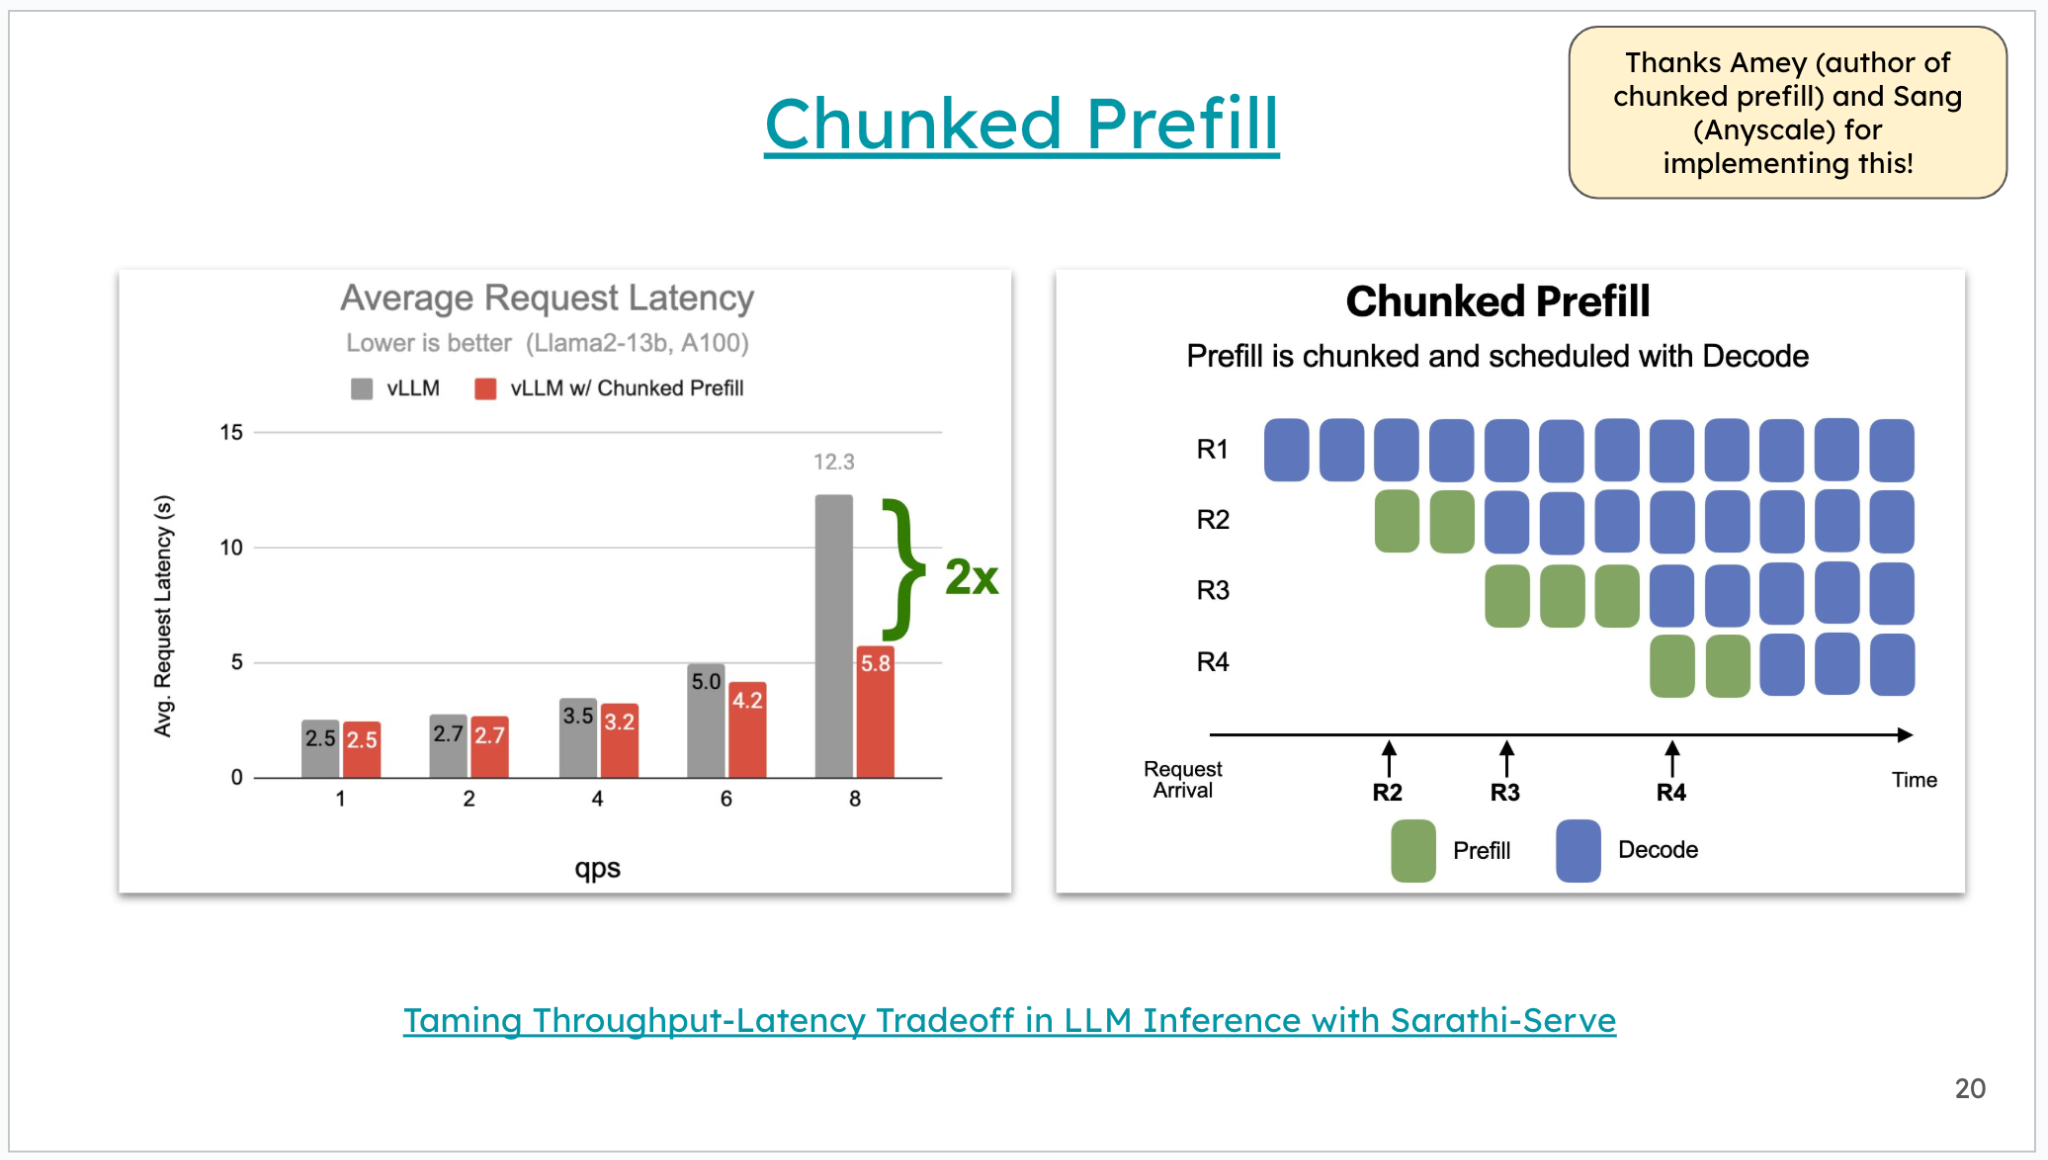
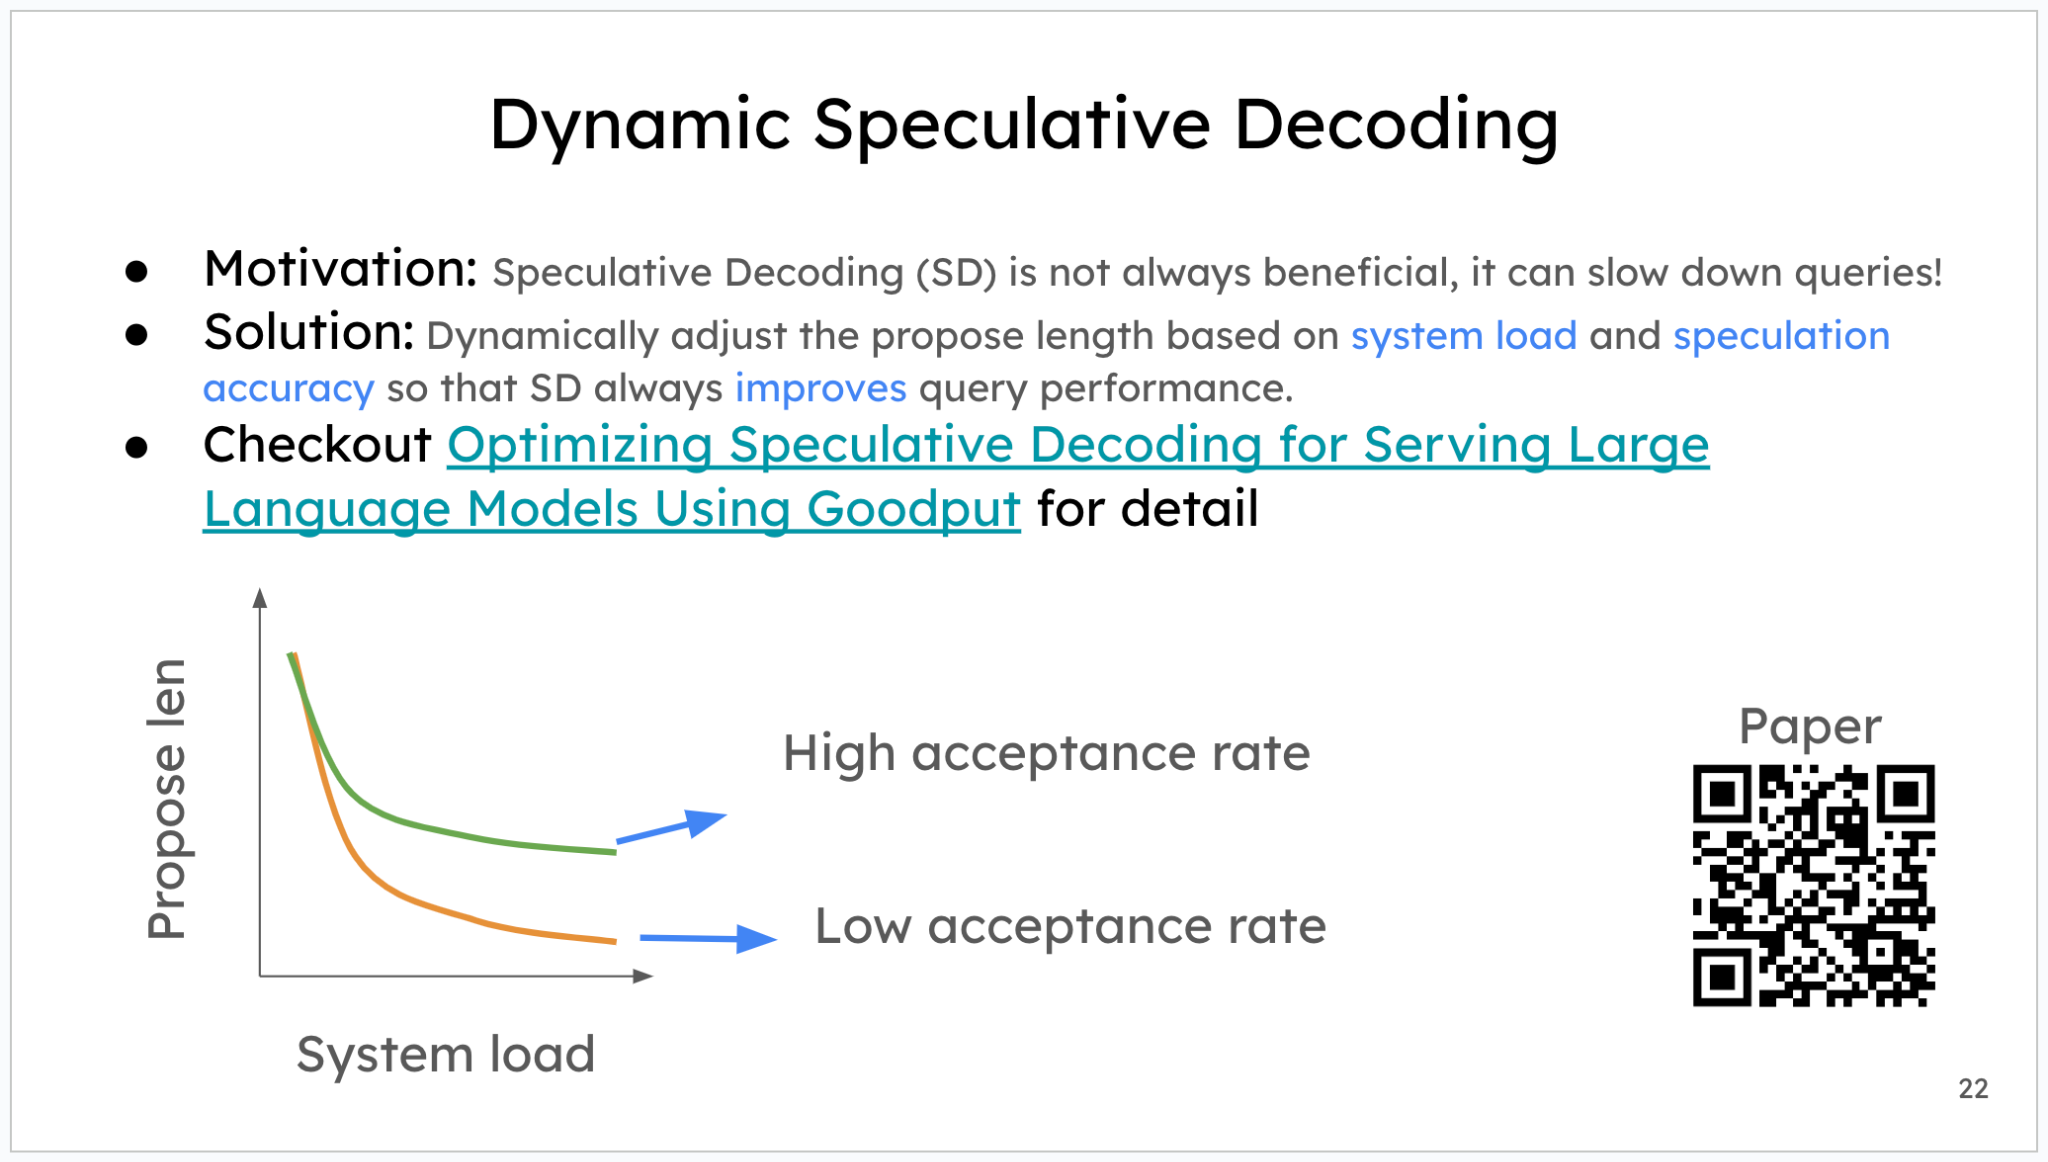
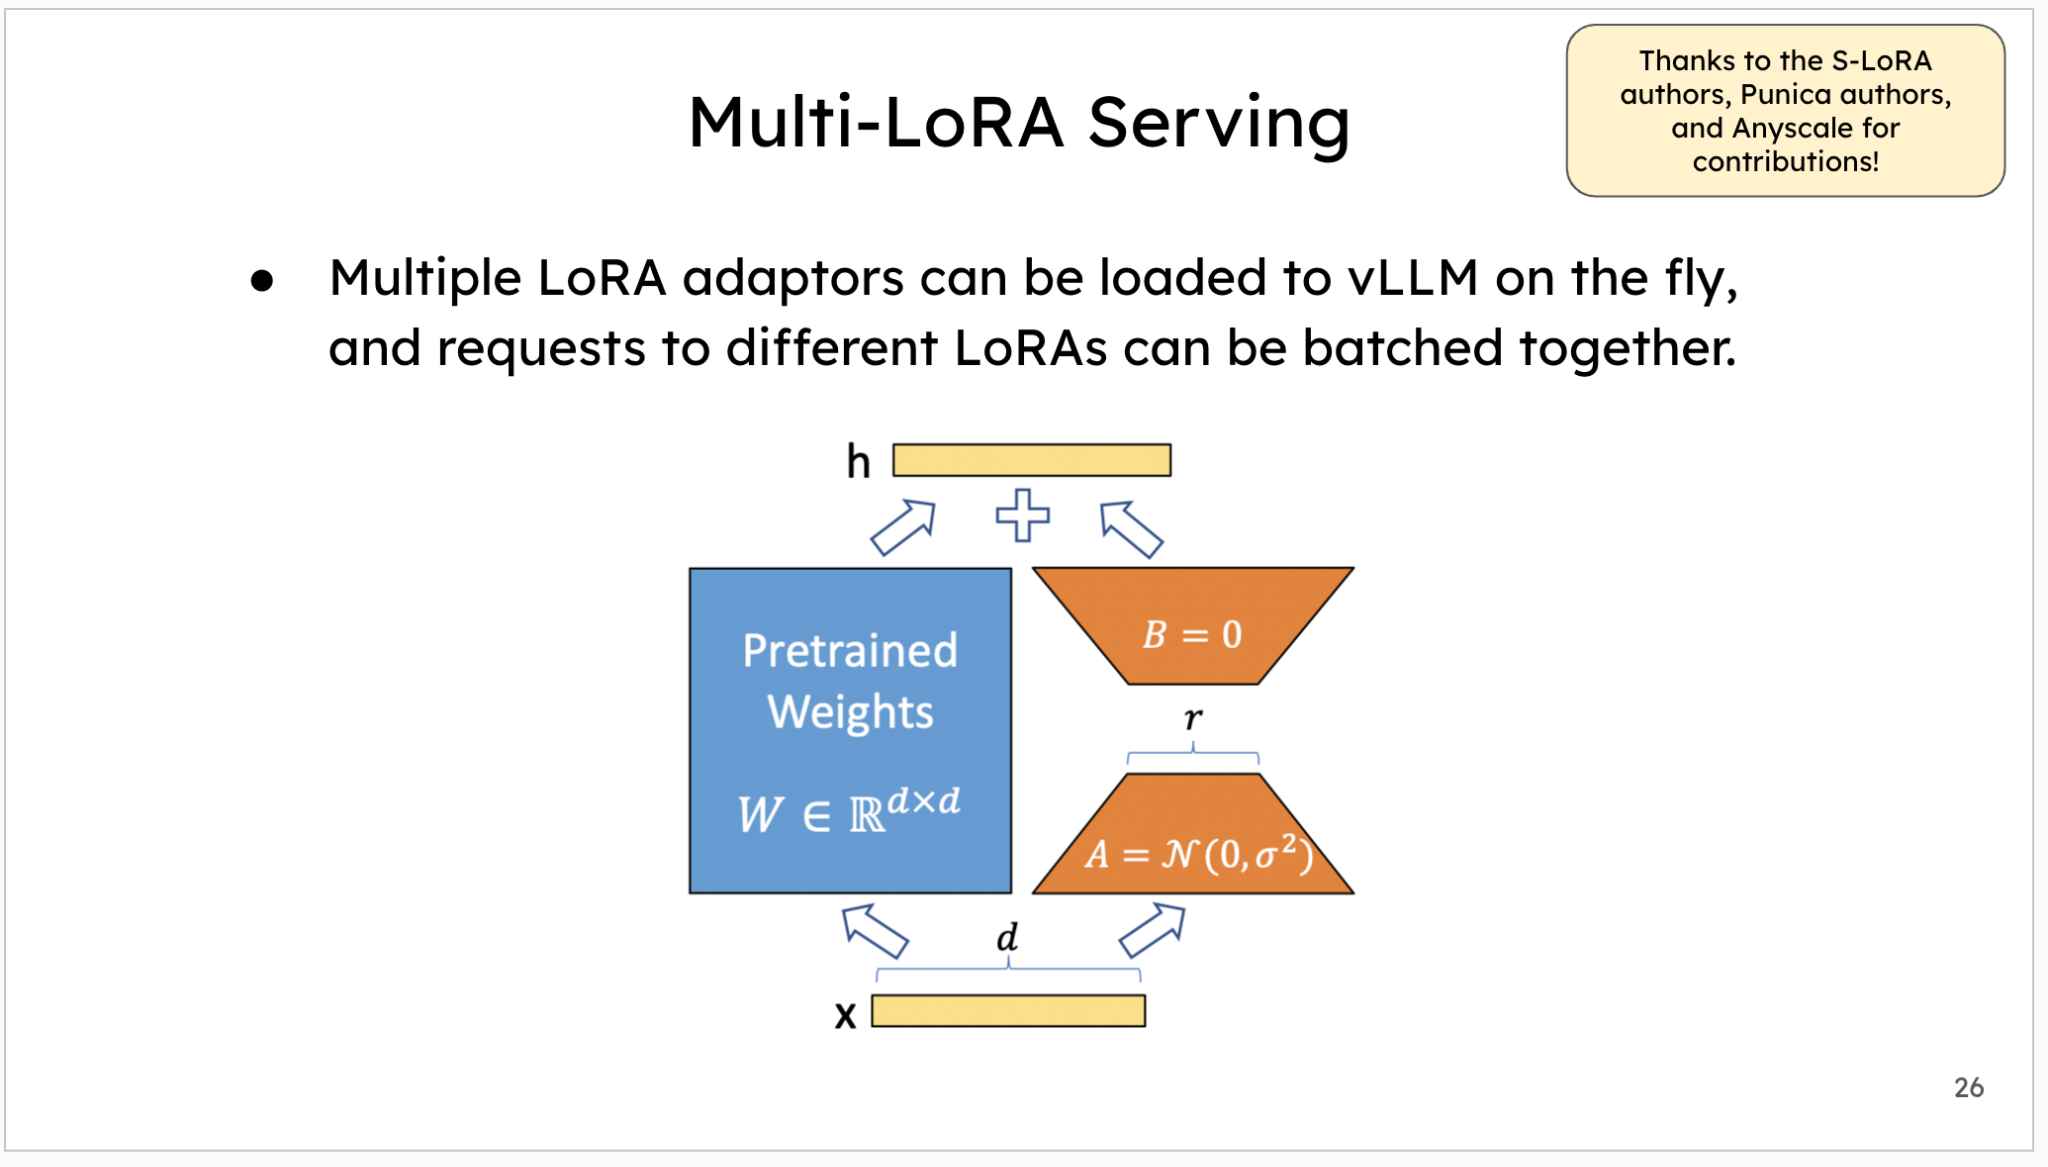
vLLM은 continuous batching과 PagedAttention 외에도 chunked prefill, prefix caching, speculative decoding, structured output, quantization, TP(Tensor Parallel)/PP(Pipeline Parallel)/EP(Expert Parallel, MoE의 expert를 여러 GPU에 분산)와 disaggregated serving을 지원합니다. 이 절의 수치와 지원 범위는 각 자료의 benchmark와 버전 조건에 한정된 값입니다.
vLLM V1: 엔진 재설계, 그리고 torch.compile
vLLM V1은 scheduler와 execution path를 재설계하고 torch.compile을 기본 compilation path로 사용합니다. Compile 대상은 vLLM이 로드한 model 구현으로, 자체 구현이든 뒤에서 볼 Transformers backend든 같은 경로를 탑니다. Dynamo는 forward가 실행하는 PyTorch 연산을 트레이싱할 뿐 코드의 출처를 가리지 않기 때문입니다. Model을 처음 실행할 때 FX graph6를 capture해 compile하고 artifact를 cache합니다. Inductor가 target에 맞는 code를 생성하며, GPU backend에서는 Triton 또는 다른 backend-specific codegen을 사용할 수 있습니다. Attention처럼 별도 kernel이 필요한 구간은 custom op으로 두고 나머지 graph를 piecewise compile하여 handwritten kernel과 compiler-generated kernel을 함께 사용합니다.
Week 3에서 본 그래프 모드·Inductor가 서빙 프레임워크의 기본 경로에 들어와 있습니다. 하드웨어 벤더가 torch.compile 백엔드를 제공하면 vLLM의 컴파일 경로를 그대로 쓸 수 있습니다. 다만 attention처럼 custom op으로 남는 kernel은 별도로 제공해야 합니다(뒤의 plugin system 참고).
참고: vLLM V1: A Major Upgrade to vLLM’s Core Architecture
참고: Introduction to torch.compile and How It Works with vLLM
참고: vLLM: Easy, Fast, and Cheap LLM Serving for Everyone — Simon Mo, PyTorch Conference 2025
vLLM 내부 구조: 이 강의의 기법들이 코드로 만나는 곳
vLLM의 내부를 한 층만 들춰 보면, 이 강의에서 다룬 개념들이 그대로 구현 컴포넌트로 등장합니다. 엔진 코어는 단순한 루프입니다. Scheduler가 이번 스텝에 처리할 요청들을 고르고 → 모델이 forward를 한 번 돌고 → 결과를 후처리해 각 요청에 나눠 주는 세 단계를 무한히 반복합니다.
- Scheduler와 token budget - V1 스케줄러는 Prefill과 Decode를 별개의 경로로 두지 않고, “이번 스텝에 처리할 토큰 예산” 하나로 통합했습니다. 매 스텝 running 큐에 있는 요청들의 토큰(decode 1개, 또는 아직 prefill이 남았으면 그 다음 chunk)을 먼저 배정하고, 남은 예산에 waiting 큐의 새 요청을 채워 넣습니다. 긴 프롬프트는 예산에 맞게 잘라 여러 스텝에 나눠 처리합니다(chunked prefill). vLLM은 이 방식으로 continuous batching을 구현합니다.
- 패딩 없는 배칭 - 선택된 요청들의 토큰은 padding 없이 하나의 긴 “super sequence”로 이어 붙여 단 한 번의 forward로 처리합니다. position 인덱스와 attention 커널의 가변 길이 지원이 시퀀스 간 경계를 지켜 줍니다.
- KV cache manager - KV cache는 고정 크기 블록(기본 16토큰) 단위로 관리되고, free block pool에서 필요한 만큼만 그때그때 할당됩니다. Paged Attention의 구현입니다. 여기에 블록 단위 해시로 같은 prefix를 가진 요청끼리 KV 블록을 재사용하는 prefix caching이 얹힙니다.
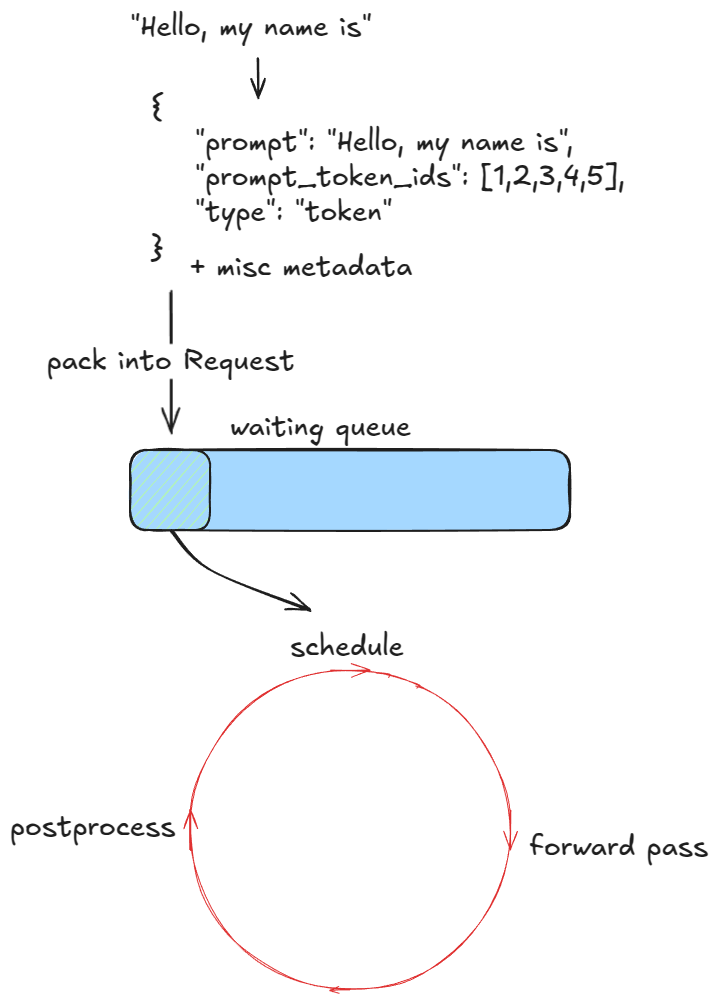
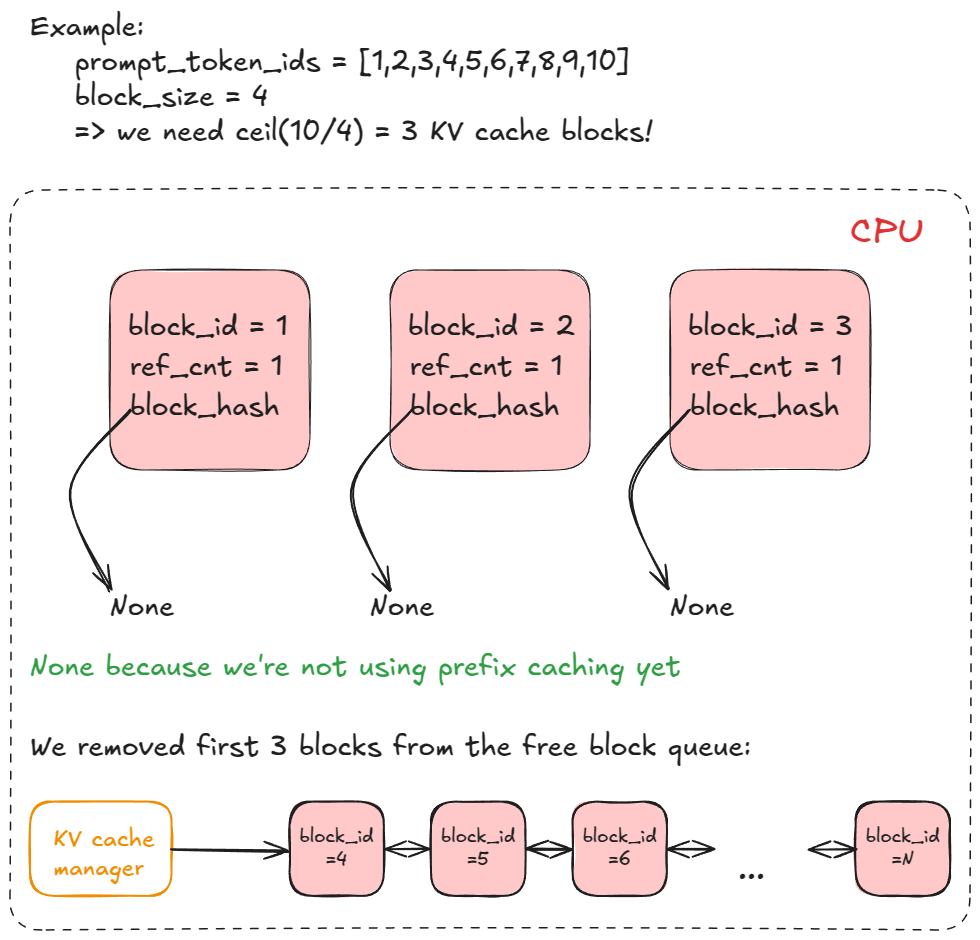
출처: Inside vLLM: Anatomy of a High-Throughput LLM Inference System
2026년에 공개된 Model Runner V2는 batch state 관리 같은 CPU overhead를 줄이기 위해 input tensor 준비와 sampling 일부를 GPU로 옮기고 CPU–GPU 실행을 겹치도록 설계되었습니다. 공개 benchmark의 Qwen3-0.6B·GB200 1장 구성에서는 output throughput이 16K → 25K tok/s로 56% 향상되었습니다. 강의 시점에는 dense model에서 기본 사용되고 MoE 지원은 opt-in 상태입니다.
vLLM에는 Triton으로 작성된 attention backend도 있습니다. 공개된 특정 H100 benchmark에서는 FlashAttention-3와 비슷한 성능을 보였고 AMD GPU용 backend와도 상당한 구현을 공유합니다.
vLLM의 PyTorch 중심 전략
vLLM은 PyTorch 기반일 뿐 아니라, 다양한 하드웨어를 직접 붙이지 않겠다고 명시했습니다. vLLM 측의 입장은 “하드웨어는 일단 PyTorch에 잘 붙여 오기만 하면, 그 위에서 vLLM이 동작하도록 우리가 만들겠다” 에 가깝습니다.
아래에 하드웨어가 있고, 그 위에 PyTorch가 추상화 레이어로 놓이며, 그 위에 vLLM이 올라갑니다. vLLM은 하드웨어 다양성 대응을 PyTorch 레이어에 맡깁니다.
이 점은 리벨리온처럼 추론용 NPU를 개발하는 AI 반도체 회사에 중요합니다. PyTorch device backend와 vLLM platform·kernel integration을 함께 제공해야 기존 model과 serving workflow를 해당 hardware에서 사용할 수 있기 때문입니다.
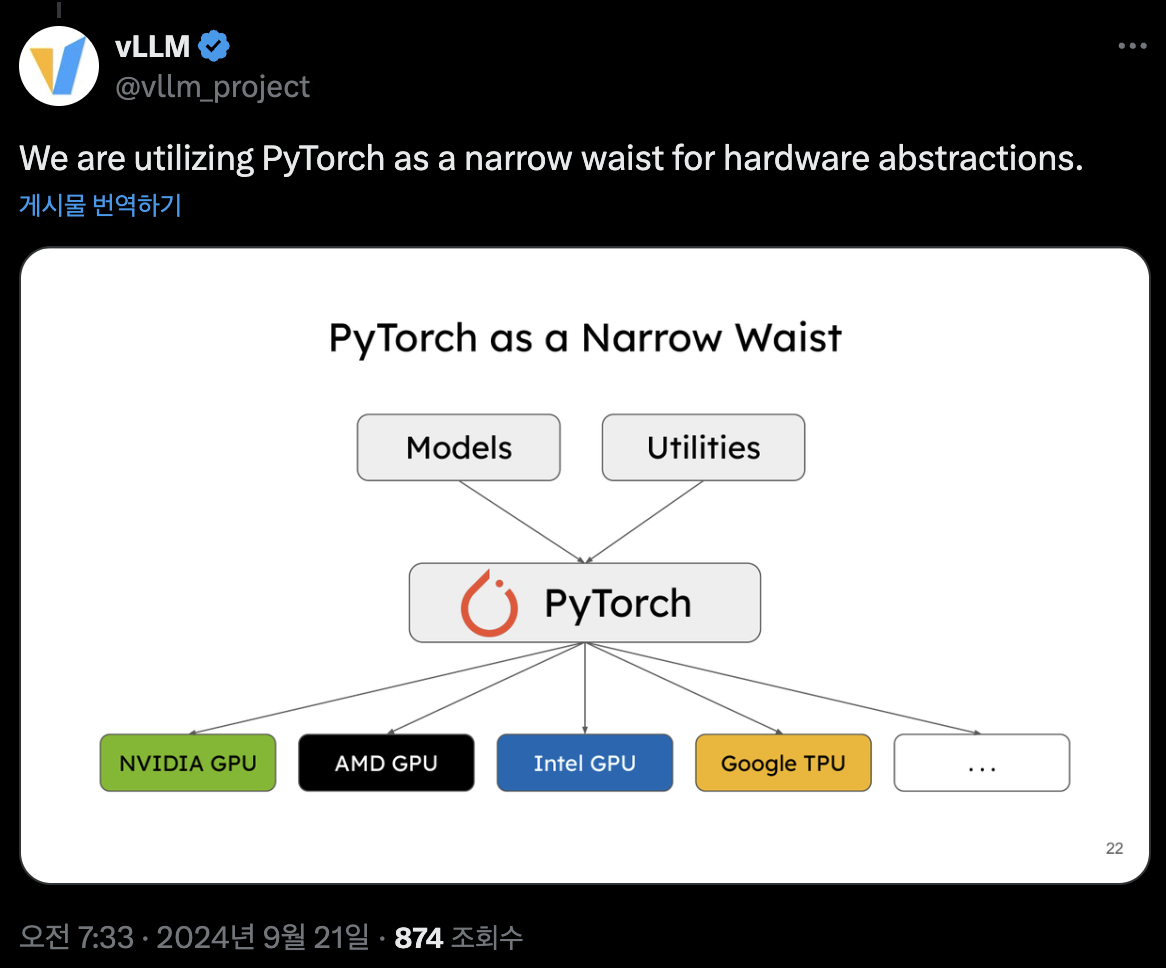
vLLM은 hardware plugin system을 제공하며, vendor는 platform plugin을 별도 package(out-of-tree)로 유지할 수 있습니다. 리벨리온의 vllm-rbln도 이 방식으로 ATOM·REBEL 지원을 제공합니다. 다만 PyTorch device support만으로 vLLM 지원이 자동 완성되는 것은 아닙니다. Platform integration과 함께 attention·KV cache kernel, distributed communication 등 vLLM 실행 경로에 필요한 구현이 추가로 필요합니다.
모델 코드는 어디서 오는가: 자체 구현과 Transformers Backend
하드웨어 반대편, 모델 정의 쪽에도 같은 질문을 던질 수 있습니다. vLLM에서 Llama나 Qwen을 서빙할 때 그 모델 코드는 어디서 올까요? 기본적으로 vLLM은 주요 아키텍처마다 자체 최적화 구현을 유지합니다. Hugging Face의 모델 코드를 그대로 쓰는 것이 아니라, tensor parallel용 병렬 linear 레이어와 vLLM의 attention 인터페이스에 맞춰 다시 작성한 구현이고(vllm/model_executor/models/), checkpoint(weight)만 Hugging Face Hub에서 받아 그 위에 얹습니다.
그럼 이 지원 목록에 없는 모델이 들어오면 어떻게 될까요? Transformers 쪽 구현이 vLLM의 요구 조건(attention 인터페이스 등)을 만족하는 모델이면 vLLM은 Transformers backend로 자동으로 넘어갑니다(fallback). Hugging Face transformers의 모델 코드를 그대로 가져오되, attention은 vLLM의 paged attention 커널로 바꿔 끼우고 linear 레이어는 병렬 레이어로 치환해서, transformers의 모델 정의 위에 vLLM의 서빙 최적화를 얹는 방식입니다. --model-impl transformers 플래그로 명시적으로 선택할 수도 있습니다.
Transformers backend는 처음에는 자체 구현이 없는 model을 위한 fallback이었지만, torch.compile·CUDA graph 호환과 fused kernel 치환이 추가되면서 지원 범위와 성능이 개선되었습니다. 2026년 기준 일부 architecture는 Transformers backend로만 지원되며, model 정의는 Transformers를 재사용하고 vLLM은 scheduling, KV cache 관리와 kernel integration에 집중하는 구성이 확대되고 있습니다. 성능은 model과 backend에 따라 다르므로 native implementation보다 항상 빠르다는 뜻은 아닙니다.
기타 상용 프레임워크
서빙 프레임워크 풍경을 좀 더 넓게 보면 이렇습니다.
- 오픈소스 - vLLM, SGLang 등 여러 serving engine
- 상용(proprietary) - Fireworks AI, Together AI, Friendli AI처럼 자체 최적화 기술을 가진 서빙 프레임워크 회사들이 존재하며, 활발히 펀딩을 받고 사업화를 진행하고 있습니다
오픈소스와 상용 솔루션 모두 앞서 다룬 batching·decoding·attention 최적화를 각자 방식으로 구현하고 있습니다.
정리
여기까지가 오늘 준비한 내용입니다. 흐름을 다시 한 번 짚어 보면, 먼저 Prefill과 Decode가 계산 측면에서 어떻게 다른가를 봤습니다. Prefill은 utilization이 높은 반면 Decode는 낮고, 이 비대칭을 메우기 위해 사람들이 어떤 최적화 기법들을 만들어 왔는지 차례로 살펴봤습니다.
먼저 batching: 여러 request를 묶어 처리하는 기본 발상에서 출발해, 시퀀스 길이가 들쭉날쭉해도 높은 utilization을 유지하기 위한 continuous batching이 등장했습니다. 시퀀스가 길어지면서 attention 자체가 dominant한 비용이 되는 문제는 Flash Attention, Paged Attention 같은 기법으로 풀고, 한 request 안 Decode 단계의 sequential dependency는 speculative decoding으로 검증 문제로 전환해 풀어냅니다.
Flash Attention을 깊이 들여다보면서 왜 이런 알고리즘을 PyTorch op으로는 표현할 수 없고 kernel programming이 필요한지를 짚었고, 마지막으로는 요즘 보편적으로 쓰이는 서빙 프레임워크(vLLM 등)를 깊이 들어가지는 않고 broad하게 훑어봤습니다.
오늘의 요점은 LLM inference 성능이 model 실행만으로 결정되지 않는다는 점입니다. PyTorch가 model과 compilation의 중심에 있고, 그 아래의 kernel programming과 그 위의 serving framework가 함께 batching, KV cache와 scheduling을 최적화합니다.
도입에서 본 그림으로 다시 돌아가면, LLM 추론 스택은 Open Pretrained LLM → Hugging Face 배포 → PyTorch → 커널 프로그래밍 + 서빙 최적화라는 구성으로 정리되고, 추론 특화 AI 반도체를 만드는 입장에서는 이 전체 스택을 빠짐없이 잘 받쳐주는 것이 성능의 관건입니다.
보충: Roofline을 수식으로 정리하기
본문에서 그림으로 본 Roofline 분석은 간단한 수식 몇 개로 정리할 수 있습니다. 어떤 연산(커널)이 수행해야 하는 총 연산량을 FLOPs, 메모리와 주고받아야 하는 총 데이터량을 Bytes라고 하면, Arithmetic Intensity는 그 비율입니다.
이 연산을 실제 하드웨어에서 돌렸을 때, 연산에 걸리는 시간과 메모리 접근에 걸리는 시간은 각각 다음과 같습니다.
하드웨어가 계산과 메모리 접근을 잘 겹쳐서(overlap) 실행한다고 가정하면 전체 실행 시간은 대략 이 되고(이 값은 이상적인 하한이고 실제 시간은 kernel 효율에 따라 더 깁니다), 이면 Compute Bound, 반대면 Memory Bound입니다. 이 경계를 하드웨어 수치로 옮기면, 칩마다 연산기를 모두 쓰려면 넘어야 하는 intensity 임계값이 정해집니다. Roofline 그래프에서 사선과 가로선이 만나는 ridge point가 이 값입니다.
예를 들어 H100의 bf16 기준 임계값은 약 300 FLOPs/byte 수준입니다. 메모리에서 1 byte를 들고 올 때마다 300번 가까이 연산을 해야 연산기가 놀지 않는다는 뜻입니다.
행렬곱의 FLOPs 세는 법: 내적 개수 × 2
의 2는 내적(dot product)에서 옵니다.
- 길이 벡터의 내적 = 곱셈 번 + 덧셈 번 = FLOPs
- = 내적 개 = FLOPs ( = 배치, 즉 한 step에 함께 처리하는 시퀀스 수. 아래 그림 기호와 같고, prefill처럼 시퀀스당 토큰이 개면 행 수는 )
즉 행렬곱의 FLOPs는 “관여하는 차원의 곱 × 2”이고, FLOPs 계산은 내적의 개수를 세는 문제입니다. Transformer는 행렬곱의 연쇄이므로, 아래 그림처럼 각 행렬곱의 shape만 적으면 전체 FLOPs와 파라미터 수를 기계적으로 셀 수 있습니다. “파라미터 개 모델의 forward pass ≈ 토큰당 FLOPs (학습은 backward까지 )“라는 근사도 여기서 나옵니다.
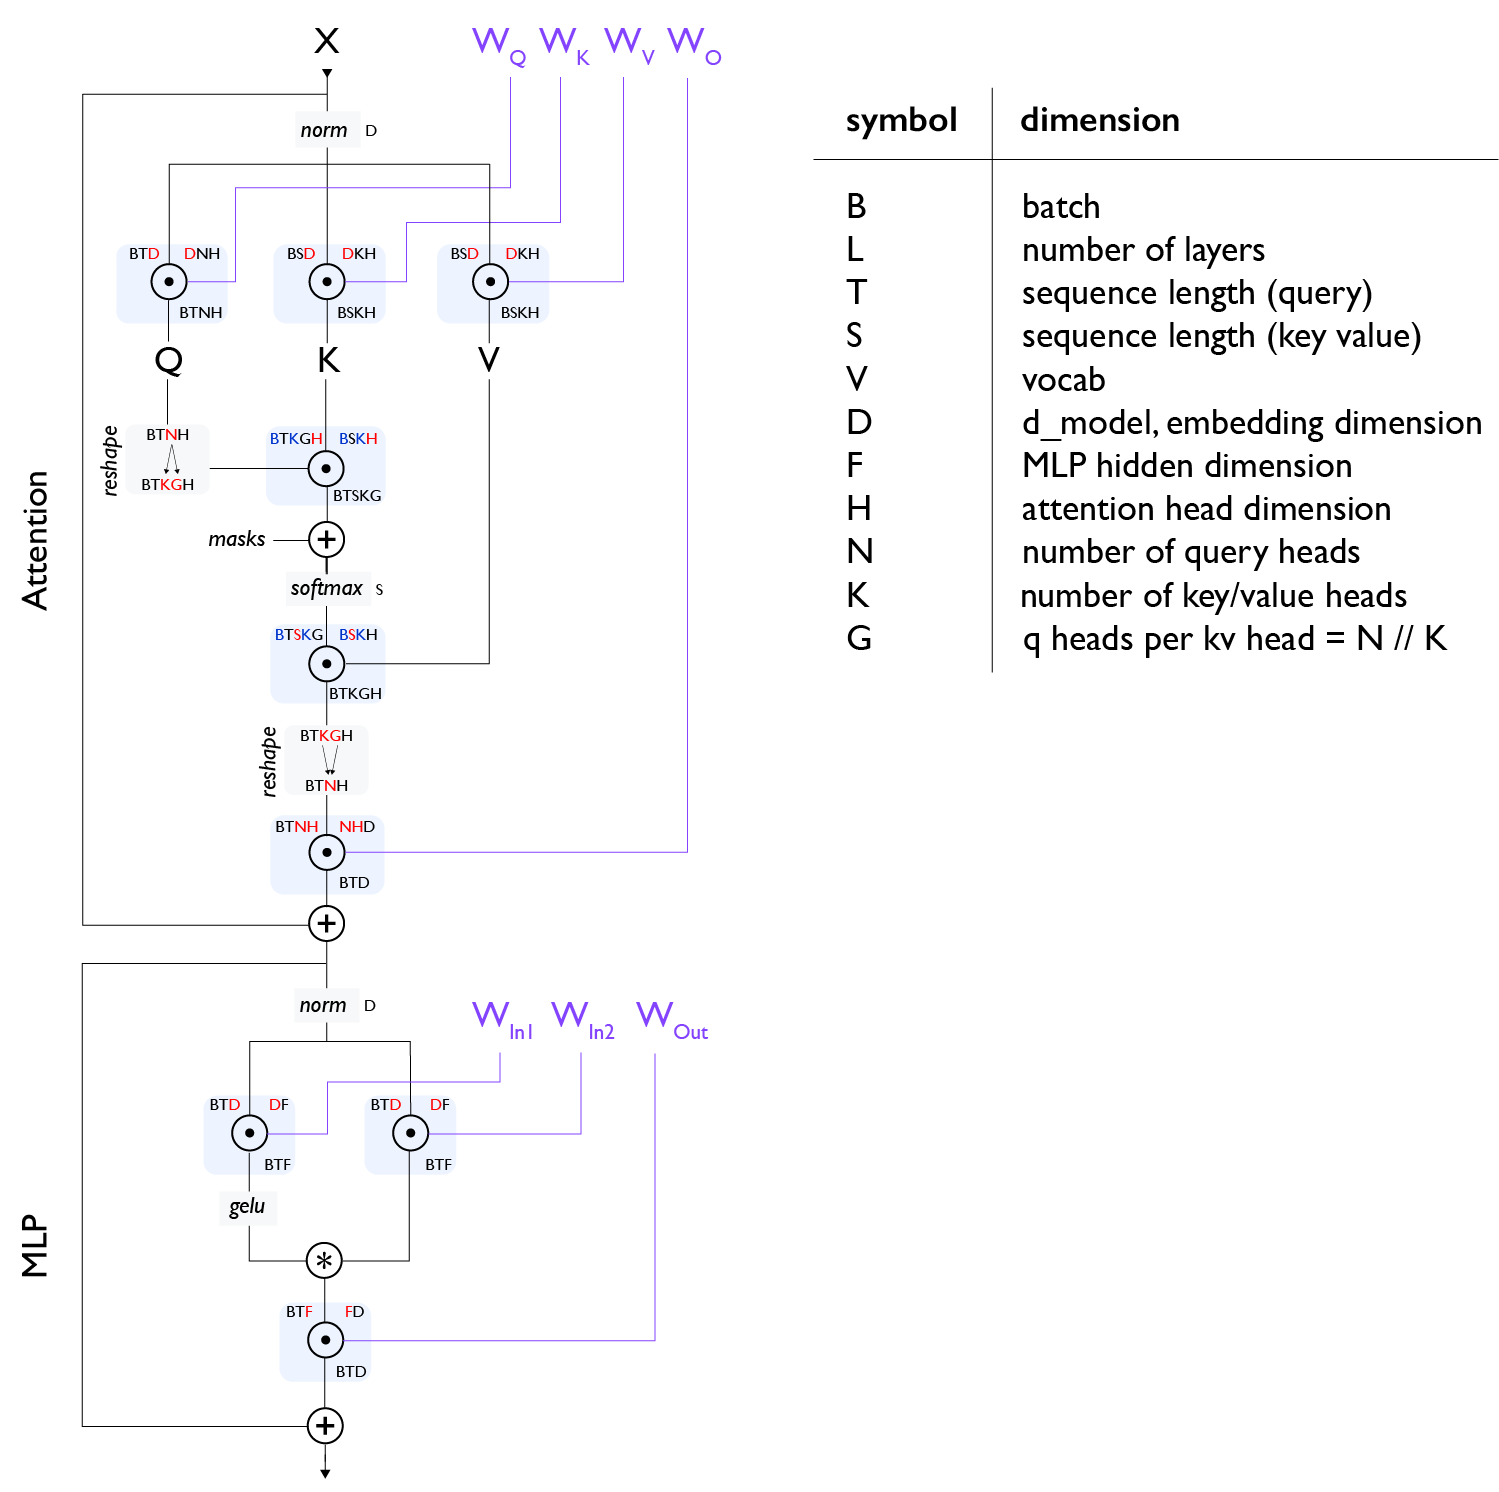
출처: All the Transformer Math You Need to Know (How to Scale Your Model, JAX Scaling Book)
행렬곱의 intensity는 배치 크기에 비례한다
이걸 LLM의 지배적 연산인 행렬곱에 대입해 보면 왜 Decode가 문제인지 숫자로 드러납니다. 배치 개 시퀀스의 decode step에서는 시퀀스당 토큰이 하나이므로 행렬곱은 이고, 연산량은 FLOPs입니다. 메모리 쪽은 입력 (개 원소)와 weight (개)를 읽고 결과 (개)를 써야 하는데, bf16은 원소당 2 bytes이므로 접근량은 bytes입니다(FLOPs의 2는 곱셈+덧셈, bytes의 2는 원소 크기로, 서로 다른 2입니다). 따라서,
즉 행렬곱의 intensity는 행 수, 곧 한 번에 처리하는 토큰 수에 거의 비례합니다. decode에서는 그것이 배치 이므로 임계값을 넘기려면 배치가 수백은 되어야 하고, prefill에서는 시퀀스 하나만으로도 행 수가 개라 쉽게 넘습니다. Prefill이 Compute Bound이고 Decode가 Memory Bound인 이유입니다.
예외: attention은 배치로도 구제되지 않는다
다만 이 “배치를 키우면 compute bound로 넘어간다”는 계산에는 중요한 예외가 하나 있습니다. weight는 배치 안의 모든 시퀀스가 공유하므로 배치가 커질수록 재사용이 늘어나지만, attention이 읽어야 하는 KV cache는 시퀀스마다 고유해서 배치를 아무리 키워도 재사용이 생기지 않습니다. 즉 Decode의 행렬곱(MLP·projection)은 배치로 compute bound까지 끌어올릴 수 있어도, attention 부분은 구조적으로 memory bound에 남습니다. GQA/MQA(여러 query head가 KV head를 공유)나 DeepSeek 계열의 MLA(latent 압축)처럼 KV cache 자체를 줄이는 아키텍처 레벨의 기법이 별도의 축으로 발전해 온 이유가 여기에 있습니다.
이 관점에서 Decode 한 스텝이 넘을 수 없는 하한선도 바로 나옵니다. dense 모델·full attention·스텝당 토큰 하나를 가정하면 매 스텝 모델 weight 전체와 배치에 담긴 KV cache 전체를 HBM에서 읽어야 하므로(MoE는 활성 expert의 weight만, sliding window나 MLA는 KV 읽기가 줄어듭니다),
작은 배치에서 decode의 토큰당 지연시간은 사실상 “모델 weight를 HBM에서 한 번 스트리밍하는 시간”이 하한이라는 뜻입니다.
참고: Rooflines (How to Scale Your Model, JAX Scaling Book)
참고: All About Transformer Inference (How to Scale Your Model, JAX Scaling Book)
여기서는 맛만 본 transformer 수식 계산의 전체 그림 - layer별 FLOPs·파라미터·KV cache 세기, 토큰 하나가 forward pass를 통과하는 여정 - 은 아래 두 자료가 잘 정리하고 있습니다.
참고: All the Transformer Math You Need to Know (How to Scale Your Model, JAX Scaling Book)
참고: Inside the Transformer: The Life of a Token — Aleksa Gordić
Footnotes
-
High Bandwidth Memory. DRAM die를 수직으로 쌓아 프로세서와 같은 패키지 안에서 매우 넓은 버스로 연결한 메모리. AI 가속기 오프칩 메모리의 사실상 표준으로, 일반 DRAM보다 대역폭이 훨씬 높지만 on-chip 메모리(SRAM)보다는 여전히 느립니다. ↩
-
GPU에서 같은 명령어를 함께 실행하는 스레드 묶음(NVIDIA 구현은 32개)으로, 하드웨어가 명령어를 발행하는 기본 단위입니다. Week 7의 SIMT 실행 모델에서 자세히 다룹니다. ↩
-
Tensor Memory Accelerator. Hopper에서 추가된 GMEM↔SMEM asynchronous bulk-copy mechanism입니다. Week 7의 “Hopper·Blackwell GEMM Kernel의 명시적 Pipelining” 절에서 자세히 다룹니다. ↩
-
Single Instruction Multiple Threads. 수많은 스레드가 같은 명령어를 함께 실행하는 CUDA의 실행 모델로, Week 7에서 GPU 설계 철학의 중심 개념으로 자세히 다룹니다. ↩
-
NVIDIA가 제공하는 비공개 소스 BLAS 구현으로, GPU에서 가장 빠른 GEMM의 기준점 역할을 합니다. Week 2에서
torch.matmul의 call stack이 도달하는 종착지로 등장했습니다. ↩ -
torch.fx가 제공하는 그래프 형태의 IR(intermediate representation). Dynamo가 캡처한 tensor 연산 trace가 이 형태로 저장되어 backend 컴파일러에 전달됩니다 (Week 3 참고). ↩