Week 5: Distributed Programming in PyTorch
PyTorch + NPU 온라인 모임 #5 | 2025-01-15
소개
이번 강의에서는 PyTorch의 분산 프로그래밍(Distributed Programming)에 대해 다룹니다. Week 1에서 PyTorch 2.0의 핵심 특징 중 하나로 MPI-like distributed programming model을 언급한 바 있는데, 이번 주에 그 내용을 본격적으로 파고듭니다.
오늘 다룰 주제들
여러 GPU와 여러 머신에 흩어진 프로세스들이 어떻게 서로를 찾고, 데이터를 주고받으며, 하나의 모델을 함께 학습시킬 수 있을까요? 이 질문에서 출발해 개념 → 실습 예제 → 내부 동작 → 고수준 패키지 순으로 나아갑니다.
- Overview - PyTorch 분산 프로그래밍의 뼈대
- MPI vs. OpenMP: PyTorch가 distributed memory를 가정하는 MPI 스타일을 따르는 이유
- 기본 개념 정리: node, process, world, rank, rendezvous
- 그 위에 자리잡는 process group과 c10d 통신 계층의 아키텍처
- torchrun을 활용한 distributed matmul 예제 - 프로세스 시작 → rendezvous →
all_reduce로 결과 수집 → 종료까지의 전체 흐름을 코드 수준에서 확인 - Device와 연결: CUDA 예제 - device 선택, 동기화, process group 생성/제거라는 접점으로 쪼개어 c10d 내부 동작 분석
- 모델 병렬화 패키지들 - 무엇이 GPU 메모리를 차지하는지에서 출발해, Data Parallel 축(DDP(Distributed Data Parallel) → ZeRO → FSDP(Fully Sharded Data Parallel))과 Model Parallel 축(TP(Tensor) · SP(Sequence) · PP(Pipeline) Parallel)이 각각 어떤 문제를 어떤 전략으로 푸는지, 그리고 이들이 모두 c10d의 collective communication 위에서 동작한다는 점
- (보충) 새로운 축(EP(Expert Parallel), CP(Context Parallel))과 DeepSpeed·Accelerate·Ray - MoE(Mixture of Experts)와 long context가 만든 새 병렬화 축, 그리고 같은 training loop가 프레임워크마다 어떻게 달라지는지에 대한 강의 이후 정리
MPI vs. OpenMP
병렬 프로그래밍 모델 중 가장 대표적인 것은 MPI(Message Passing Interface)와 OpenMP(Open Multi-Processing) 두 가지입니다. 이 두 모델이 가장 크게 다른 점은, 가정하고 있는 밑에 있는 메모리 시스템이 다르다는 것입니다.
MPI
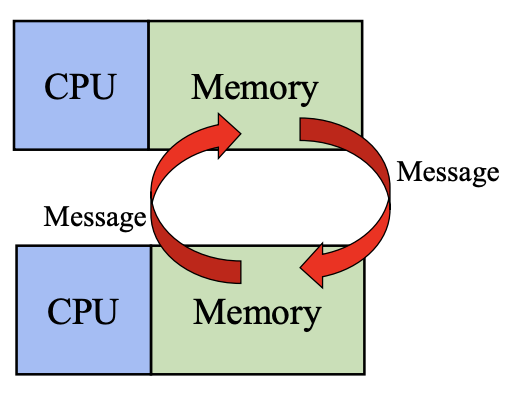
Distributed Memory
OpenMP
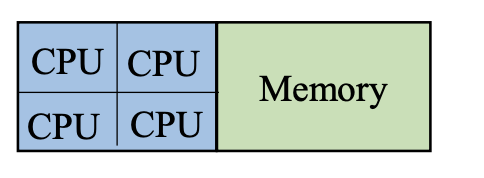
Shared Memory
OpenMP는 CPU들이 약간 tight하게 couple되어 있다고 생각하고, Shared Memory 모델을 가정합니다. 즉, 모든 프로세서들이 모든 메모리에 다 접근이 가능하다고 가정하는 것입니다. 반면 MPI는 Distributed Memory 모델 기반으로, 메모리들이 직접적으로 접근되지 않고 프로세서 간에 explicit하게 메시지를 주고받는 형태로 커뮤니케이션이 이루어진다고 가정합니다.
이렇게 MPI와 OpenMP가 구분되는데, PyTorch는 이 둘 중에서 MPI 스타일을 따르고 있다고 생각하시면 됩니다. GPU마다 메모리가 따로 있으므로 분산 메모리 모델이 GPU 학습 환경에 맞습니다.
Task 구성 방식의 차이
MPI와 OpenMP는 밑에 있는 메모리 시스템에 대한 가정뿐만 아니라, 실제 Task들이 어떻게 구성되어 있는가에 있어서도 차이가 있습니다. 이 차이가 메모리 시스템에 대한 가정 차이에서 기인하는 것인지는 확실하지 않지만, 두 모델이 병렬 작업을 조직하는 방식 자체가 근본적으로 다릅니다.
MPI
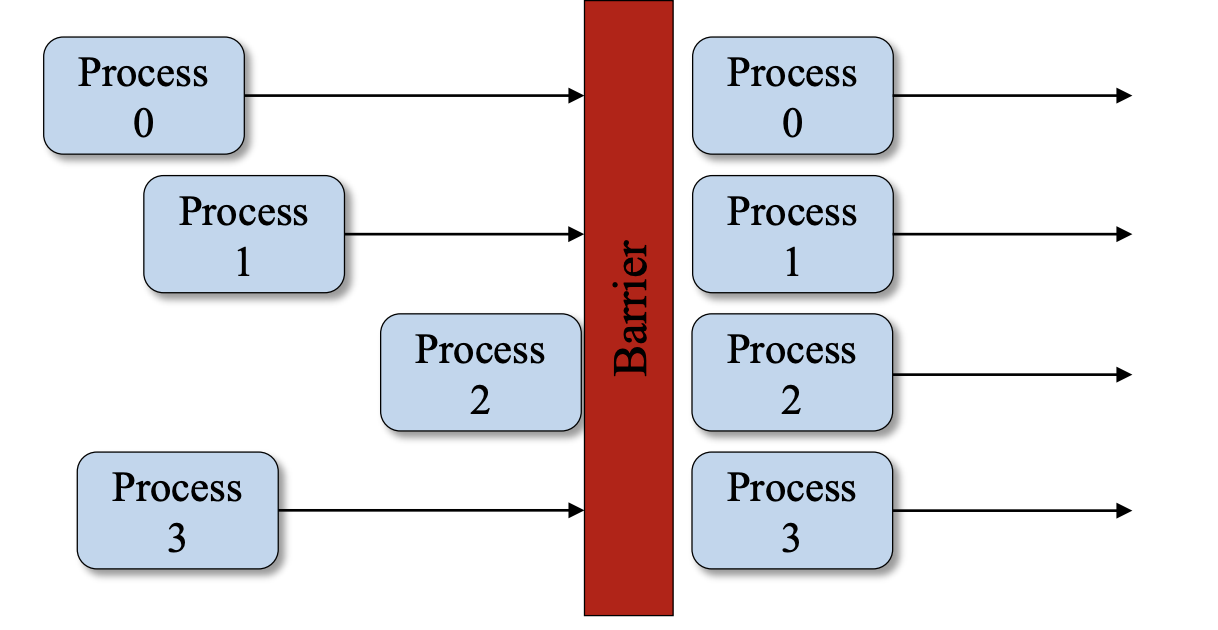
독립적인 프로세스들의 묶음
OpenMP
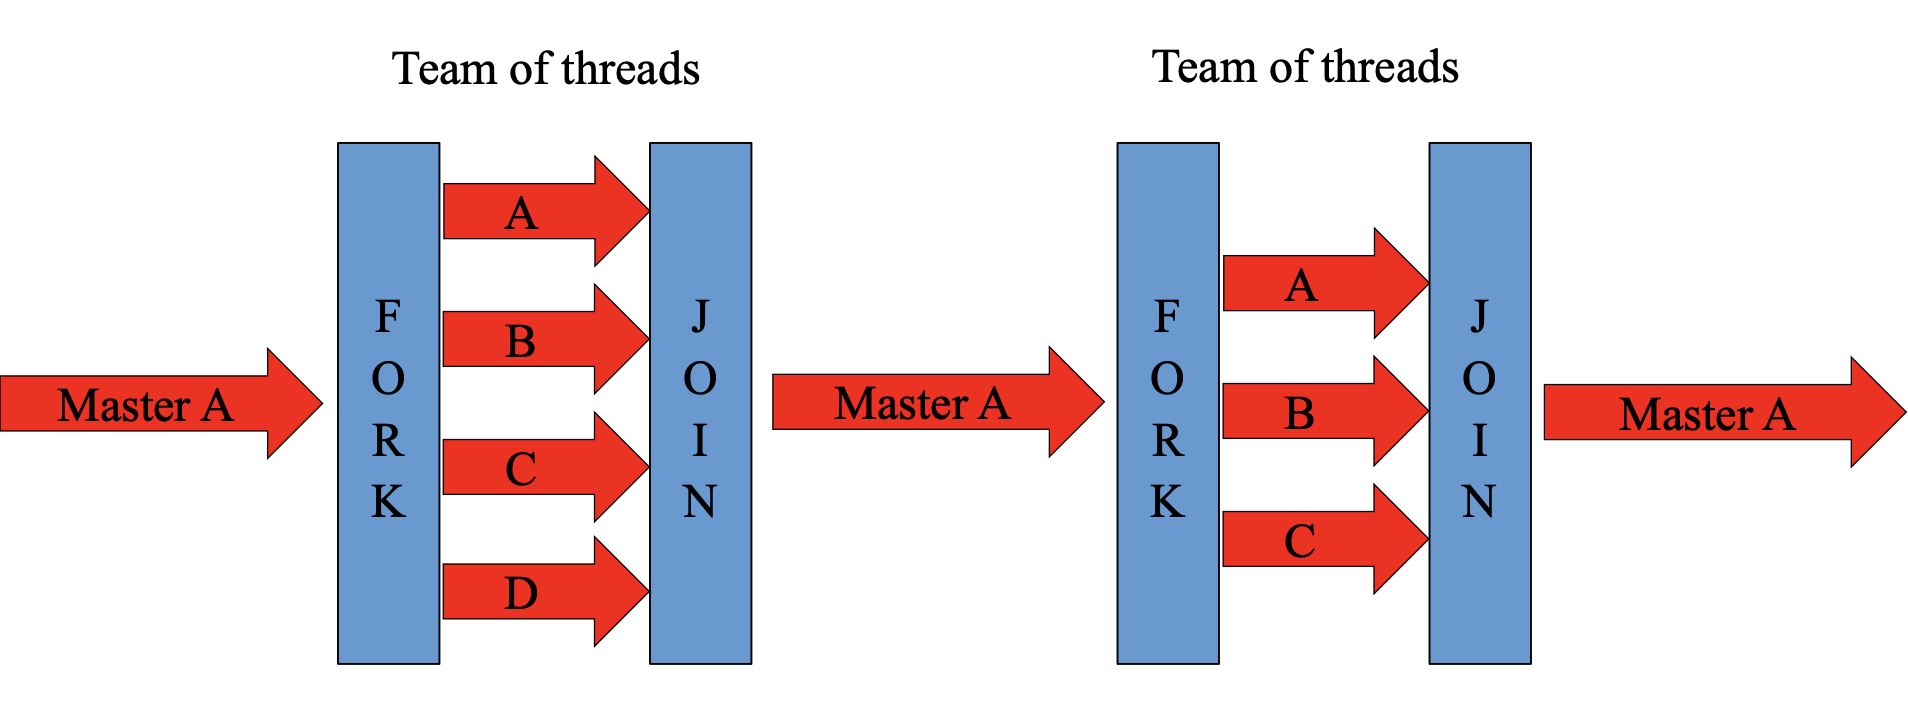
Master-Worker (Fork-Join) 모델
MPI는 정말 단독적으로 동작하는 프로세스들의 묶음이라고 생각하면 됩니다. 모든 프로세스들은 사실 다른 프로세스들과 상관없이 각자 시작하게 되고, 메시지 패싱을 하는 것 말고는 각자 자기가 할 일을 하면 됩니다. 예를 들어 reduction 같은 연산을 수행하기 위해 모든 프로세스가 끝날 때까지 기다려야 한다면 Barrier를 만들 수 있는데, 모든 프로세스가 이 Barrier를 만날 때까지 기다리고 있다가 다 모이면 다시 시작하는 방식으로 동작합니다. 이런 Barrier나 메시지 패싱에 의한 통신 외에는 프로세스 간에 별다른 관계가 없습니다.
OpenMP는 비슷하다고 할 수 있긴 하지만, 일단 Master에 해당하는 Task가 먼저 시작합니다. 그 Master로부터 병렬로 돌 수 있는 일들이 Fork되고, 끝나면 Join되어 다시 Master가 제어권을 가집니다. 이후 필요하면 다시 Fork하고 Join하는 식으로 병렬 태스크를 구성하도록 되어 있습니다.
PyTorch의 분산 학습에서 각 GPU 프로세스가 독립적으로 동일한 학습 스크립트를 실행하고, 필요한 시점에 gradient를 동기화하는 패턴은 MPI의 이러한 구조에서 비롯된 것입니다.
MPI 프로그램 구조
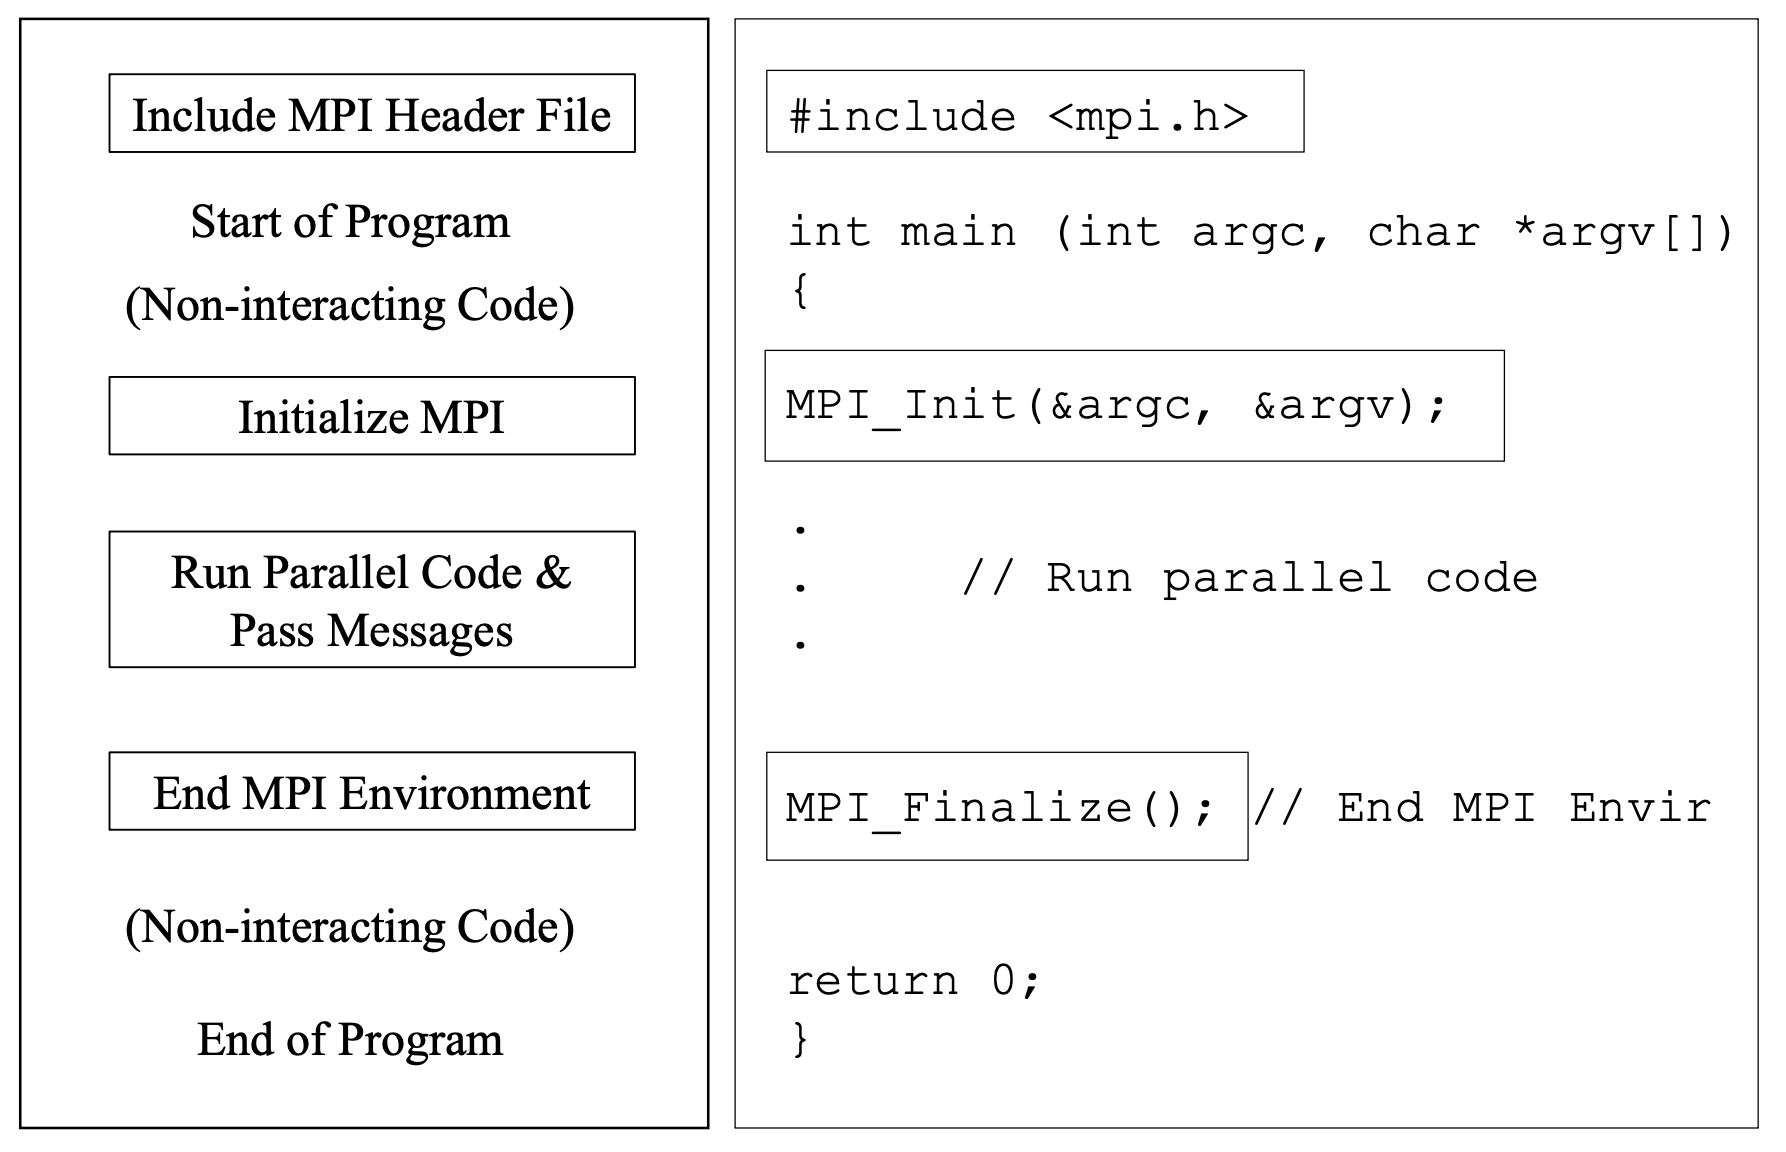
MPI 프로그램은 대체로 위와 같이 구성됩니다. MPI를 사용할 때 많은 경우 여러 프로세스에서 동일한 프로그램(single program)을 돌리는 방식이 일반적이며, PyTorch 분산 프로그램도 대부분 이 SPMD(single program, multiple data) 방식을 따릅니다. 실제로는 동일한 코드가 각각의 다른 프로세스에서 실행된다고 생각하면 됩니다.
각 프로세스는 일단 initialization(초기화)를 수행한 후, 실제로 병렬로 job을 수행합니다. 이 job에는 해당 task/process가 처리해야 할 부분에 대한 기술이 포함되어 있습니다. Single program 방식이라면 같은 job을 실행하되 rank에 따라 다르게 동작하도록 코드를 작성하게 됩니다. 예를 들어 if 문을 활용해 자신의 rank에 따라 실제로는 다른 일을 하도록 분기할 수도 있습니다. 모든 작업이 끝나면 finalize 단계를 거쳐 전체적으로 종료합니다.
PyTorch도 거의 비슷한 구조를 따르고 있으며, 뒤에서 살펴볼 torchrun 예제에서 이를 직접 확인할 수 있습니다.
PyTorch Distributed Programming: 기본 개념
PyTorch 분산 프로그래밍 모델은 MPI와 유사하게 process, rank, collective communication 개념을 사용합니다. 핵심 용어들을 먼저 정리합니다.
Node는 분산 job에 참여하는 host로, 물리 서버뿐 아니라 VM이나 container 환경일 수도 있습니다. 하나의 Node에서 여러 Process가 실행될 수 있으며 GPU 학습에서는 일반적으로 process 하나를 GPU 하나에 대응시킵니다. World는 해당 job에 참여하는 모든 process의 집합입니다.
Rank는 프로세스의 고유 식별자인데, 두 가지 종류가 있습니다. Global rank는 World 전체에서의 순서이고, local rank는 하나의 Node 내에서 다른 프로세스들을 구분하는 순서입니다. 아래 다이어그램에서 보듯이, 2개의 Node에 각각 3개의 프로세스가 있다면 global rank는 0~5, local rank는 각 Node 내에서 0~2가 됩니다.
Rendezvous(랑데뷰)는 분산 job의 membership을 구성하고 process별 rank, world size, rendezvous store 정보를 합의하는 과정입니다. torchrun agent는 rendezvous 결과를 이용해 각 node의 worker process를 실행합니다. Elastic job에서 membership이 바뀌면 worker group을 종료하고 새로운 rendezvous와 restart를 수행할 수 있지만, 실행 중인 process group에 node가 그대로 추가되는 것은 아닙니다.
Overall Architecture
PyTorch의 분산 프로그래밍 모델을 구성하는 주요 개념을 조금 더 자세히 살펴봅니다. 크게 Node와 Rendezvous 과정, 그리고 각 프로세스 내부에서 PyTorch가 동작하는 구조 두 관점으로 나누어 볼 수 있습니다.


1. Node와 Rendezvous 과정
Rendezvous는 참여 process의 membership과 초기화 정보를 구성합니다. 각 Process에는 Global rank와 Local rank가 부여되며, torchrun agent가 각 node에서 worker process를 실행합니다.
2. 각 프로세스 내부의 PyTorch 분산 처리 구조
하나의 Process를 확대해서 보면 그 안에서 PyTorch가 돌고 있고, 아래에서 위로 다음과 같은 세 개의 레이어로 구성됩니다.
- Backend
- 가장 맨 아래단에서 실제 통신을 담당합니다.
- NCCL1, MPI, Gloo 등 다른 라이브러리를 활용하여 CPU 또는 GPU 간의 프로세스 통신을 관장합니다.
- c10d2
- Week 2에서 본 core 계층
c10에 distributed의d를 붙인 이름으로, PyTorch 분산 통신의 기반 계층입니다. - 실제 Backend들이 이 레이어에 붙으며,
all-reduce,broadcast같은 Collective API의 인터페이스도 여기에 정리되어 있습니다.
- Week 2에서 본 core 계층
- High-level 패키지
- c10d 위에 올라가는 DDP, FSDP, TP, SP, PP 등의 모델 병렬화 패키지입니다.
- 사용자는 복잡한 분산 통신 로직을 직접 작성하지 않고도 이 패키지들을 활용해 여러 머신에서 PyTorch 모델을 병렬로 돌릴 수 있습니다.
Process Group
Process Group은 서로 통신하는 프로세스들의 집합입니다. 기본(default) process group으로 모든 프로세스를 하나로 묶을 수도 있고, 필요에 따라 여러 개의 subgroup으로 나눌 수도 있습니다. 예를 들어, 서로 다른 종류의 병렬화를 동시에 적용하려면 프로세스들을 여러 subgroup으로 나누어 각각 독립적으로 통신하도록 구성합니다.
Default process_group
process_group with 2 subgroups
Distributed Communication Layer (c10d)
c10d는 분산 통신을 위한 distributed communication API와 process group 구현을 제공하는 계층입니다. 크게 두 가지 통신 방식을 제공합니다.
Collective communication은 group의 process들이 정해진 패턴으로 data를 교환하는 방식입니다. DDP의 gradient 동기화와 FSDP의 parameter sharding 등이 collective를 사용합니다. P2P communication은 한 process가 다른 process로 data를 직접 전송합니다. Pipeline Parallel과 ring 방식의 Context Parallel 등이 대표적인 사용 사례입니다.
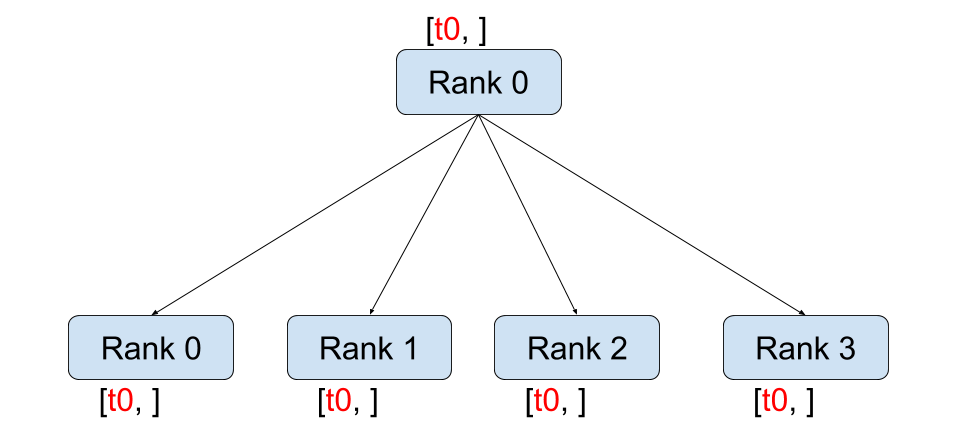
Collective Communication 연산들
c10d에는 보편적으로 쓰이는 collective communication API들이 폭넓게 정의되어 있습니다. 여기서는 그중 가장 자주 등장하는 연산들만 정리합니다.
참고: https://pytorch.org/tutorials/intermediate/dist_tuto.html
Scatter / Gather: 데이터를 쪼개서 나눠주고 다시 모으는 가장 기본적인 패턴
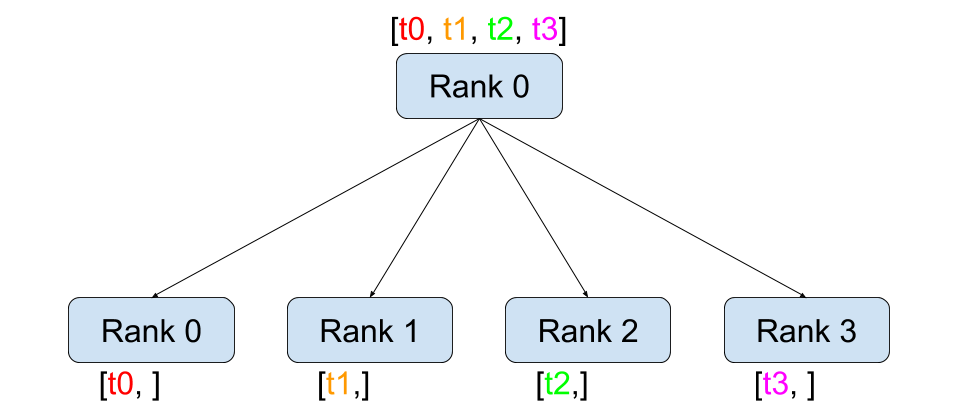
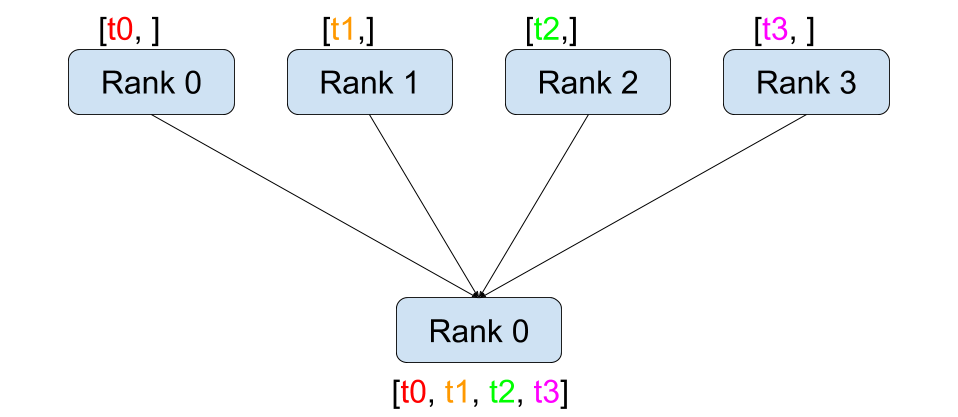
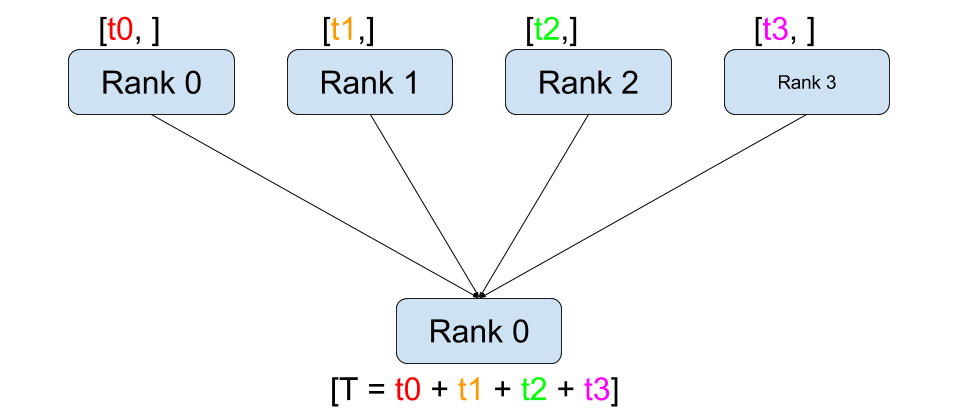
Reduce / All-Reduce: 여러 프로세스의 데이터를 하나로 합치는 연산. 분산 학습에서 gradient를 합산할 때 All-Reduce가 핵심적으로 사용됨
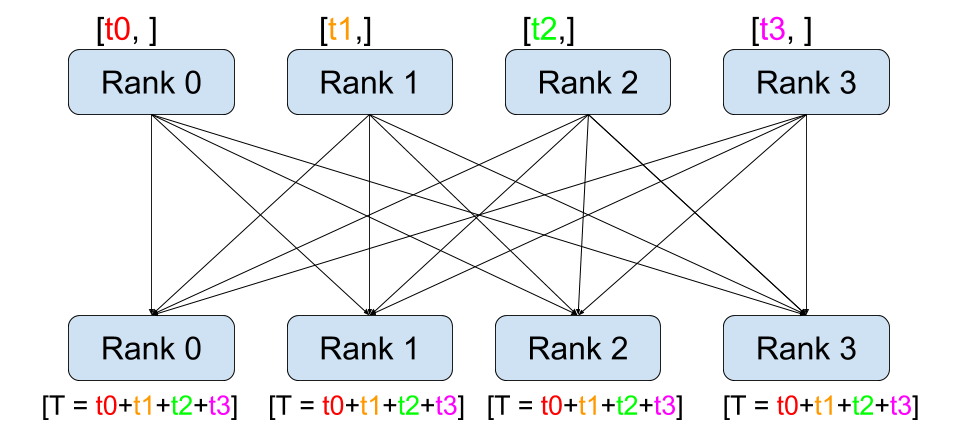
Broadcast / All-Gather: 한쪽의 데이터를 모든 프로세스로 퍼뜨리거나 모으는 연산
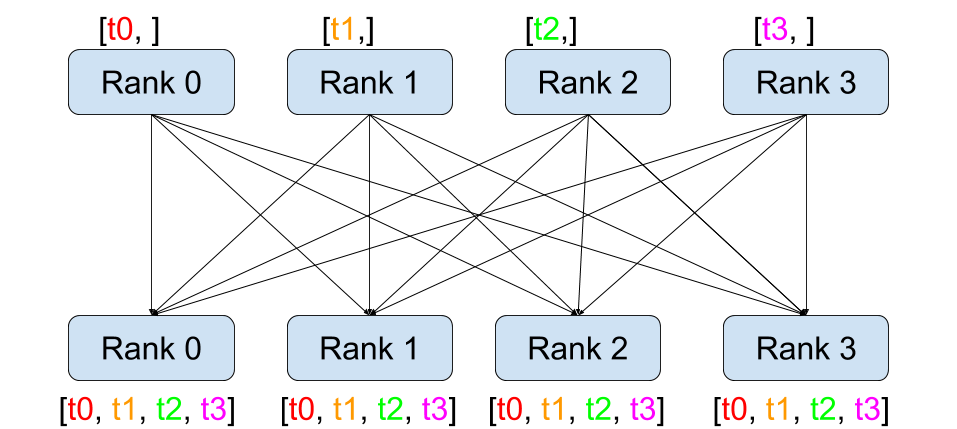
Reduce-Scatter / All-to-All: 위 연산들의 조합·일반형으로, 병렬화 패키지 내부에서 중요하게 쓰이는 연산
Communication Backends
c10d는 interface만 제공하고, 실제 통신 동작은 개별 하드웨어에 대한 communication backend에서 구현됩니다. PyTorch에 내장된 backend는 Gloo, NCCL, XCCL, MPI 네 가지이고, 그 외는 빌드 옵션이나 등록으로 추가합니다:
| Backend | 지원 Device | 비고 |
|---|---|---|
| Gloo | CPU 중심 | CPU collective에 권장. GPU 지원은 제한적 |
| NCCL | CUDA GPU | NVIDIA GPU 간 통신에 권장 |
| XCCL | Intel XPU | Intel XPU collective 지원 |
| MPI | MPI 구현에 따라 다름 | PyTorch를 source build할 때 MPI 지원을 포함해야 함 |
| UCC | 환경에 따라 다름 | 내장 아님. USE_UCC 빌드 옵션으로 추가하는 experimental backend |
Third-party communication backend도 등록할 수 있습니다. C++ 확장에서 c10d::ProcessGroup을 구현하고 Backend.register_backend()로 device와 backend를 연결하면 custom hardware의 collective implementation을 제공할 수 있습니다. 내부 virtual function의 정확한 개수는 PyTorch 버전에 따라 달라지므로 API 계약으로 사용하지 않습니다.
torchrun을 활용한 분산 행렬 곱셈 예제
개념 정리는 이 정도로 하고, 이제 실제로 분산 행렬 곱셈을 수행하는 예제로 전체 과정을 따라가 봅니다.
torchrun이란
torchrun은 PyTorch가 기본 제공하는 분산 프로그램 실행을 위한 top-level script입니다. 반드시 사용해야 하는 것은 아니며, c10d 등 안에 들어 있는 재료들을 직접 조합해서 비슷한 실행기를 만드는 것도 충분히 가능합니다. 표준 진입점으로 쓰면 각 node에서 torchrun을 띄우는 것만으로 worker process 생성, rendezvous, 환경변수 설정이 이루어져 노드들이 하나의 job을 함께 수행하게 됩니다.
torchrun --nnodes=2 --nproc_per_node=8 \
    --rdzv_id=job1 --rdzv_backend=c10d \
    --rdzv_endpoint=node1:29500 \
    dist_matmul_allreduce.py
각 node에서 실행할 때 torchrun에 넘기는 파라미터는 다음과 같습니다. 통신 backend(NCCL/Gloo)는 torchrun 인자가 아니라 스크립트 안의 init_process_group(backend=...)에서 정합니다.
| 파라미터 | 설명 |
|---|---|
--nnodes | 참여하는 node 개수 (elastic이면 MIN:MAX) |
--nproc_per_node | node당 worker process 개수. 보통 GPU 개수 |
--rdzv_backend | rendezvous backend. 여기서는 c10d |
--rdzv_endpoint | rendezvous host:port. 참여 node 중 하나를 지정 |
--rdzv_id | job 식별자. 같은 endpoint를 여러 job이 쓸 때 구분 |
dist_matmul_allreduce.py | 각 worker process가 실행할 PyTorch 스크립트 |
torchrun이 위 파라미터로 worker를 띄우면 각 프로세스는 initialization 단계를 거친 뒤, 자신의 rank에 해당하는 작업을 수행합니다.
클러스터 준비
torchrun을 시작하기 전에 클러스터 설정이 필요합니다. 가장 단순한 방법은 SSH 기반 설정으로, /etc/hosts에 클러스터의 모든 노드의 IP와 hostname을 등록하고, 모든 노드들 사이에 암호 없이 로그인이 가능하도록 세팅하는 것입니다. 이 외에도 Ray cluster, Kubernetes, Slurm workload manager, Horovod 등 다양한 클러스터 관리 도구를 사용할 수 있습니다.
이 강의에서 사용할 예제 클러스터는 GPU가 8개씩 달려 있는 두 개의 노드입니다:
192.168.0.2(rendezvous host 겸용)192.168.0.3
torchrun 실행
각 노드에서 다음과 같이 실행합니다. 두 노드가 완전히 같은 명령을 실행하며, 어느 노드가 몇 번인지는 rendezvous가 정합니다(--node_rank는 rdzv_backend=static에서만 쓰이고 c10d에서는 무시됩니다). 이것이 앞서 설명한 MPI 스타일의 “동일한 프로그램을 여러 프로세스에서 실행”하는 패턴입니다.
@ node 0 (192.168.0.2)
$ torchrun --nnodes=2 --nproc_per_node=8 \
    --rdzv_id=job1 --rdzv_backend=c10d \
    --rdzv_endpoint="192.168.0.2:29500" \
    dist_matmul_allreduce.py
@ node 1 (192.168.0.3)
$ torchrun --nnodes=2 --nproc_per_node=8 \
    --rdzv_id=job1 --rdzv_backend=c10d \
    --rdzv_endpoint="192.168.0.2:29500" \
    dist_matmul_allreduce.py
torchrun 수행 과정
torchrun을 실행하면 내부적으로 다음과 같은 단계를 거칩니다:
- torchrun 명령어 인자 parsing 및 초기화 - 위에서 지정한 파라미터들을 읽어들입니다.
- rendezvous - 각 노드의 torchrun agent가
rdzv_endpoint에 모여 참여 노드를 확정하고, 노드 순서(group rank)와 각 worker의 global rank,MASTER_ADDR/MASTER_PORT를 정합니다. worker는 아직 없습니다. - 프로세스 생성 - agent가
nproc_per_node만큼의 worker process를 생성하며RANK,LOCAL_RANK,WORLD_SIZE,MASTER_ADDR,MASTER_PORT를 환경변수로 넣어 줍니다. 이 예제에서는 노드당 8개, 총 16개의 프로세스가 만들어집니다. - Process별로 PyTorch 스크립트 실행 - 프로세스 그룹을 생성하면서 communication backend를 선택(nccl 혹은 gloo)하고, 데이터를 로딩 및 sharding한 뒤, 계산을 수행하고,
torch.distributed.all_reduce를 이용해 동기화한 후, 프로세스 그룹을 제거합니다. - 부가 기능 - fault tolerance를 위해 checkpointing과 logging을 지원합니다.
--max-restarts=N옵션으로 실패 시 N번까지 재시작을 시도할 수 있습니다.
Rendezvous 상세
rendezvous는 분산 job에 참여할 process의 membership과 초기화 정보를 합의하는 과정입니다. torchrun agent는 이 결과로 worker에 필요한 환경 변수를 설정합니다.
1. rendezvous의 역할
- 분산 학습에 참여할 머신들의 집합을 결정하고 그 정보를 공유
- 모든 프로세스가 참여 준비를 마칠 때까지 대기
- 각 프로세스에 고유한 rank를 할당하고 일관된 distributed environment를 설정
2. 실행 과정
- c10d backend 초기화 - IPC에 사용할 c10d backend를 먼저 띄웁니다. PyTorch의
DynamicRendezvousHandlerclass가 사용되며,rdzv-endpoint로 지정된 노드에서 rendezvous backend가 host됩니다. - Rendezvous endpoint에 연결 - 각 프로세스가 endpoint로 접속합니다.
- 모든 프로세스의 join을 대기 - 참여하기로 한 프로세스가 전부 모일 때까지 block합니다.
- rank 할당 및 실행 준비 완료 - 각 프로세스에 고유 rank가 부여되고 distributed environment 세팅이 마무리됩니다.
이 과정이 끝나면 비로소 PyTorch script가 시작되고, 각 프로세스는 자신에게 할당된 학습 task를 수행합니다.
rendezvous는 fault tolerance에도 쓰입니다. Elastic mode에서 node나 worker가 실패하면 torchrun은 worker group을 재시작하고, 남아 있거나 새로 합류한 worker들로 rendezvous를 다시 수행할 수 있습니다. 학습 계산은 마지막 checkpoint부터 재개해야 하므로 학습 상태를 복구하려면 별도의 checkpoint 저장이 필요합니다.
Task 수행 코드
rendezvous가 끝나면 torchrun은 지정된 PyTorch 스크립트를 열어 본격적인 작업을 수행합니다. 여기서는 간단한 행렬 곱셈(matmul)을 분산으로 수행하는 예제를 통해 그 흐름을 따라가 봅니다. 먼저 top-level 진입 코드입니다.
if __name__ == "__main__":
    n = 16000
    rank = int(os.environ.get("RANK"))  # torchrun이 넣어 준 global rank
    if rank == 0:
        # rank 0만 실제 데이터를 로드 (열마다 값이 달라야 분할 오류가 드러남)
        A = torch.arange(n * n, dtype=torch.float32).reshape(n, n) / n
        B = torch.ones(n, n)
    else:
        # 나머지 rank는 broadcast로 받을 빈 텐서만 준비
        A, B = torch.empty(n, n), torch.empty(n, n)

    result = dist_matmul_allreduce(
        A, B, rank,
        int(os.environ.get("LOCAL_RANK")),
        int(os.environ.get("WORLD_SIZE")))

    if rank == 0:
        print(result)  # 최종 결과 출력도 rank 0만
이 코드에서 MPI 스타일의 역할 분담이 그대로 드러납니다.
- Rank 0: 전체 initial data를 실제로 로드해서 다른 프로세스에 뿌릴 준비
- 그 외 rank: 같은 모양의 빈 텐서(
torch.empty)만 미리 만들어 두고 broadcast 받을 준비 - 공통 (모든 rank):
dist_matmul_allreduce를 호출해 실제 분산 연산 수행 - Rank 0: 모인 최종 결과를 출력
분산 연산은 dist_matmul_allreduce 함수가 수행합니다.
def dist_matmul_allreduce(
        A, B, rank, local_rank, world_size):
    # init: device 지정(local rank) + 통신 backend 선택
    torch.cuda.set_device(local_rank)
    dist.init_process_group(backend="nccl")
    # NCCL은 CUDA tensor만 지원하므로 먼저 GPU로 이동
    device = torch.device(f"cuda:{local_rank}")
    A, B = A.to(device), B.to(device)
    # rank 0이 가진 A, B를 모든 rank에 전달
    dist.broadcast(A, 0)
    dist.broadcast(B, 0)
    # 조각 선택은 global rank로
    local_A, local_B = distributed_data(
        A, B, rank, world_size)
    # job: 부분 곱 계산 후 all_reduce로 합산
    local_result = local_matmul(
        local_A, local_B)
    dist.all_reduce(
        local_result, op=dist.ReduceOp.SUM)
    # finalize: 통신 자원 반환
    dist.destroy_process_group()
    return local_result
함수는 MPI 프로그램의 init → job → finalize 구조를 그대로 따릅니다.
- 초기 설정
torch.cuda.set_device(local_rank)- 한 노드에 여러 프로세스가 떠 있을 수 있으므로, local rank를 기반으로 이 프로세스가 사용할 디바이스를 명시적으로 지정합니다.dist.init_process_group(backend="nccl")- 어떤 backend(NCCL / Gloo / MPI 등)로 통신할지 결정합니다.
- 데이터 로딩 및 분산 - 먼저 tensor를 GPU로 옮기고(NCCL backend는 CUDA tensor만 지원),
dist.broadcast로 rank 0이 가진 A, B를 모든 프로세스에 전달한 뒤,distributed_data에서 각 rank가 담당할 부분만 잘라내 local A, local B를 준비합니다. (실제로는scatter로 각 rank에 필요한 조각만 보내면 메모리를 더 아낄 수 있지만, 여기서는 단순화를 위해 broadcast를 사용합니다.) - 분산 행렬 연산 -
local_matmul로 각 프로세스가 자신의 부분 곱을 계산하고,dist.all_reduce로 모든 rank의 결과를 합산해 최종 결과를 만듭니다. - 연산 종료 및 정리 -
dist.destroy_process_group()을 호출해 사용한 통신 자원을 반환하고, 결과를 리턴하면서 함수가 종료됩니다.
distributed_data와 local_matmul이 실제 일을 하는 부분입니다.
def distributed_data(A, B, rank, world_size):
    n = A.shape[0]
    k = n // world_size  # rank당 담당 폭
    # global rank로 자기 조각만 선택
    # (local rank는 device 선택에만 사용)
    # A는 column, B는 row 방향으로 자름
    local_A = A[:, rank*k:(rank+1)*k]
    local_B = B[rank*k:(rank+1)*k, :]
    return local_A, local_B

def local_matmul(local_A, local_B):
    # (n, k) @ (k, n) = (n, n) 부분 곱
    return torch.matmul(local_A, local_B)
distributed_data 함수는 broadcast로 받은 A, B에서 자신의 rank에 해당하는 부분만 골라 local A, local B로 준비합니다. A를 열 방향으로 , B를 행 방향으로 로 나누면 이므로, rank 가 를 계산하고 all_reduce(SUM)로 합산하면 전체 곱이 됩니다. 조각 선택에는 world 전체에서 유일한 global rank를 써야 합니다. local rank로 자르면 두 번째 노드가 첫 노드와 같은 조각을 다시 더하고 뒤쪽 조각은 아무도 계산하지 않아 결과가 틀립니다.
Q. NCCL 같은 backend는 결국 CPU를 쓸지 GPU를 쓸지를 정하는 셋팅인가요? 아닙니다. backend는 collective 통신에 쓸 라이브러리를 고르는 설정이고, 계산이 CPU에서 되는지 GPU에서 되는지는 tensor가 놓인 device가 정합니다. 다만
nccl은 CUDA tensor만 통신할 수 있으므로 실질적으로 NVIDIA GPU 클러스터에서 쓰는 선택입니다.Q. 한 rendezvous 안의 노드들이 서로 다른 backend로 동작할 수 있나요? 확실하진 않지만 실험상으로는 모두 같은 backend여야 동작했고, 다르게 섞으면 에러가 났던 사례가 있습니다.
Device와 연결: CUDA 예제
dist_matmul_allreduce는 PyTorch가 실행된 이후에 호출되는 함수이고, 그 컨텍스트 안에서 device와 backend가 실제 연결됩니다. 큰 그림으로 보면 PyTorch의 분산 연산은 c10d 뒤에 붙어 있는 NCCL backend를 통해 CUDA와 직접 연결되며, 다음과 같은 지점들이 그 접점입니다.
- GPU 선택 -
torch.cuda.set_device(local_rank)로 어느 GPU를 쓸지 결정 - Backend 선택 -
dist.init_process_group(backend="nccl")로 어떤 통신 backend를 쓸지 결정 - Collective communication -
dist.broadcast,dist.all_reduce등이 NCCL backend를 거쳐 CUDA interface 위에서 수행 - 종료 처리 - 모든 작업이 끝난 뒤 process group을 정리하는 과정도 CUDA와 맞물려 동작
아래에서는 dist_matmul_allreduce의 CUDA 접점 네 군데를 하나씩 살펴봅니다.
def dist_matmul_allreduce(A, B, rank, local_rank, world_size):
    # 1. CUDA Device 선택
    torch.cuda.set_device(local_rank)
    # 3. Process Group 생성 및 통신 채널 설정
    dist.init_process_group(backend="nccl")
    device = torch.device(f"cuda:{local_rank}")
    A, B = A.to(device), B.to(device)
    dist.broadcast(A, 0)
    dist.broadcast(B, 0)
    local_A, local_B = distributed_data(A, B, rank, world_size)
    local_result = local_matmul(local_A, local_B)
    # 2. 동기화 (CUDA Runtime)
    dist.all_reduce(local_result, op=dist.ReduceOp.SUM)
    # 4. Process Group 제거
    dist.destroy_process_group()
    return local_result
1: CUDA Device 선택
torch.cuda.set_device()로 각 프로세스가 사용할 GPU를 명시적으로 선택합니다. 여기서 Rendezvous가 지정해 준 LOCAL_RANK 환경변수를 사용하는데, 이는 하나의 node 내에서만 unique한 rank입니다 (전체 World에서 unique한 것은 RANK 환경변수). 이렇게 해서 node 내에서 process : device == 1 : 1 관계를 만듭니다.
이 호출은 torch.distributed.init_process_group()보다 먼저 수행되어야 합니다. 명시적으로 device를 지정하지 않으면 모든 프로세스가 0번 device를 사용하게 되어 GPU 자원이 낭비됩니다. PyTorch의 CUDA 초기화는 lazy해서 보통 첫 CUDA tensor를 만들 때 일어나지만, torch.cuda.set_device()는 예외로 그 자리에서 초기화를 트리거합니다(THCPModule_setDevice_wrap이 device_lazy_init을 먼저 호출합니다).
아래 표는 2개 노드, 노드당 8개 GPU 환경에서 RANK와 LOCAL_RANK의 관계를 보여줍니다:
| 0 | 1 | … | 7 | 8 | 9 | … | 15 | ||
|---|---|---|---|---|---|---|---|---|---|
| RANK | 0 | 1 | … | 7 | 8 | 9 | … | 15 | |
| LOCAL_RANK | 0 | 1 | … | 7 | 0 | 1 | … | 7 |
2: 동기화 (CUDA Runtime)
torch.distributed.all_reduce()가 호출되면 내부적으로 두 단계를 거칩니다. 먼저 PyTorch의 ProcessGroup C++ binding으로 전달되어 초기화된 ProcessGroup을 확인하고, NCCL backend를 사용하는지 확인합니다. 그 다음 ProcessGroupNCCL에서 NCCLComm 객체를 사용하여 NCCL 통신을 준비하고, NCCL library의 ncclAllReduce() 함수를 호출합니다.
all_reduce는 기본값(async_op=False)에서 내부적으로 work.wait()까지 호출하고 돌아옵니다. NCCL backend에서 이 wait()는 CPU를 세우는 것이 아니라 현재 CUDA stream이 NCCL stream의 완료를 기다리도록 의존성을 거는 것이라, 이후 같은 stream에 넣는 kernel은 통신 결과가 준비된 뒤 실행됩니다(CPU까지 막으려면 TORCH_NCCL_BLOCKING_WAIT=1). async_op=True를 주면 work 객체를 돌려받아 통신과 다른 작업을 겹칠 수 있습니다:
# non-blocking all_reduce() 예시
work = dist.all_reduce(
    local_result,
    op=dist.ReduceOp.SUM,
    async_op=True
)
do_something()  # 통신이 진행되는 동안 다른 작업 수행
work.wait() # 현재 stream에 통신 완료 의존성 설정distributed_c10d.py의 해당 부분은 다음과 같습니다:
# torch/distributed/distributed_c10d.py
def all_reduce(tensor, op=ReduceOp.SUM,
               group=None, async_op=False):
    ...
    work = group.allreduce([tensor], opts)  # backend(NCCL 등)에 위임
    if async_op:
        return work    # 호출자가 나중에 work.wait()
    else:
        work.wait()    # 현재 stream에 완료 의존성 설정 (CPU를 막지 않음)
3: Process Group 생성 및 통신 채널 설정
torch.distributed.init_process_group()은 프로세스들 간의 통신 채널을 생성하는 함수입니다. NCCL(GPU), GLOO(GPU/CPU), MPI(CPU, CUDA-aware 빌드 시 GPU) 등의 backend를 지정할 수 있으며, 초기화 방법(init_method), timeout, world size, rank 등의 metadata도 여기서 설정합니다.
초기화 방법(init_method)은 세 가지입니다. 기본값 env://는 torchrun이 넣어 준 환경변수(MASTER_ADDR, MASTER_PORT, RANK, WORLD_SIZE)를 읽는 방식으로, 앞의 예제처럼 인자 없이 init_process_group(backend="nccl")을 부르면 이 방식입니다. 그 외에 TCP 주소를 직접 명시하거나 공유 filesystem을 쓰는 방법이 있습니다:
# 주소를 직접 명시한 초기화
dist.init_process_group(
    backend="nccl",
    init_method='tcp://127.0.0.1:23456',
    world_size=world_size,
    rank=rank
)
# 공유 filesystem을 통한 초기화
dist.init_process_group(
backend="nccl",
init_method='file:///mnt/nfs/sharedfile',
world_size=world_size,
rank=rank
)내부적으로는 MASTER_ADDR, MASTER_PORT, WORLD_SIZE, RANK를 모아 key-value store인 TCPStore에 연결합니다. torchrun 없이 직접 띄우면 rank 0 프로세스가 TCPStore 서버를 열고 나머지가 접속하지만, torchrun 아래에서는 rendezvous 때 agent가 이미 서버를 열어 두었으므로 worker 전원이 client로 접속합니다(_create_c10d_store docstring).
# torch/distributed/rendezvous.py
# init_method에 없으면 torchrun이 설정한 환경변수에서 수집
if "rank" in query_dict:
    rank = int(query_dict["rank"])
else:
    rank = int(_get_env_or_raise("RANK"))
if "world_size" in query_dict:
    world_size = int(query_dict["world_size"])
else:
    world_size = int(_get_env_or_raise("WORLD_SIZE"))
master_addr = _get_env_or_raise("MASTER_ADDR")
master_port = int(_get_env_or_raise("MASTER_PORT"))
use_libuv = _get_use_libuv_from_query_dict(query_dict)
# TCPStore 생성 또는 접속 (torchrun 아래에서는 agent의 store에 client로 접속)
store = _create_c10d_store(
    master_addr, master_port, rank, world_size, timeout, use_libuv
)
4: Process Group 제거
torch.distributed.destroy_process_group()은 통신 자원을 해제하고 memory 등의 resource를 정리하는 함수입니다. 이 함수 자체는 barrier가 아니라 backend를 순서대로 shutdown할 뿐이지만, 모든 rank가 같은 순서로 호출해야 합니다. 일부 rank만 먼저 호출하거나 아직 끝나지 않은 collective가 남아 있으면 NCCL 버전에 따라 hang이 날 수 있습니다.
NCCL backend의 경우, 내부적으로 NCCLComm 객체가 소멸되면서 ncclCommDestroy()를 호출하여 GPU 간 통신에 사용된 resource를 정리합니다.
PyTorch가 제공하는 모델 병렬화 패키지들
여기까지가 c10d level의 저수준 분산 통신입니다. 실제 model 학습에서는 이런 저수준 API를 직접 사용하기보다 PyTorch의 고수준 병렬화 package를 사용하는 경우가 많습니다. 병렬화 기법의 이름은 많지만(DDP, FSDP, ZeRO, TP, SP, PP, …), 무엇을 복제하고 무엇을 쪼개는지로 나눌 수 있습니다. 계산은 그대로 두고 학습 상태(parameter·gradient·optimizer state)를 어떻게 배치할지의 축이 Data Parallel 계열(DDP, ZeRO, FSDP)이고, 계산 자체를 쪼개는 축이 Model Parallel 계열(TP, SP, PP)입니다. Expert Parallel(EP)과 Context Parallel(CP)은 강의 뒤의 보충 절에서 다룹니다.
이 구분은 PyTorch 공식 문서의 계층 구분과 대응됩니다. PyTorch Distributed Overview는 분산 스택을 병렬화 API(DDP, FSDP2, TP, PP) → sharding primitive(DTensor, DeviceMesh) → 통신 계층(c10d) → launcher(torchrun)의 4개 층으로 정리하는데, 이 강의가 아래(c10d)에서 위(병렬화 패키지)로 올라온 순서를 뒤집으면 정확히 그 구조입니다. 모델 크기에 따른 선택 기준(한 GPU에 들어가면 DDP, 안 들어가면 FSDP2, FSDP2로도 한계에 부딪히면 TP/PP)도 공식 권고와 아래에서 볼 내용이 일치합니다.
무엇이 GPU 메모리를 차지하는가
전략을 비교하기 전에, 학습 중 GPU 메모리에 무엇이 올라가 있는지부터 보겠습니다. 학습 상태는 크게 네 가지입니다:
- Parameter: 모델 weight 자체. mixed precision3이면 fp16/bf16으로 parameter당 2 byte
- Gradient: backward가 만들어내는 값. parameter와 같은 크기로 2 byte
- Optimizer state: Adam 기준 fp32 master weight(4 byte) + momentum(4 byte) + variance(4 byte) = 12 byte
- Activation: forward 중간 결과. batch/sequence 길이에 비례하며, Week 4에서 본 activation checkpointing으로 줄이는 대상
위와 같이 fp16/bf16 parameter와 gradient, fp32 master weight 및 Adam state를 사용하는 구성에서는 parameter당 약 16 byte가 필요합니다. 이 가정에서 7B model의 weight는 14GB지만 학습 상태는 activation을 제외해도 약 112GB입니다. Inference에서는 2 byte면 되는 parameter가 이 training 구성에서는 8배의 상태를 요구한다는 차이가 분산 학습 전략의 출발점입니다. 실제 사용량은 optimizer, gradient dtype, mixed-precision 구현과 activation에 따라 달라지며, 각 전략은 이 상태 중 무엇을 rank별로 sharding할지 결정합니다.
Data Parallel 축: DDP → ZeRO → FSDP
Distributed Data Parallel(DDP)은 모델을 잘게 나누는 게 아니라 동일한 모델을 여러 GPU에 복제해 두고 데이터를 GPU별로 분배하는 Data Parallel 방식입니다. 각 GPU가 서로 다른 데이터 배치를 처리해서 throughput을 끌어올리고, 매 step마다 gradient를 all_reduce로 모아 평균한 뒤 모든 GPU의 모델 파라미터를 동일하게 업데이트합니다. 위의 메모리 구조로 보면, DDP는 16 byte/param 전체를 모든 GPU가 중복해서 들고 있는 구성입니다.
Microsoft의 ZeRO(Zero Redundancy Optimizer, 2019) 논문은 이 중복을 단계적으로 제거하자는 제안입니다:
- Stage 1: optimizer state(12 byte)만 rank들에 나누어 sharding
- Stage 2: gradient까지 sharding
- Stage 3: parameter까지 sharding하고, 계산 직전에 all-gather로 모았다가 끝나면 버림
Fully Sharded Data Parallel(FSDP)은 ZeRO Stage 3 algorithm을 PyTorch에 구현한 것입니다. Parameter를 rank별로 나눠 두고, module을 계산하기 직전에 필요한 조각을 all-gather해 완전한 parameter를 만든 뒤 계산이 끝나면 다시 reshard합니다. Gradient는 reduce-scatter하고 optimizer state도 rank별로 나눠 유지합니다. 즉 쪼개는 것은 학습 상태이고, 각 rank는 서로 다른 data batch에 대해 동일한 module 계산을 수행하므로 여전히 Data Parallel입니다.
계보를 시간순으로 정리하면 다음과 같습니다:
- 2019: Microsoft가 ZeRO 논문 발표
- 2020: Microsoft가 ZeRO의 구현체인 DeepSpeed 라이브러리 공개
- 2021: Meta가 FairScale 라이브러리에서 ZeRO-3에 해당하는 FSDP를 구현
- 2022: FairScale의 FSDP가 PyTorch 1.11에 prototype 기능으로 편입됨(이후 beta를 거쳐 안정화). 이 버전이 FSDP1
- 2024: per-parameter sharding으로 재설계한 FSDP2(
fully_shard) 공개
DeepSpeed는 ZeRO Stage 1~3를 제공하는 library이고, FSDP의 중심은 ZeRO-3에 해당하는 full sharding입니다. 다만 FSDP에서도 설정에 따라 parameter를 forward 이후에 바로 reshard할지 선택할 수 있어, ZeRO-2와 비슷한 메모리·통신 trade-off를 구성할 수 있습니다. 동작상 가까운 설정을 정리하면 다음과 같습니다:
| ZeRO stage | Sharding 대상 | FSDP1 설정 | FSDP2 설정 |
|---|---|---|---|
| ZeRO-0 | 없음 (전부 복제) | NO_SHARD | 해당 없음 (DDP를 쓰면 됨) |
| ZeRO-1 | optimizer state | 대응 없음 | 대응 없음 |
| ZeRO-2 | + gradient | SHARD_GRAD_OP | reshard_after_forward=False |
| ZeRO-3 | + parameter | FULL_SHARD | reshard_after_forward=True |
DeepSpeed와의 실무적 차이는 뒤의 보충 섹션에서 다룹니다.
FSDP에는 두 세대의 구현이 있습니다. FSDP1은 FullyShardedDataParallel wrapper API이고, FSDP2는 fully_shard와 DTensor를 사용하는 새 구현입니다. 공식 tutorial은 FSDP1을 deprecated로 표시하고 FSDP2를 권장합니다. 소스에 클래스 수준의 deprecation warning은 없어 기존 code는 그대로 동작하지만, 신규 구성에는 FSDP2를 사용해야 합니다. 두 구현은 sharding → all-gather → 계산 → reshard라는 기본 동작을 공유하지만 parameter 표현이 다릅니다.
Model Parallel 축: TP, SP, PP
Tensor Parallel(TP)은 한 layer의 연산조차 한 머신에서 처리하지 못할 만큼 클 때 사용하는, FSDP보다 더 복잡한 병렬화입니다. weight뿐 아니라 연산 자체를 여러 GPU로 쪼개서 row parallel 또는 column parallel 방식으로 분할 계획(plan)을 따라 처리한 뒤, 결과를 다시 합쳐 최종 output을 만듭니다.
이 외에도 layer의 연산을 sequence 차원으로 쪼개는 Sequence Parallel(SP), 모델을 layer 단위로 잘라 서로 다른 GPU에 이어 붙이고 microbatch를 흘려보내는 Pipeline Parallel(PP)이 있으며, 실제 대규모 모델 학습에서는 Data Parallel 축과 Model Parallel 축의 기법들을 조합하여 사용합니다(뒤의 “병렬화 조합” 참고).
FSDP나 TP는 모델을 재구성하지만 컴파일 과정은 없고, 입력도 출력도
nn.Module입니다. FSDP2의fully_shard는 Python의 동적 클래스 생성으로 module의 클래스를FSDPModule을 섞은 새 클래스로 바꿔치기하고, TP의parallelize_module은 클래스를 바꾸지 않고 parameter를 DTensor로 교체하고 hook을 다는 방식으로 module을 제자리에서 수정합니다.
Q. GPU 여러 대로 분산해서 학습하면 결과값이 어떻게 한 곳으로 정확히 모이나요? 이 부분이
torch.distributed의 핵심 기능입니다. rendezvous 단계에서 world 구성과 각 프로세스 정보를 모두 파악해 두고, 노드들의 접근 정보는 TCPStore(원격 접근 가능한 key-value store)에 캐싱합니다. 이를 바탕으로 collective communication API가 sharding된 weight 조각을 누구에게 받을지, 결과를 어떻게 모을지를 처리합니다. Tensor Parallel은 마지막에 reduction으로 결과를 합치고, FSDP는 forward 결과(activation)를 각 GPU가 자신의 데이터에 대해 로컬로 계산하므로 output을 모으는 단계는 없지만, backward에서는reduce_scatter로 gradient를 rank 간에 동기화합니다.Q. rendezvous 역할을 하는 머신이 따로 있나요? rendezvous host는
--rdzv_endpoint로 사용자가 지정한 노드가 맡습니다 (앞의 예제에서는192.168.0.2). 별도의 전용 머신일 필요는 없고, 연산 노드 중 하나가 겸하는 것이 일반적입니다. rendezvous는 프로세스들이 서로를 찾고 world를 구성하기 위한 과정일 뿐이므로, 특정 물리 머신에 본질적으로 묶여 있는 것은 아닙니다.
DDP 예제 코드
DDP는 모델을 DistributedDataParallel로 감싸고 DistributedSampler로 rank마다 다른 데이터를 주기만 하면 되고, training loop는 단일 GPU 코드와 같습니다.
from torch.nn.parallel import DistributedDataParallel as DDP

model = Net().to(local_rank)          # device는 local rank로 선택
model = DDP(model, device_ids=[local_rank])

sampler = DistributedSampler(dataset)   # rank마다 다른 데이터 조각
dataloader = DataLoader(dataset, sampler=sampler)
for epoch in range(epochs):
    sampler.set_epoch(epoch)            # epoch마다 shuffle 순서를 바꿈
    for batch, target in dataloader:
        loss = loss_fn(model(batch), target)
        loss.backward()                 # backward 중에 all_reduce가 자동 수행
        optimizer.step()                # 모든 rank가 동일한 update
optimizer.zero_grad()loss.backward()와 optimizer.step() 사이에 gradient 동기화 코드가 없습니다. 동기화는 DDP가 backward 안에서 처리합니다.
DDP 내부 동작
DDP의 내부 동작도 initialization, forward, backward 단계로 나눌 수 있습니다.
Initialization 단계에서는 rank 0의 parameter와 buffer를 모든 rank에 broadcast해서 완전히 동일한 상태에서 출발하도록 맞춥니다. 그리고 Reducer라는 내부 객체가 parameter들을 bucket(기본 25MB) 단위로 묶어 두고, 각 parameter에 autograd hook을 등록합니다. autograd hook은 backward 중 특정 tensor의 gradient가 완성될 때 불리는 callback입니다(사용자 API로는 Tensor.register_post_accumulate_grad_hook). Week 4에서 본 backward graph 순회가 각 parameter에 도착하는 지점에 끼어드는 장치라고 보면 됩니다.
Forward는 로컬 계산 그대로입니다. parameter 통신은 없고, BatchNorm의 running statistics 같은 buffer가 있으면 기본 설정(forward_sync_buffers=True)에서 forward 시작 시 rank 0의 buffer를 broadcast하는 것이 전부입니다.
Backward 단계에서는 autograd 엔진이 각 parameter의 gradient를 계산할 때마다 hook이 호출되고, 한 bucket에 속한 모든 gradient가 준비되면 그 bucket에 대해 비동기 all_reduce를 즉시 발행합니다. 나머지 layer들의 backward 계산이 계속되는 동안 앞서 발행된 통신이 뒤에서 진행되므로, 통신과 계산이 겹쳐집니다(overlap). bucket을 parameter 역순(backward에서 gradient가 만들어지는 순서)으로 구성하는 것도 이 overlap을 극대화하기 위해서입니다. backward가 끝나면 모든 gradient가 world_size로 평균된 상태이고, 각 rank가 같은 gradient로 같은 update를 수행하므로 parameter는 별도 동기화 없이도 계속 일치합니다.
DDP는 nn.Module을 감싸고 hook으로 통신을 끼워 넣습니다. 뒤에서 볼 FSDP도 같은 구조이고, 통신 종류와 시점만 다릅니다.
FSDP 예제 코드
FSDP2는 사용법 자체는 간단합니다. 일반적인 PyTorch 모델을 정의한 뒤, sharding하고 싶은 단위(보통 transformer block 같은 layer)마다 fully_shard를 호출하고, 마지막으로 모델 전체에 한 번 더 호출하면 됩니다.
from torch.distributed.fsdp import fully_shard, FSDPModule

model = Transformer()
for layer in model.layers:
    fully_shard(layer)  # transformer block 단위로 sharding
fully_shard(model)      # 남은 최상위 parameter까지 sharding
이렇게 layer 단위로 나누어 적용하는 이유는 메모리 효율 때문입니다. forward에서 layer i를 계산하는 동안 나머지 layer들은 sharded 상태로 남아 있고, 필요한 layer의 parameter만 그때그때 all-gather됩니다. FSDP1에서는 auto_wrap_policy로 이 wrapping 단위를 지정했지만, FSDP2에서는 이렇게 명시적으로 fully_shard를 호출하는 방식으로 바뀌었습니다.
fully_shard를 적용하고 나면 각 parameter는 일반 torch.Tensor가 아니라 dim-0 기준으로 sharding된 DTensor(Distributed Tensor)가 됩니다:
from torch.distributed.tensor import DTensor, Shard

for param in model.parameters():
    assert isinstance(param, DTensor)
    assert param.placements == (Shard(0),)
# param.to_local()로 이 rank가 가진 shard를 확인할 수 있습니다Shard(0)의 0은 tensor의 dim-0을 뜻하고, placements는 device mesh의 축마다 placement가 하나씩 들어가는 tuple입니다. FSDP만 쓰면 mesh가 1D라 원소가 하나이고, 뒤에서 볼 FSDP + TP 조합에서는 2D mesh의 축마다 하나씩 붙습니다.
또한 fully_shard(model)은 model의 클래스를 원래 클래스와 FSDPModule을 합친 새 클래스(예: FSDPTransformer)로 바꿔치기합니다. 덕분에 모델은 여전히 nn.Module처럼 동작하면서도, unshard()처럼 all-gather 시점을 수동으로 제어하는 FSDP 전용 API를 추가로 갖게 됩니다.
FSDP1 vs. FSDP2
내부 동작을 보기 전에, 두 세대가 parameter를 표현하는 방식의 차이를 먼저 짚고 넘어가겠습니다.
FSDP1은 하나의 FSDP module에 속한 모든 parameter를 FlatParameter라는 단일 1D tensor로 이어 붙인(flatten) 뒤, 그것을 rank들에 나누어 sharding했습니다. 구현은 단순하지만 여러 parameter가 하나의 tensor로 뭉개지기 때문에, parameter별 metadata(dtype, requires_grad 등)를 온전히 유지하기 어렵다는 근본적인 한계가 있었습니다.
FSDP2는 FlatParameter를 버리고 parameter 하나하나를 dim-0 기준으로 sharding하는 per-parameter sharding을 채택했습니다. 각 parameter는 원본 tensor의 shape·metadata와 sharding 방식(placement)을 함께 들고 있는 DTensor가 됩니다.
requires_grad와 dtype은 tensor마다 하나씩 있는 속성입니다. FlatParameter는 여러 parameter를 한 tensor로 합치므로, 그 안의 parameter들이 이 속성을 공유해야 했습니다. per-parameter sharding은 이 제약을 없애 다음을 가능하게 합니다:
- 부분 freeze(LoRA 등): LoRA는 base weight를 freeze하고 작은 adapter만 학습하는데, FSDP1에서는 기본값(
use_orig_params=False)에서 한 FlatParameter 안의 parameter가 모두 frozen이거나 모두 trainable이어야 했고(wrapping을 나누는 우회가 필요),use_orig_params=True면 섞을 수는 있었지만 frozen parameter에도 gradient 메모리가 잡혔습니다. FSDP2는 parameter마다 flag를 따로 유지하므로 그대로 동작하고, frozen parameter에는 gradient 메모리도 잡히지 않습니다. - dtype 혼합(fp8 등): 하나의 연속 버퍼로 이어붙이려면 모든 parameter가 같은 dtype이어야 했지만, parameter가 각자 독립된 tensor인 FSDP2에서는 큰 matmul weight만 fp8로 두고 LayerNorm처럼 민감한 부분은 bf16으로 남길 수 있습니다.
- all-gather 없는 sharded checkpointing: FSDP1의 shard는 이어붙인 1D 버퍼를 world_size로 등분한 조각이라 parameter 경계와 어긋납니다. 한 parameter의 절반이 rank 0에, 나머지가 rank 1에 걸칠 수 있으니 조각 자체로는 의미가 없어, FULL_STATE_DICT로 저장하려면 조각을 모으는 all-gather가 필요했습니다(rank 0에 메모리가 몰리는 원인). FSDP1에도 SHARDED_STATE_DICT는 있었지만 parameter 경계와 어긋난 조각을 그대로 저장합니다. FSDP2의 shard는 parameter를 dim-0으로 자른 조각에 원래 shape·placement metadata가 붙어 있어, 각 rank가 자기 조각을 그대로 저장해도 어느 parameter의 어느 부분인지 자명합니다.
torch.distributed.checkpoint가 all-gather 없이 각 rank의 조각을 병렬로 저장·로드할 수 있는 근거입니다(저장 계획을 맞추는 metadata 조율은 coordinator rank가 합니다). - 결정적(deterministic) 메모리 관리: all-gather는 별도 CUDA stream4에서 돌고 계산은 default stream에서 도는데, 통신 stream이 할당한 unsharded 버퍼를 계산이 다 쓰기 전에 allocator가 재사용하지 못하게 막아야 합니다. FSDP1이 쓰던
record_stream()은 GPU가 실제로 작업을 끝냈는지를 보고 메모리를 반환하므로, 해제 시점이 GPU 실행 타이밍에 따라 달라져 같은 코드의 peak memory가 실행마다 달라지고 간헐적 OOM의 원인이 됐습니다. FSDP2는 stream 간 event 동기화로 해제 시점을 프로그램 순서에 고정해서, 메모리 사용량이 매 실행 동일하게 예측 가능합니다.
DTensor는 뒤에서 다룰 Tensor Parallel에서도 쓰이므로, FSDP2와 TP를 같은 표현 위에서 조합할 수 있습니다.
FSDP 내부 동작
FSDP2의 내부 동작은 initialization, forward, backward 세 단계로 나눌 수 있습니다.
Initialization 단계에서는 fully_shard가 호출된 module 단위로 parameter들을 dim-0 기준으로 쪼개 DTensor로 바꾸고, 각 rank는 자신의 shard에 해당하는 memory만 유지합니다. 그리고 forward/backward 실행 시 자동으로 호출될 hook들을 등록합니다. pre hook에서는 all_gather(unsharding)를, post hook에서는 resharding(모아 온 전체 parameter를 해제)을 수행하도록 설정합니다. 큰 모델의 경우 meta device5 위에서 모델을 정의하고 fully_shard 적용 후 to_empty() + reset_parameters()로 shard만 materialize하면, 어떤 rank도 전체 모델을 memory에 올리지 않고 초기화할 수 있습니다.
Forward 단계에서는 fully_shard 단위마다 all_gather로 sharded parameter를 복원(unsharding)하고, computation을 수행한 뒤, 다시 resharding하는 과정을 반복합니다. 한 layer의 계산이 끝나면 해당 layer의 전체 parameter를 다시 버려서 메모리를 절약합니다.
이 구조를 그대로 실행하면 layer마다 “all-gather가 끝나기를 기다렸다가 계산”하는 직렬 흐름이 되어 통신 시간이 전부 노출됩니다. 이를 피하는 기법이 prefetch입니다. layer i를 계산하는 동안 다음 layer i+1의 all-gather를 미리 시작해 두는 것으로, 통신이 계산과 별도의 CUDA stream에서 돌기 때문에 둘이 동시에 진행될 수 있고, layer i의 계산이 끝날 때쯤이면 layer i+1의 parameter가 이미 도착해 있어 통신 시간이 계산 뒤로 숨습니다. FSDP2에서는 CPU thread가 GPU 실행보다 앞서 kernel들을 stream에 enqueue하는 것만으로 이것이 자동으로 일어나며(implicit prefetching), set_modules_to_forward_prefetch 같은 API로 스케줄을 명시적으로 제어할 수도 있습니다.
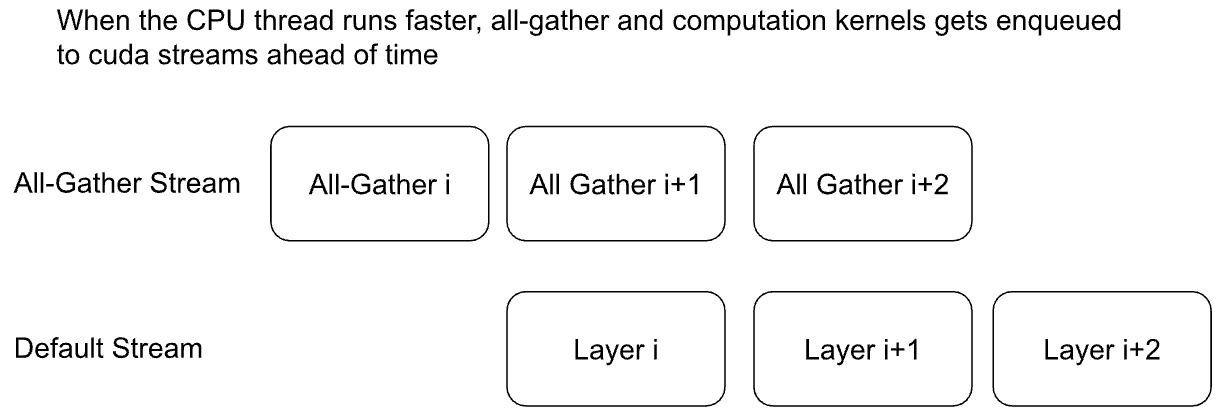
그림 출처: PyTorch FSDP2 Tutorial
Backward 단계에서는 forward와 유사하게 각 layer에서 all_gather → computation → resharding 과정을 layer 역순으로 거치지만, 추가로 gradient를 동기화하기 위한 reduce_scatter 연산이 수행됩니다. local gradient들이 reduce_scatter를 거치면 각 rank는 자신의 shard에 해당하는 gradient만 갖게 되고, optimizer도 sharded parameter와 sharded gradient 위에서 그대로 동작합니다.
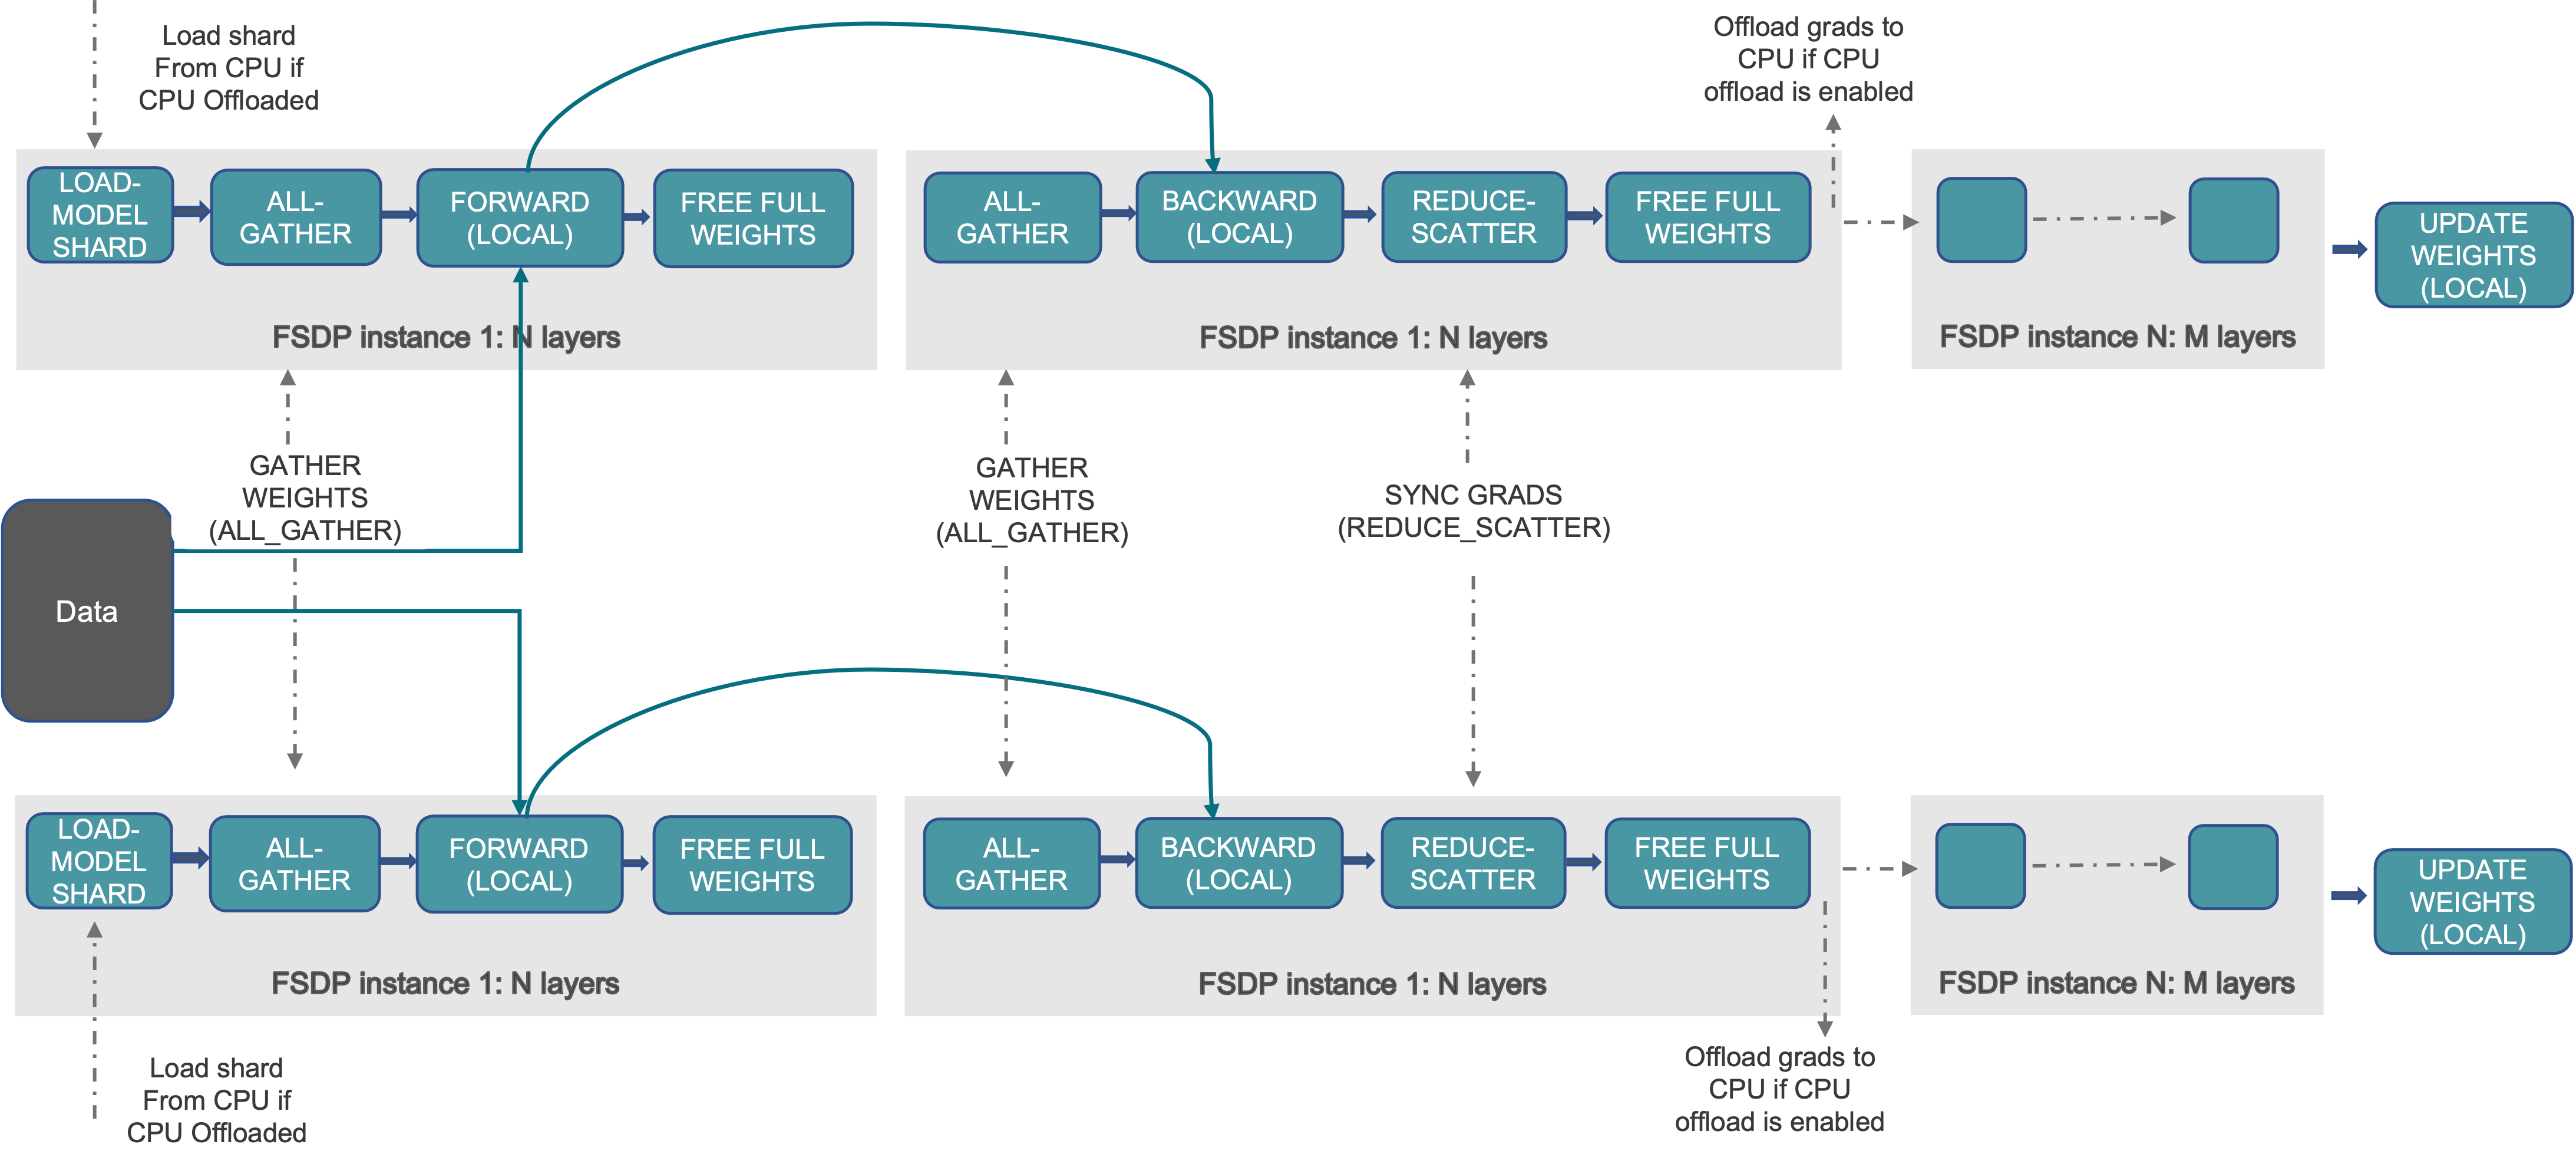
그림 출처: PyTorch FSDP2 Tutorial · 위아래 두 줄은 두 rank이고, 각 줄이 forward(all-gather → 계산 → 해제) → backward(all-gather → 계산 → reduce-scatter → 해제) → local update 순서입니다.
DDP vs. FSDP: 언제 무엇을 쓰나
FSDP는 DDP의 상위 호환이 아닙니다. 학습 상태를 sharding해 device memory 사용량을 줄이는 대신 parameter all-gather와 gradient reduce-scatter 통신을 추가하므로(reshard 자체는 모아 둔 full parameter를 해제하는 동작이라 통신이 아닙니다), 둘은 memory와 communication의 trade-off 관계입니다.
내부 동작을 봤으니 step당 통신량을 비교할 수 있습니다. parameter 전체 크기를 P byte(gradient도 같은 dtype이라 같은 크기), 통신량은 rank당 송신량 기준, rank 수 N이 충분히 커서 (N−1)/N ≈ 1이라 놓으면:
- DDP: backward 중 gradient
all_reduce한 번뿐입니다. 통신량은 약 2P(ring all-reduce6 기준)이고, bucket 단위로 계산과 대부분 겹쳐집니다. forward에는 parameter 통신이 없습니다(buffer broadcast는 제외). - FSDP(FULL_SHARD): forward에서 all-gather(P), backward에서 다시 all-gather(P) +
reduce_scatter(P)로 약 3P입니다.
이 단순 모델에서 ring all-reduce는 reduce-scatter와 all-gather로 구현할 수 있으므로 DDP와 FSDP backward의 데이터 이동량이 비슷하게 계산됩니다. 실제 통신 시간은 collective algorithm, topology, bucket 크기, overlap 정도에 따라 달라집니다.
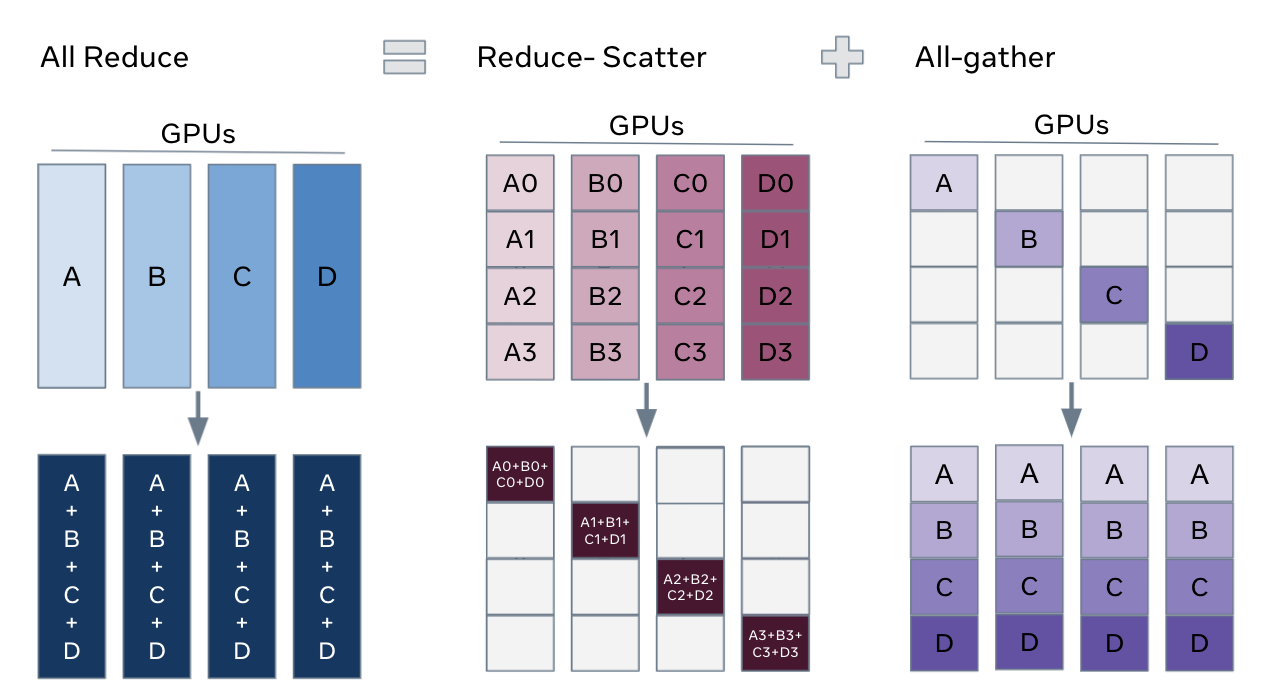
그림 출처: PyTorch FSDP2 Tutorial · 오른쪽 all-gather의 A~D는 왼쪽 입력이 아니라 가운데 reduce-scatter가 만든 합산 조각(A0+B0+C0+D0 등)을 뜻합니다.
FSDP에는 forward parameter all-gather가 추가됩니다. Prefetch가 이 통신을 계산과 충분히 겹치면 노출되는 통신 시간이 줄어듭니다. 효과는 model structure, per-device batch 및 interconnect에 따라 달라집니다.
Per-device batch가 작아지면 계산량은 줄지만 parameter와 gradient 통신량은 크게 줄지 않아 통신 비중이 증가합니다. 계산량을 통신량으로 나눈 이 비율(arithmetic intensity7)이 하드웨어의 임계값 아래로 내려가면 통신이 병목이 됩니다. 따라서 data parallel scaling은 model size, token 수, GPU 연산 성능, interconnect bandwidth와 통신·계산 overlap을 함께 측정해 결정해야 합니다.
DDP는 rank마다 16 byte/param 전체를 복제하지만, FSDP는 상시 보관하는 학습 상태를 world_size로 나눕니다. 다만 peak memory에는 지금 계산 중인 module(과 prefetch된 다음 module)의 full parameter 버퍼와 activation이 더해지므로, 각 fully_shard 단위는 복원됐을 때 한 GPU에 들어가야 합니다. 선택은 다음 질문으로 정합니다:
선택한 precision 및 optimizer 구성의 학습 상태와 activation이 GPU 한 장에 들어가는가?
- 들어간다 → DDP는 parameter all-gather가 없고 wrapping 단위를 정할 필요가 없어 구성이 단순합니다.
- 안 들어간다 → FSDP, tensor parallel, pipeline parallel 또는 offload를 이용해 학습 상태와 activation을 분산해야 합니다.
- Parameter 복제는 가능하지만 gradient와 optimizer state를 줄여야 한다 → FSDP2의
reshard_after_forward=False는 forward 후 unsharded parameter를 유지하고 gradient와 optimizer state를 sharding하는 구성을 제공합니다.
FSDP의 주된 장점은 학습 상태의 memory sharding입니다. 메모리 제약이 없거나 per-device batch가 작아 통신이 병목이면 parameter all-gather가 없는 DDP가 더 단순하고 빠를 수 있습니다.
Tensor Parallel 예제 코드
Tensor Parallel은 FSDP와 달리 계산 자체를 쪼개기 때문에 자동화가 어려워, 개발자가 모델의 어떤 layer를 어떻게 자를지 분할 계획(plan)을 직접 설계해야 합니다. 어떤 parameter를 column 방향으로, 어떤 것을 row 방향으로 쪼갤지를 명시적으로 지정한 뒤 plan을 함께 넘기면, PyTorch 패키지가 그 plan대로 모델까지 같이 잘라줍니다.
from torch.distributed.device_mesh \
    import init_device_mesh
from torch.distributed.tensor.parallel \
    import ColwiseParallel, \
           RowwiseParallel, \
           parallelize_module

tp_mesh = init_device_mesh("cuda", (8,))  # 8-GPU 1차원 mesh

layer_tp_plan = {
    "feed_forward.w1": ColwiseParallel(),  # output 차원(dim-0)으로 분할
    "feed_forward.w2": RowwiseParallel(),  # input 차원(dim-1)으로 분할
    "feed_forward.w3": ColwiseParallel(),
}

for transformer_block in model.layers:
    parallelize_module(  # plan대로 weight를 DTensor로 변환
        module=transformer_block,
        device_mesh=tp_mesh,
        parallelize_plan=layer_tp_plan,
    )
위 코드에서 볼 수 있듯이, feed_forward의 w1은 column 방향으로, w2는 row 방향으로 분할하는 식의 계획을 세웁니다. attention도 같은 패턴으로, wq/wk/wv는 ColwiseParallel, 출력 projection인 wo는 RowwiseParallel로 자르는 것이 공식 TP tutorial의 Llama 예제 구성입니다. 이 분할 방식은 Megatron-LM에서 제안된 것이고, parallelize_module은 이를 plan 하나로 적용하게 해 줍니다.
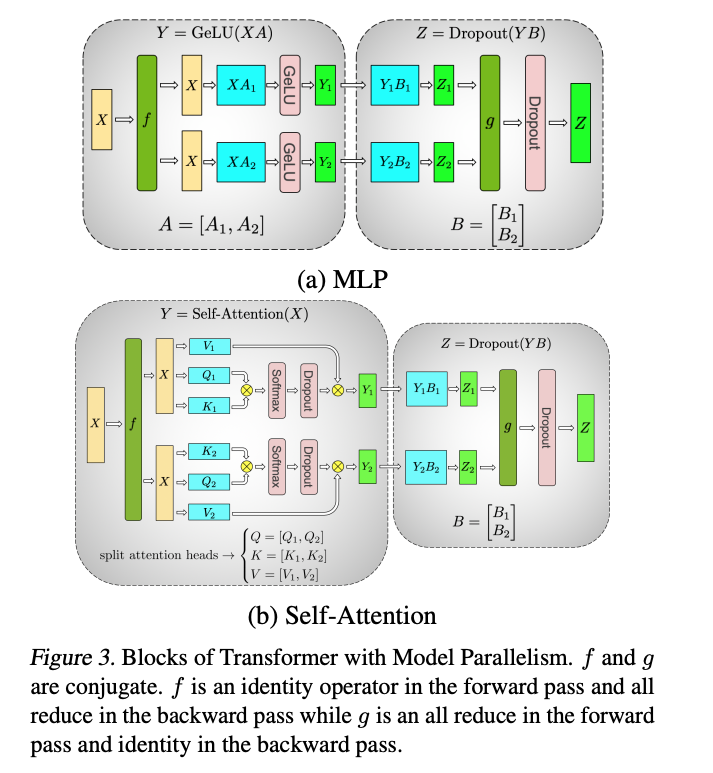
그림 (a)의 가 코드의 ColwiseParallel(w1), 가 RowwiseParallel(w2)입니다. 와 는 collective가 들어가는 자리로, 는 forward에서 identity, backward에서 all-reduce이고 는 그 반대입니다. 아래에서 말하는 “row parallel 끝의 all_reduce 한 번”이 입니다. 그림은 표기라 는 nn.Linear.weight([out, in])의 전치이고, 그래서 의 열을 자르는 것이 weight의 dim-0(출력 차원)을 자르는 Shard(0)에 해당합니다.
그림 출처: Megatron-LM 논문 (Training Multi-Billion Parameter Language Models Using Model Parallelism) · PyTorch TP Tutorial
Tensor Parallel 내부 동작
parallelize_module도 weight를 DTensor로 바꿉니다. plan에 따라 ColwiseParallel은 output 차원(Linear weight의 dim-0)으로, RowwiseParallel은 input 차원(dim-1)으로 sharding합니다. FSDP2가 기본적으로 모든 parameter를 dim-0으로 일괄 sharding하는 것과 달리(shard_placement_fn으로 parameter별로 바꿀 수는 있습니다), TP는 연산의 수학적 구조에 맞춰 쪼개는 방향을 고릅니다.
통신 삽입은 DTensor의 sharding propagation이 담당합니다. 각 op 실행 시 입력·출력의 placement를 보고 필요한 collective를 결정하는데, 위 예제처럼 Colwise(w1, w3) → Rowwise(w2)로 이어 붙이면 중간 activation은 sharded 상태 그대로 통신 없이 다음 layer로 넘어가고, row parallel 연산 끝에서 all_reduce 한 번으로 결과를 합칩니다. Megatron-LM이 손으로 설계한 통신 최소화 배치를 DTensor가 자동으로 만들어 냅니다.
병렬화 조합: DeviceMesh와 3D Parallelism
실제 대규모 학습에서는 이 기법들을 하나만 쓰지 않고 조합합니다. 예를 들어 노드 안의 GPU들(NVLink로 빠르게 연결)에는 통신이 잦은 TP를, 노드 사이에는 FSDP를 적용하는 식입니다. 이 조합을 표현하는 추상화가 DeviceMesh입니다. 앞의 TP 예제에서 1차원 mesh를 만들었다면, 조합할 때는 다차원 mesh를 만들고 축마다 다른 병렬화를 할당합니다:
from torch.distributed.device_mesh import init_device_mesh

# 32 GPUs = dp 8 x tp 4
mesh_2d = init_device_mesh("cuda", (8, 4),
                           mesh_dim_names=("dp", "tp"))

# 1) tp 축: 노드 안 4개 GPU에 연산을 쪼개고
for block in model.layers:
    parallelize_module(block, mesh_2d["tp"], layer_tp_plan)

# 2) dp 축: TP로 쪼개진 모델을 다시 FSDP로 sharding
for block in model.layers:
    fully_shard(block, mesh=mesh_2d["dp"])
fully_shard(model, mesh=mesh_2d["dp"])
FSDP2와 TP가 같은 DTensor 위에 있으므로 이 조합이 그대로 동작합니다. 한 parameter가 tp 축으로는 연산 방향으로, dp 축으로는 dim-0으로 sharding된 2D DTensor가 되고, 각 축의 collective는 해당 축의 process group 안에서만 일어납니다.
여기에 Pipeline Parallel까지 얹으면 소위 3D parallelism이 되고, long context 학습이라면 Context Parallel 축이, MoE 모델이라면 Expert Parallel 축이 더해집니다(뒤의 보충 참고). PyTorch native로 이런 조합(FSDP + TP + PP + CP)을 구현해 둔 대표 사례가 torchtitan입니다. FSDP1의 FlatParameter로도 DTensorExtensions를 통해 TP와 조합할 수는 있었지만 별도 확장 경로가 필요했고, FSDP2는 parameter가 처음부터 DTensor라 같은 표현 위에서 바로 조합됩니다.
“TP는 노드 안, FSDP는 그 위”라는 배치가 표준이 된 것도 통신 구조로 설명됩니다:
- TP의 계산/통신 비율은 batch와 무관합니다. TP의 통신은 activation 크기(batch × hidden 차원)에 비례하는데, 계산은 거기에 feed-forward 폭 F까지 곱해진 크기입니다. batch를 키워도 두 항이 같이 커져서 비율이 그대로이고, 그 비율은 F를 TP degree로 나눈 값으로 정해집니다. degree를 올릴수록 나빠집니다. 아래 참고 자료(JAX scaling book)는 TPU v5p 조건에서 8~16-way를 한계로 분석하는데, GPU에서도 같은 이유로 NVLink급 노드 안 interconnect에서만 감당됩니다. 게다가 TP의 all-gather는 계산 경로 위에 있어(critical path) DP 계열처럼 뒤로 숨기기도 어렵습니다.
- FSDP/DP의 통신은 parameter 크기로 고정입니다. 앞 절에서 본 것처럼 per-device batch가 arithmetic intensity 임계 이상인 한 얼마든지 넓게 펼 수 있습니다. 그리고 TP를 섞으면 compute-bound를 유지하는 데 필요한 per-device batch 하한이 크게 내려가서(아래 참고 자료의 분석 기준 최대 8배 정도), 같은 global batch로 더 많은 GPU까지 확장할 수 있습니다.
그래서 통신이 잦고 degree가 제한된 TP를 가장 빠른 링크(노드 안)에 가두고, 그 바깥을 FSDP로 펴고, 대역폭이 좁은 클러스터 사이는 통신이 가장 적은 순수 DP로 잇는 계층 구조가 됩니다.
분산 프로그래밍 정리 Q&A
지금까지 살펴본 분산 패키지들과 관련해 강의 중 나온 질문들을 정리합니다.
Q. DP / TP / PP를 함께 쓸 때 적용 순서가 중요한가요? 순서라기보다는 레이어 개념으로 보면 됩니다. DP는 모델을 자르지 않으므로 가장 위쪽 레이어에서 적용한다고 생각하면 자연스럽고, TP·PP가 먼저 모델을 잘라 분산된 모델 인스턴스를 만들면 그 위에서 DP가 그것을 데이터 병렬로 복제하는 그림입니다. TP와 PP는 자르는 dimension 자체가 다르기 때문에 어느 쪽을 먼저 적용해도 크게 다르지 않을 가능성이 높지만, 보통 두 가지를 모두 쓸 만큼 모델이 크지 않다면 둘 중 하나만으로도 충분합니다.
Q. 노드 = GPU 인가요? Rank가 GPU에 부여되는 subjob인가요? 노드는 GPU가 아니라 서버(호스트 머신)입니다. 한 노드에 GPU가 여러 개 꽂혀 있을 수 있고, 보통 NVIDIA GPU 환경에서는 GPU 1개 = process 1개 = rank 1개로 매핑합니다. 따라서 GPU가 4개인 노드라면 rank 4개·프로세스 4개가 생기고, 각 rank는 특정 GPU에 할당된 하나의 분산 작업이라고 보면 됩니다.
Q. 데이터 dimension이 큰 모델에선 디바이스 간 데이터 전송 overhead가 더 중요한 이슈 아닌가요? 맞습니다. TP나 PP처럼 op 자체를 병렬화하면 분산 이득과 함께 통신 overhead도 같이 늘어나서, 오히려 느려지는 경우도 생깁니다. 그래서 FSDP vs TP 같은 trade-off를 봐야 합니다. 한 디바이스에서 계산이 도저히 안 들어갈 정도로 layer 자체가 크다면 TP를 쓸 가치가 있고, 그렇지 않다면 계산을 한 머신에서 온전히 끝내는 FSDP가 통신 비용 면에서 더 유리한 경우가 많습니다.
Q. FSDP는 어차피 연산 직전에 unsharding을 하는데 왜 sharding을 하나요? GPU 메모리 한계 때문입니다. 예를 들어 GPU HBM이 10GB인데 모델 weight가 40GB라면 한 GPU에 다 못 올립니다(대신 한 번에 복원하는
fully_shard단위는 들어가야 합니다). 호스트가 weight 전체를 들고 있다가 필요한 조각을 GPU로 넘겨주는 방식도 가능하지만, GPU↔GPU 통신이 host↔GPU보다 빠른 환경에서는 GPU들에 weight를 분산시켜 놓고 필요할 때 GPU 간에 직접 모으는 편이 훨씬 빠릅니다. FSDP의 unsharding은 이 더 빠른 경로를 활용해 weight를 op 직전에 모으는 방식입니다.
Q. Gloo, NCCL, MPI는 노드 안 통신만 다루나요, 노드 간 통신도 다루나요? 둘 다 다룹니다. Collective communication API를 호출하는 입장에서는 통신해야 한다는 사실만 알 뿐 상대 프로세스가 같은 노드인지 다른 노드인지는 모릅니다. 그 판별은 backend가 내부에서 처리하며, 같은 노드 안이면 NVLink/SHM 같은 빠른 경로를, 다른 노드면 네트워크 프로토콜을 사용해 통신을 수행합니다.
Q.
torch.compile과torch.distributed는 어떤 순서로 적용되나요? 통합되지 않아 놓치는 최적화가 있나요? 적용 순서는 wrapper와 PyTorch 버전에 따라 다릅니다. DDP에서는 DDP wrapper에torch.compile을 적용해 DDPOptimizer가 bucket 경계를 고려하도록 하는 경로가 있고, compiler troubleshooting 문서에서는 wrapper module 처리 문제가 있을 때 내부 module만 compile하는 방법도 안내합니다. FSDP도 지원 범위와 graph break 여부가 달라질 수 있으므로 사용하는 PyTorch 버전의 distributed compiler 문서를 확인해야 합니다. FX graph에 포함된 collective는 backend가 처리할 수 있지만, 지원되지 않는 wrapper 또는 operation은 graph break를 만들 수 있습니다.
Q. 대용량 분산 처리는 보통 Hadoop/MapReduce를 쓰는데, PyTorch는 왜 MPI 형태를 골랐나요? Hadoop MapReduce는 storage에 기록된 key-value data를 map, shuffle, reduce 단계로 처리하는 data-processing model이며 fault recovery와 task scheduling을 runtime이 관리합니다. MPI는 process 사이의 message passing과 collective communication을 제공하는 API입니다. 분산 학습은 반복되는 tensor collective와 세밀한 동기화가 필요하므로 MPI와 유사한 process/rank/collective model을 사용합니다.
보충: 새로운 축, Expert Parallel과 Context Parallel
Expert Parallel과 Context Parallel은 학습과 inference 모두에서 사용할 수 있으며, 모델 구조와 sequence 길이에 따라 필요성이 결정됩니다.
Expert Parallel(EP)은 MoE(Mixture of Experts) 모델 전용 축입니다. MoE는 FFN 자리에 expert를 수십~수백 개 두고, token마다 router가 고른 일부(top-k)만 계산합니다. parameter 수는 dense 모델의 몇 배인데 실제 계산은 일부만 쓰므로, “계산은 감당되는데 weight가 안 들어가는” 메모리 병목이 극단적으로 커집니다. EP는 expert들을 GPU에 나눠 배치하고, 각 token을 담당 expert가 있는 GPU로 보냈다가(all-to-all dispatch) 계산이 끝나면 되돌려 받습니다(all-to-all combine). 앞의 병렬화들과 달리 EP의 주 통신은 all-to-all입니다. 또 어떤 token이 어느 GPU로 갈지는 router 출력에 따라 매 step 달라지므로 통신 패턴이 동적입니다. GShard/Switch Transformer의 학습에서 나온 기법이고, DeepSeek-V3처럼 MoE가 주류가 되면서 학습·inference 양쪽의 표준 축이 됐습니다. dense 모델에는 필요 없습니다.
Context Parallel(CP)은 긴 sequence의 activation과 attention 계산을 여러 GPU에 분할합니다. 구현에 따라 K/V block을 ring P2P로 순환시키거나 all-gather 또는 all-to-all 기반 교환을 사용할 수 있습니다. PyTorch의 experimental context parallel API도 여러 attention communication strategy를 제공합니다.
이름이 비슷한 Sequence Parallel과의 구분도 해 두겠습니다. Megatron 계열에서 말하는 SP는 TP의 보조 기법으로, TP가 쪼개지 못하는 구간(LayerNorm, Dropout)의 activation을 sequence 방향으로 나눠 메모리를 아끼는 것입니다. attention 계산 자체를 sequence로 쪼개는 독립된 축인 CP와는 다른 기법입니다.
EP는 모델이 MoE일 때, CP는 context 길이가 activation 메모리를 지배할 때 씁니다. CP는 backward용 activation을 보관해야 하는 학습에서 더 필요하고, inference에서도 MoE serving(EP)과 long prompt prefill(CP)에 같은 기법을 씁니다.
보충: DeepSpeed, Accelerate, 그리고 Ray
이 절에서는 PyTorch 외부에서 자주 함께 사용하는 DeepSpeed, Hugging Face Accelerate, Ray의 역할을 구분합니다. DeepSpeed는 ZeRO 계열의 병렬화 runtime을 제공하고, Accelerate는 DDP·FSDP·DeepSpeed의 설정과 실행을 통합하는 frontend이며, Ray Train은 worker와 cluster resource를 관리하는 orchestrator입니다.
DeepSpeed 예제 코드
DeepSpeed는 wrapping이 아니라 deepspeed.initialize()로 model과 optimizer를 engine으로 바꿔치기하고, training loop의 backward/step 호출까지 engine이 가져갑니다.
import deepspeed

model_engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    model_parameters=model.parameters(),  # optimizer는 config의 선언대로 engine이 생성
    config="ds_config.json",
)

for batch, target in dataloader:          # dataloader는 DDP 예제와 같이 직접 준비
    loss = loss_fn(model_engine(batch), target)
    model_engine.backward(loss)   # loss.backward()가 아니라 engine 호출
    model_engine.step()           # optimizer.step()도 engine이 대신
동작 방식은 코드가 아니라 JSON config에 선언합니다:
{
  "train_micro_batch_size_per_gpu": 4,
  "gradient_accumulation_steps": 4,
  "optimizer": { "type": "AdamW", "params": { "lr": 1e-4 } },
  "zero_optimization": {
    "stage": 3,
    "offload_optimizer": { "device": "cpu" }
  },
  "bf16": { "enabled": true }
}
DDP/FSDP가 “모델만 감싸고 loop는 그대로”인 것과 달리 loop 자체가 바뀌는 이유는, gradient accumulation·clipping·loss scaling·partitioning 시점을 전부 engine이 제어하는 설계이기 때문입니다. 사용자는 config에 선언만 하고, 실행 순서는 engine이 결정합니다.
DeepSpeed 내부 동작
deepspeed.initialize()는 nn.Module을 DeepSpeedEngine으로 감싸고, optimizer를 ZeRO optimizer로 교체합니다. config의 stage에 따라:
- Stage 1: optimizer state를 rank별로 partition합니다. backward는 DDP처럼 all-reduce하되, 각 rank는 자기 partition에 해당하는 state만 유지·갱신합니다.
- Stage 2: gradient에 hook을 걸어, backward 중 각 rank가 자신이 담당하는 partition의 gradient만 모아 갖도록 reduce합니다.
- Stage 3: forward/backward 전후로 parameter를 gather/partition하는 hook을 등록합니다. FSDP의 all-gather → 계산 → reshard와 같은 그림입니다.
engine.backward(loss)는 loss scaling을 적용해 backward를 수행합니다. gradient 통신 시점은 stage마다 달라서, ZeRO-2/3는 매 backward마다 자기 partition으로 reduce하고 ZeRO-1은 gradient accumulation 경계에서 all-reduce합니다. engine.step()은 accumulation step 수와 clipping을 확인한 뒤 optimizer step을 수행하고 partition 상태를 유지합니다. PyTorch integration에서는 NCCL 등의 collective backend를 사용하지만, DeepSpeed는 자체 runtime과 communication abstraction도 포함하므로 FSDP와 동일한 c10d 구현이라고 단정할 수는 없습니다.
FSDP vs. DeepSpeed
실무 관점의 차이는 다음과 같습니다:
- Precision 처리: DeepSpeed는 parameter를 준비하는 시점에 항상 fp32 master weight로 upcast하고 optimizer도 fp32로 돕니다. FSDP는 모델의
torch_dtype을 존중해서, mixed precision을 끄면 optimizer까지 low precision으로 돌리는 것도 가능합니다. GPU 수가 적을 때는 이 upcast 오버헤드가 체감될 수 있습니다. - Offload: FSDP는 parameter/gradient/optimizer state를 전부 CPU로 내리거나 전부 GPU에 두는 all-or-nothing인 반면, DeepSpeed는 parameter와 optimizer state를 따로따로 내릴 수 있고 NVMe offload까지 지원합니다.
- 설정 노출 방식: FSDP는 wrapping 단위(FSDP2에서는
fully_shard호출 위치) 등을 Python API에서 명시하고, DeepSpeed는 partitioning과 offload 설정의 상당 부분을 JSON config로 받습니다.
Accelerate 예제 코드
Accelerate는 새로운 collective 또는 sharding 구현이 아니라 DDP, FSDP, DeepSpeed의 초기화와 실행 interface를 통합하는 frontend입니다. 같은 training loop에서 config로 backend를 선택할 수 있습니다:
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, dataloader = accelerator.prepare(
    model, optimizer, dataloader
)

for batch, target in dataloader:
    loss = loss_fn(model(batch), target)
    accelerator.backward(loss)    # backend에 맞는 backward로 위임
    optimizer.step()
    optimizer.zero_grad()
이 스크립트를 어떤 병렬화로 실행할지는 코드가 아니라 실행 시점의 config가 정합니다:
accelerate launch --config_file ddp.yaml   train.py   # DDP로
accelerate launch --config_file fsdp2.yaml train.py   # FSDP2로
accelerate launch --config_file ds_z3.yaml train.py   # DeepSpeed ZeRO-3로
앞에서 본 세 프레임워크의 코드 차이(DDP/FSDP는 loop 그대로, DeepSpeed는 engine이 backward/step을 가져감)를 accelerator.backward()라는 공통 인터페이스 뒤로 숨긴 것입니다.
Accelerate 내부 동작
Accelerate의 실행 과정은 다음과 같습니다:
accelerate launch --config_file ...이 config를 읽고 process들을 띄웁니다. 앞에서 본 torchrun과 같은 역할로, world/rank/rendezvous 개념이 그대로 적용됩니다.- 스크립트 안에서
Accelerator()를 생성하면AcceleratorState가 환경 변수를 분석해 지금이 어떤 분산 세팅(단일 GPU, DDP, FSDP, DeepSpeed, …)인지 파악합니다. accelerator.prepare(model, optimizer, scheduler, dataloader)가 실제 변환을 수행합니다. config에 따라 model을 DDP 컨테이너로 감싸거나, FSDP를 적용하거나, DeepSpeed engine으로 초기화합니다. optimizer와 scheduler는AcceleratedOptimizer같은 얇은 wrapper로 감싸는 정도지만, dataloader는 rank마다 서로 다른 batch를 받도록 batch sampler를 교체해 재생성하고, shuffle 등이 rank 간에 일관되도록 random number generator도 동기화합니다.accelerator.backward(loss)는 backend에 따라 분기합니다. DeepSpeed면engine.backward(loss)를 부르고 sync 경계에서는engine.step()까지 수행합니다(그래서 반환된 optimizer의step()/zero_grad()는 no-op입니다). fp16처럼 GradScaler를 쓰는 경우에는 scaling한loss.backward()를, 그 외(bf16 포함)에는 그냥loss.backward()를 호출합니다. DDP/FSDP의 통신은 어차피 backward hook에서 자동으로 일어나므로 여기서 특별히 할 일이 없습니다.
사용자는 공통 training loop를 사용하지만 collective와 sharding은 선택된 PyTorch 또는 DeepSpeed backend가 수행합니다. transformers.Trainer도 Accelerate를 사용하므로 config를 통해 FSDP 또는 DeepSpeed execution path를 선택할 수 있습니다.
Ray 예제 코드
Ray Train은 cluster에서 worker process와 resource를 관리하는 orchestrator입니다. 학습 함수를 TorchTrainer에 전달하면 Ray가 process를 배치하고 PyTorch distributed environment를 초기화합니다.
import ray.train.torch
from ray.train import ScalingConfig
from ray.train.torch import TorchTrainer

def train_func_per_worker(config):
    train_shard = ray.train.get_dataset_shard("train")
    model = ray.train.torch.prepare_model(build_model())  # 내부에서 DDP로 wrap
    optimizer = torch.optim.Adam(model.parameters())

    for batch in train_shard.iter_torch_batches(batch_size=16):
        loss = loss_fn(model(batch["x"]), batch["y"])
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()
        ray.train.report(metrics={"loss": loss.item()})

trainer = TorchTrainer(
    train_func_per_worker,
    scaling_config=ScalingConfig(num_workers=4, use_gpu=True),  # 확장은 이 숫자만 변경
    datasets={"train": train_dataset},
)
result = trainer.fit()
torchrun을 실행하는 단계가 없습니다. GPU 4개에서 여러 노드로 늘릴 때도 num_workers만 바꿉니다.
Ray 내부 동작
trainer.fit()이 호출되면 Ray가 클러스터에서 GPU를 가진 worker actor들을 스케줄하고, 각 worker에 rank/local_rank와 MASTER_ADDR 같은 환경을 설정한 뒤 torch.distributed를 NCCL backend로 초기화합니다. torchrun과 rendezvous가 하던 process 관리를 Ray의 actor 스케줄러가 맡고, 그 아래 collective communication은 이 강의에서 본 것과 같습니다. prepare_model()은 모델을 DDP로 감싸 device에 올리며(parallel_strategy="fsdp"로 FSDP도 선택 가능), 병렬화 자체는 여전히 PyTorch 스택입니다.
Ray가 그 위에 더해 주는 것은 클러스터 레벨 기능입니다:
- 데이터 파이프라인: Ray Data가 dataset을 worker별로 sharding해 나눠 주고, 전처리를 CPU 노드에서 스트리밍으로 돌립니다. GPU 노드는 학습만, CPU 노드는 전처리만 맡는 이기종(heterogeneous) 클러스터 구성이 가능합니다.
- Fault tolerance:
FailureConfig(max_failures=N)로 재시도를 켜면 노드가 죽었을 때 대체 노드를 확보해 worker를 다시 띄웁니다. 최신 checkpoint에서 이어서 학습하려면 training 함수가ray.train.report(checkpoint=...)로 저장하고 시작 시ray.train.get_checkpoint()로 복원하는 로직을 갖춰야 합니다(위 예제는 metric만 report하므로 처음부터 다시 시작합니다). - 다중 job 조율: 여러 모델과 역할을 한 클러스터에서 함께 돌립니다. 최근 RLHF/post-training 프레임워크들이 학습 모델, reward 모델, rollout용 inference 엔진을 동시에 조율하기 위해 Ray를 채택하는 이유가 이것입니다.
세 도구는 서로 다른 층에 있어 함께 쓸 수 있습니다. DeepSpeed는 병렬화 runtime, Accelerate는 training frontend, Ray Train은 cluster orchestration을 담당합니다. 따라서 Ray worker 안에서 Accelerate 또는 DeepSpeed를 사용하는 구성도 가능합니다.
Big Model Inference: 학습 밖의 sharding
Accelerate의 device_map="auto"는 학습용 sharding과 별개인 Big Model Inference 기능입니다. init_empty_weights()는 meta device에 model structure를 만들고, load_checkpoint_and_dispatch()는 checkpoint를 읽으면서 layer를 GPU, CPU RAM, disk에 배치합니다. Forward hook은 실행할 layer의 weight를 필요할 때 device로 이동합니다.
겉보기에는 FSDP와 비슷하지만 목적이 다릅니다. 이것은 inference 전용이고, 여러 GPU에 걸쳐 있어도 계산은 naive하게 순차 실행됩니다(한 GPU가 계산하는 동안 나머지는 idle). “리소스가 부족한 환경에서 어쨌든 돌게 만드는” 편의 기능이지, 병렬로 빨라지는 기능이 아닙니다.
그래서 요즘은 무엇을 쓰나
- Fine-tuning / post-training: Hugging Face 생태계(Trainer, TRL)에서 Accelerate를 frontend로 쓰고, backend로 FSDP 또는 DeepSpeed를 선택하는 구성이 일반적입니다. Accelerate도
fsdp_version=2로 FSDP2 사용을 권장하는 방향으로 가고 있습니다. - 대규모 pretraining: PyTorch native 스택인 torchtitan이 FSDP2 + TP + PP를 DTensor 위에서 조합하는(3D parallelism) 대표 사례이고, Megatron-LM / NeMo 계열도 여전히 널리 쓰입니다.
- Inference / serving: 학습용 sharding이 아니라 vLLM, SGLang 같은 전용 엔진(TP 중심)을 씁니다. vLLM은 다음 강의에서 다룹니다.
PyTorch DDP·FSDP·TP는 c10d collective와 DTensor 등의 PyTorch distributed primitive를 사용합니다. DeepSpeed는 ZeRO 계열 sharding을 자체 runtime으로 제공하고, Accelerate는 이들 backend를 공통 API로 설정합니다. Ray Train은 선택한 backend의 worker를 cluster에 배치합니다.
참고: FSDP vs DeepSpeed · Accelerate’s internal mechanisms · Big Model Inference · Distributed Training with Ray
Next Week Preview: Beyond PyTorch
지금까지 5주에 걸쳐 PyTorch 안에 기본으로 들어 있는 주요 기능들을 살펴봤습니다. 다음 주에는 PyTorch만으로 해결되지 않는 영역을 한 시간 정도 다룹니다.
Custom kernel: 두 가지 경우에 필요합니다.
- 기존 op으로 cover되지 않는 새로운 op이 필요한 경우
- op 인터페이스는 그대로 두되 PyTorch가 제공하는 op의 성능이 부족해 자체 구현으로 갈아끼우고 싶은 경우
NVIDIA GPU 환경을 가정한다면 CUDA, cuBLAS, CUTLASS 같은 NVIDIA 제공 도구로 작성할 수 있고, Triton처럼 custom kernel 작성에 특화된 언어를 활용하는 방법도 다룹니다.
vLLM: PyTorch보다 한 단계 위에서 동작하며 널리 사용되는 오픈소스 LLM inference / serving framework입니다. vLLM의 전체 구조와 최적화 기능, 그리고 PyTorch 기본 op의 조합만으로 구현하기 어려운 serving kernel을 custom op으로 연결하는 방식을 살펴볼 예정입니다.
Q&A
Q. NVCC 같은 컴파일러는 distributed를 고려해서 설계됐나요? 아닙니다. NVCC는 CUDA 소스의 host/device 코드를 컴파일·링크하는 compiler driver이고, 그 결과물인 kernel은 단일 GPU에서 실행됩니다. PyTorch 입장에서 kernel은 op 구현의 일부일 뿐입니다(op 하나가 kernel 여러 개를 띄우기도 합니다). 분산 처리는 NVCC가 아니라 c10d 레이어가 담당합니다. collective communication op들이 데이터 분배·수집을 책임지고, 그 op이 GPU에서 실행될 때 또 다른 커널로 내려가는 구조라고 보면 됩니다. 즉 컴파일과 분산은 분리된 레이어입니다.
Q. AMD나 리벨리온 같은 NPU/GPU 컴파일러도 distributed를 고려하지 않을까요? 리벨리온 컴파일러는 sharding 기능을 갖고 있습니다(공식 문서 기준 Rebellions Scalable Design으로 한 시스템 안의 여러 NPU 칩에 모델을 나눕니다). 다만 이 sharding을 다른 노드로 넘어가는 계산까지 활용할지에 대해서는 아직 그렇게 가지는 않을 가능성이 높고, 공식 문서에도 노드 간 분할은 언급이 없습니다. AMD가 어떻게 처리하고 있는지는 확인이 필요합니다.
Q. Hadoop/MapReduce와 MPI는 어떻게 다른가요? Hadoop MapReduce는 storage의 key-value data를 map, shuffle, reduce 단계로 처리하고 runtime이 task scheduling과 fault recovery를 관리합니다. MPI는 실행 중인 process가 message와 collective operation으로 직접 통신하는 API입니다. MapReduce의 reduce는 key별 결과를 특정 reducer에 모으는 단계이므로 모든 rank가 같은 결과를 받는 MPI
allreduce와 semantics가 다릅니다.
Q. Transformer가 사실상 표준이 됐는데 custom kernel 수요는 계속 있나요? 네. 특히 Attention은 context length가 길어질수록 가장 비싸지는 부분이고, 이를 가속하는 기법만도 계속 새로 나오고 있습니다. DRAM access를 줄이는 최적화도 있고, NVIDIA가 새 GPU에 공격적으로 추가하는 hardware feature를 활용하려면 같은 기능의 커널도 GPU 세대마다 다시 작성해야 합니다. Flash Attention v1 → v2 → v3가 GPU 발전에 맞춰 진화한 것이 대표 사례입니다.
Footnotes
-
NVIDIA Collective Communications Library. NVIDIA GPU 간 collective communication에 최적화된 통신 라이브러리로, NVLink·InfiniBand 같은 interconnect를 자동으로 감지해 활용합니다. 아래 “Communication Backends”에서 다른 backend들과 비교합니다. ↩
-
이름의 유래는 PyTorch 포럼 답변 참고: https://discuss.pytorch.org/t/why-the-collective-communication-library-is-named-as-c10d/189422 (“c10 namespace에 두었고, d는 distributed”) ↩
-
forward/backward 계산은 fp16/bf16 저정밀로 수행하고, 수치 안정성을 위해 optimizer에는 fp32 master weight를 유지하는 학습 기법. Optimizer state에 fp32 master weight(4 byte)가 포함되는 이유입니다. ↩
-
GPU에 kernel을 제출하는 명령 큐. 같은 stream 안의 kernel들은 제출 순서대로 실행되고, 서로 다른 stream의 kernel들은 동시에 실행될 수 있습니다. 통신과 계산을 겹치는 overlap 기법들이 모두 이 장치 위에서 동작합니다. ↩
-
실제 메모리 할당 없이 shape·dtype 같은 metadata만 가진 tensor를 만드는 PyTorch의 가상 device. 모델 구조만 먼저 정의해 두고, 실제 메모리는 나중에 필요한 shard만큼만 materialize할 수 있게 해 줍니다. ↩
-
rank들을 ring으로 연결하고 데이터를 1/N 조각씩 이웃으로 돌리는 all-reduce 구현. reduce-scatter 단계와 all-gather 단계가 각각 약 P씩 통신해 총 2P가 되며, 본문 그림의 분해가 바로 이 구조입니다. ↩
-
연산량(FLOPs)을 데이터 이동량(bytes)으로 나눈 값. 하드웨어의 “연산 성능 ÷ 대역폭” 임계값과 비교해 compute bound인지 memory bound인지를 판별하는 기준으로, Week 6의 Roofline 분석에서 본격적으로 다룹니다. ↩