Week 4: Automatic Differentiation in PyTorch
PyTorch + NPU 온라인 모임 #4 | 2025-01-08
오늘 다룰 주제들
이 강의에서는 automatic differentiation의 수학적 배경, eager mode의 Autograd, torch.compile 경로의 AOTAutograd를 설명합니다.
미분 엔진이 Autograd와 AOTAutograd 둘로 나뉜 것은 앞의 두 강의에서 본 실행 모델이 다르기 때문입니다. Week 2에서 본 eager mode에서는 torch.matmul 같은 연산이 호출되는 순간 dispatcher를 거쳐 바로 실행됩니다. 연산이 실행될 때마다 그 연산을 기록해 두면 backward에 필요한 computation graph가 만들어집니다. 이 방식이 PyTorch 1.0의 Autograd1입니다.
반면 torch.compile 경로에서는 Dynamo2가 모델의 tensor 연산을 FX Graph3로 캡처하고 backend compiler가 이를 최적화합니다. Compiler가 forward와 backward를 함께 최적화하려면 eager execution 중에 만들어지는 동적 autograd graph와 별도로, forward graph에서 backward graph를 ahead-of-time으로 생성해야 합니다. 이 작업을 AOTAutograd가 담당합니다.
전반부는 자동 미분의 수학적 배경과 eager mode의 Autograd를, 후반부는 graph mode에서 같은 문제를 푸는 AOTAutograd를 다룹니다.
- Background - gradient가 왜, 어디서 필요한가
- Supervised learning의 학습 루프: forward propagation → loss 계산 → backward propagation → optimizer
- backward 과정의 일반화: chain rule에 기반한 reverse-mode automatic differentiation을 간단한 예제로 확인
- PyTorch 1.0: Autograd - eager mode에서의 자동 미분
- 연산이 실행되는 순간마다 dispatcher와 operator overloading으로 computation graph를 incremental하게 기록(record)
backward()호출 시 기록을 거꾸로 따라가며 gradient 계산requires_grad를 통한 추적 여부 선택, custom differentiable function 등록, codegen된 실제 C++ 코드 레벨 분석
- PyTorch 2.0: AOTAutograd - graph mode에서의 자동 미분
torch.compile()이 FX Graph를 먼저 캡처하는 방식에서는 기존의 incremental 기록 방식이 통하지 않는 문제- 해법: forward와 backward를 합친 joint graph 생성 → C++ dispatcher 수준의 trace → Min-Cut partitioning으로 forward/backward 분리 → 각각 backend compiler로 최적화 →
torch.autograd.Function으로 묶어 학습 루프에 연결
Background: Supervised Learning
머신러닝에서 지도학습(Supervised Learning)은 주어진 데이터로부터 최적의 함수를 찾아가는 과정입니다. 가장 간단한 예로 라는 모델이 있을 때, 훈련 데이터 쌍이 주어지면, 기울기()를 조금 조정하고 bias()를 조금 이동시키면서 데이터를 가장 잘 표현하는 weight 값을 찾아갑니다. Training data에 대한 loss가 줄어드는 방향으로 weight를 조금씩 바꾸는 과정이 학습(training)입니다.
Forward & Backward


네트워크의 가중치(예: )는 랜덤하게 초기화되거나 학습 중간 체크포인트에서 시작됩니다. 학습은 현재 가중치로 훈련 데이터에 대한 성능을 평가하고 가중치를 고치는 일을 반복합니다.
- Forward Propagation (순전파): 입력 데이터를 네트워크에 통과시켜 각 층의 가중치를 사용한 연산을 거쳐 출력값을 계산합니다.
- Loss 계산: 기대 출력(ground truth)과 네트워크 예측값의 차이를 loss function을 통해 계산합니다.
- Backward Propagation (역전파): 손실을 줄이기 위해 loss에서 출발하여 입력층까지 역방향으로 gradient를 계산합니다. 중간층의 모든 가중치에 대한 보정값을 구하는 이 과정을 backpropagation이라 합니다. 이를 프레임워크가 자동으로 해 주는 것이 Automatic Differentiation(AD)인데, AD는 backpropagation보다 넓은 개념이고 backpropagation은 그중 reverse mode를 신경망 학습에 적용한 것입니다.
- Optimizer: 계산된 gradient를 기반으로 optimizer가 가중치를 조정합니다. 이때 모델 아키텍처 자체는 변하지 않고, 가중치만 업데이트됩니다.
이 과정을 반복하면 손실이 점차 줄어들며, 목표 성능에 수렴하면 학습이 종료됩니다. 지도 학습은 대체로 이 흐름을 따릅니다.
(Reverse-Mode) Automatic Differentiation
Reverse-mode automatic differentiation은 역전파(backpropagation)를 구현하는 알고리즘으로, 다음 세 가지로 구성됩니다:
- Computation graph의 구성
- Computation graph 각 노드에서의 gradient function 도출
- Gradient를 전파하기 위한 graph의 backward walking
이 과정의 수학적 기반은 Chain Rule입니다.
(i) 일 때:
(ii) 이고 일 때 (parametric form):
예제: Autodiff 계산
다음 함수를 예로 들어보겠습니다:
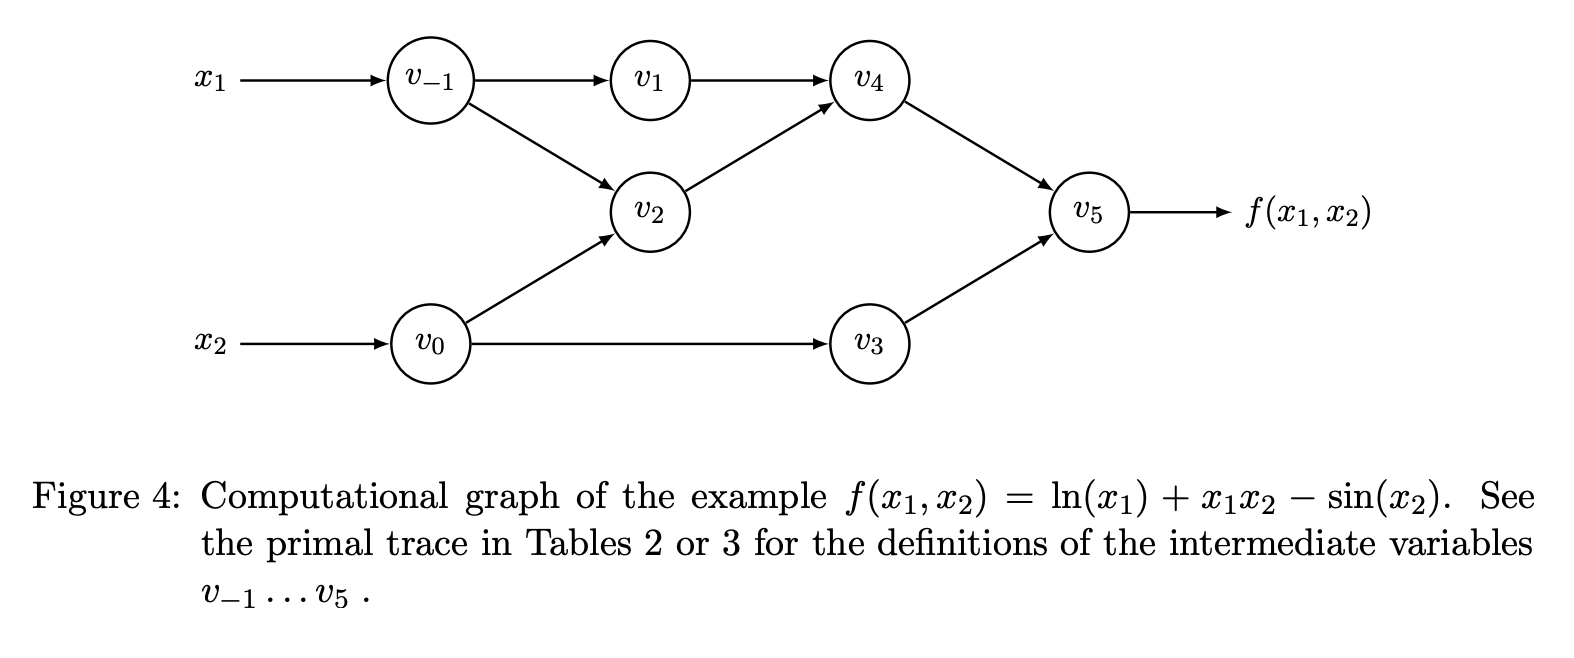
그래프의 각 중간값을 라고 하면, forward pass는 입력 , 에서 시작해 , , , , 순으로 값을 계산합니다. Reverse mode는 여기에 adjoint 를 정의하고, 출력에서 로 시작해 chain rule로 입력 쪽까지 거꾸로 전파합니다. 아래 표는 Baydin et al.의 예제로, , 일 때의 forward(왼쪽)와 reverse(오른쪽) 계산입니다.
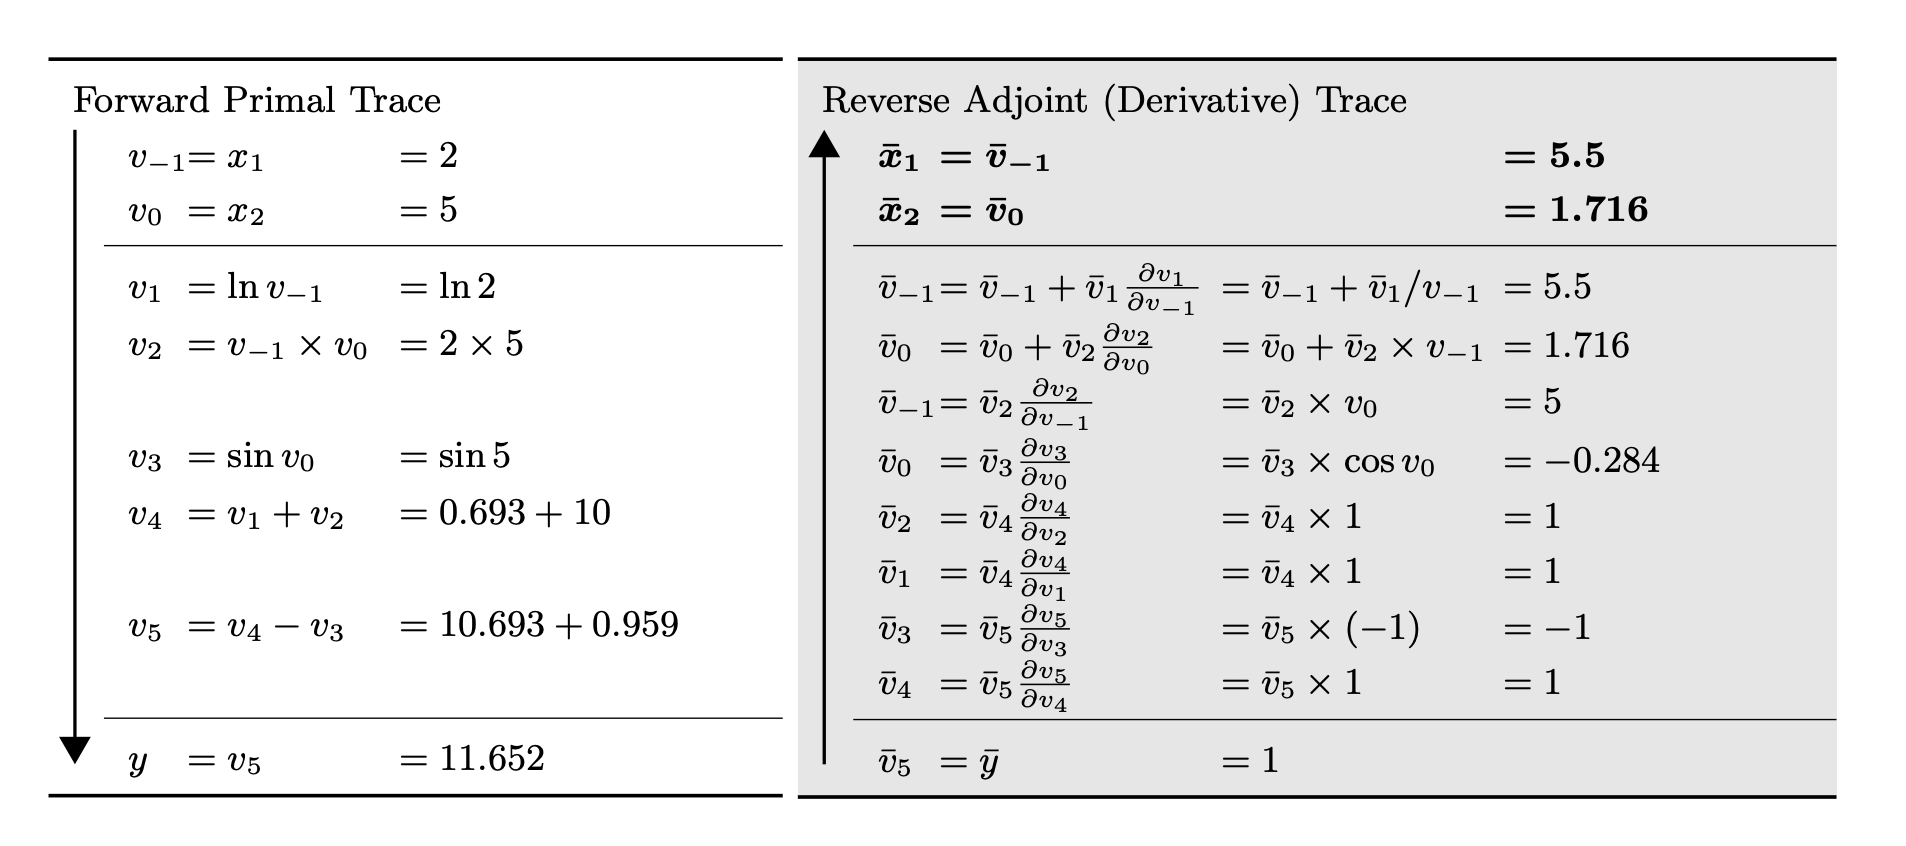
은 과 두 경로로 에 영향을 주므로, 은 두 경로의 기여를 더한 값입니다: . 자세한 내용은 Baydin et al. (2018)을 참고하세요.
예제: Forward & Backward 계산
PyTorch 1.0: Autograd
PyTorch의 reverse-mode automatic differentiation 구현은 Autograd입니다. “Autograd”라는 이름은 하버드 대학에서 NumPy 기반 automatic differentiation을 연구하던 팀이 먼저 썼고, 이 팀의 주요 멤버들은 이후 Google JAX 팀에 합류했습니다. PyTorch도 같은 이름을 사용하면서 초기에 이름 충돌에 대한 논의가 있었습니다.
Autograd의 세 가지 특징
Autograd는 텐서 연산의 미분을 자동으로 계산하므로, 개발자가 계산 그래프를 직접 정의하지 않아도 backpropagation을 수행할 수 있습니다. 특징은 세 가지입니다:
1. Eager Mode를 위한 Autograd
PyTorch는 Eager Mode를 기본으로 동작하며, 각 연산이 실행될 때마다 computation graph를 incremental하게 구축합니다 (반대 개념인 graph mode에서는 먼저 그래프를 모두 생성한 뒤 연산을 진행합니다).
이를 위해 PyTorch는 Dispatcher와 operator overloading을 활용합니다:
- Dispatcher는 연산 요청이 들어오면 해당 연산을 어떤 방식으로 처리할지 결정하고, 적합한 구현(Autograd dispatch key 등)을 호출합니다.
- Operator overloading은 AD 구현 방식의 이름(Baydin et al.의 분류)으로, 연산이 호출되는 시점에 기록을 남기는 방식을 뜻합니다. PyTorch에서는
+,*,@같은 연산자뿐 아니라torch.matmul같은 함수 호출도 dispatcher의 Autograd key에서 같은 방식으로 기록됩니다.
그래서 모델을 일반 Python 코드처럼 명령형으로 작성할 수 있습니다.
2. Tensor별 Gradient 선택
각 텐서별로 gradient 계산 여부를 선택할 수 있습니다. 딥러닝 모델에서 모든 텐서에 대해 gradient가 필요한 것은 아닙니다. 예를 들어 입력 데이터(input)는 값이 변하지 않으므로 backprop이 필요 없지만, 학습 대상인 weight는 backprop이 필요합니다.
텐서에는 requires_grad라는 flag가 있어서, 입력 중 하나라도 이 flag가 켜져 있으면 그 연산이 computation graph에 기록되고, backward에 필요하면 flag가 꺼진 입력도 함께 저장됩니다. 입력 어디에도 flag가 없는 연산은 기록하지 않습니다. Backpropagation 전에 gradient가 필요한 텐서를 transitive하게 골라 두므로, 필요 없는 gradient는 계산하지 않습니다. 이 기능은 학습 중 특정 텐서를 freeze하거나 모델의 일부만 미세 조정(fine-tuning)할 때 유용합니다.
3. Custom Differentiable Function
PyTorch에서는 기본 연산자(log, sin, polynomial 등) 외에 custom differentiable function도 정의할 수 있습니다. 잘 알려진 수학 함수의 미분은 PyTorch 내부에 구현되어 있지만, 사용자가 만든 custom op의 미분은 Autograd가 알 수 없습니다. 그래서 custom op을 추가한 개발자가 미분 규칙을 함께 등록합니다.
Autograd 동작 예제
- 변수: (
requires_grad = True로 마킹), , - 목표: 에 대한 의 gradient 구하기
x = torch.tensor(2.0)
x.requires_grad = True
y = x * 2
z = y ** 2
z.backward()
print(x)       # tensor(2., requires_grad=True)
print(y)       # tensor(4., grad_fn=<MulBackward0>)
print(z)       # tensor(16., grad_fn=<PowBackward0>)
print(x.grad)  # tensor(16.)
출력에서 눈여겨볼 부분:
- , 에 붙은
grad_fn(MulBackward0,PowBackward0) — forward 중에 Autograd가 남긴 기록 z.backward()— 이 기록을 거꾸로 따라가며 gradient 계산, 결과 이x.grad에 저장
x.grad에 저장된 값은 chain rule로 계산한 결과와 일치합니다:
아래에서 이 과정을 Step 1~4로 나누어 살펴봅니다.
Step 1: Tensor 생성
x = torch.tensor(2.0)
x.requires_grad = True로 초기화하고 requires_grad = True로 gradient 필요 여부를 마킹합니다. 이 시점의 computation graph에는 x:2 노드만 존재합니다.
Step 2: Forward 연산 (y = x * 2)
y = x * 2Forward 계산으로 가 저장됩니다. 에 미분이 필요하다고 마킹되어 있으므로 그 output인 도 gradient가 필요합니다. 이때 MulBackward0라는 grad function이 에 연결되어, multiplication에 의한 backward 과정이 필요하다는 것이 등록됩니다. (이 등록을 수행하는 forward kernel의 실제 C++ 코드와, MulBackward0 같은 grad function이 만들어지는 과정은 Step 4 뒤의 [참고] 섹션들에서 자세히 다룹니다.) Computation graph 상태는 다음과 같습니다:
이때 에는 grad_fn = MulBackward0가 붙습니다. 이 연결은 forward 데이터 흐름과 반대 방향이므로 아래 Step 3에서 따로 그립니다.
Step 3: Forward 연산 (z = y ** 2)
z = y ** 2Step 2와 동일한 과정이 반복됩니다. 이 계산되면서, Autograd는 와 도 gradient가 필요하다는 것을 인지합니다. Forward kernel은 compute_requires_grad 판별을 거쳐 PowBackward0 grad function을 bookkeeping해 둡니다 (이 판별 코드는 아래 [참고] 섹션에서 확인할 수 있습니다). PowBackward0는 backward 때 위에서 받은 gradient에 를 곱해 돌려주며, 그러기 위해 를 저장해 둡니다. 여기서 forward 계산이 끝나고 backward graph도 준비됩니다. Forward 데이터 흐름은 다음과 같고:
그 위에 Autograd가 남긴 grad_fn 연결은 반대 방향으로 이어집니다:
Step 4: Backward
z.backward()Step 4.1 - Backward 시작: Forward에서 기록한 순서를 거꾸로 따라갑니다. 출력 자신에 대한 편미분은 항상 1이므로, 상수 부터 시작합니다. 이 값이 PowBackward0로 전달되면, 의 미분 함수인 가 적용됩니다. 이때 는 위에서 들어오는 입력과는 상관없이 값에만 의존하며, 이므로 이 됩니다.
Step 4.2 - Gradient 전파: 다음 단계에서 에 대한 의 편미분 는 입니다. 위에서 내려온 민감도(gradient) 에 편미분 를 곱해 이 되고, 이 값이 x.grad에 저장됩니다.
따라서 입니다. 실제 신경망의 graph는 훨씬 크지만, 각 node에서 일어나는 계산은 이와 같습니다.
전체 backward 흐름:
검증: 이므로,
[참고] Forward에서 수행되는 AutoGrad kernel 예제: add
원본 슬라이드는 1.0 이전 세대의 “old style” 커널(VariableTypeEverything.cpp, AutoNonVariableTypeMode)을 보여줬지만, 큰 틀은 지금도 같으므로 여기서는 PyTorch v2.14.0에서 다시 생성한 코드를 씁니다. torch/csrc/autograd/generated/VariableType_2.cpp에는 다음과 같은 add_Tensor forward 커널이 생성되어 있습니다. (디버그 전용 #ifndef NDEBUG 블록의 storage alias 검증 코드와 forward-mode AD 블록(_any_has_forward_grad_result 관련)은 이 흐름과 관계없어 생략했습니다. Week 2의 코드와 같습니다.)
// torch/csrc/autograd/generated/VariableType_2.cpp
at::Tensor add_Tensor(c10::DispatchKeySet ks, const at::Tensor & self, const at::Tensor & other, const at::Scalar & alpha) {
  auto& self_ = unpack(self, "self", 0);
  auto& other_ = unpack(other, "other", 1);
  [[maybe_unused]] auto _any_requires_grad = compute_requires_grad( self, other );

  c10::intrusive_ptr<AddBackward0> grad_fn;
  if (_any_requires_grad) {
    grad_fn = c10::make_intrusive<AddBackward0>();
    grad_fn->set_next_edges(collect_next_edges( self, other ));
    grad_fn->alpha = alpha;
    grad_fn->other_scalar_type = other.scalar_type();
    grad_fn->self_scalar_type = self.scalar_type();
  }

  auto _tmp = ([&]() {
    at::AutoDispatchBelowADInplaceOrView guard;
    return at::redispatch::add(ks & c10::after_autograd_keyset, self_, other_, alpha);
  })();
  auto result = std::move(_tmp);

  if (grad_fn) {
      set_history(flatten_tensor_args( result ), grad_fn);
  }
  if (grad_fn) {
      fire_node_creation_hooks(grad_fn);
  }
  return result;
}
이 코드는 사람이 직접 작성한 것이 아니라, Autograd 라이브러리가 자동으로 생성(codegen)한 커널입니다. Week 2에서 본 것처럼 PyTorch는 텐서의 dispatch key로 어떤 함수를 dispatch할지 정합니다. Forward용 커널과 backward용 커널이 각각 존재하고, 하드웨어(CPU, GPU 등)에 따라 다른 함수를 dispatch할 수 있도록 설계되어 있습니다.
requires_grad가 켜진 텐서가 관여하는 연산에서는 Autograd dispatch key를 사용하여 dispatch가 이루어집니다. 이 커널은 backward에서 호출되는 함수가 아니라, forward에서 add를 처리하는 함수입니다. Forward를 수행하면서 나중에 backward가 될 때 어떻게 처리할지를 미리 기록해 두는 것입니다:
compute_requires_grad로 현재 계산이 나중에 gradient를 구해야 하는 계산인지 판별합니다.- 필요하다면 해당 연산의
grad_fn(예:AddBackward0)을 찾아 등록합니다.add라는 함수가 정해져 있으므로 PyTorch는 대응하는grad_fn이 무엇인지 알고 있습니다. next_edges로 입력 쪽 node를 연결해 backward graph를 구성합니다.- 이 모든 기록이 끝난 후에 실제 forward 계산을 수행합니다.
또한 특정 텐서에 requires_grad=True가 설정되어 있으면, 그 텐서로부터 영향을 받는 모든 output 텐서들도 자동으로 requires_grad=True가 됩니다(단, torch.no_grad()나 torch.inference_mode() 안에서는 연산 출력의 requires_grad가 False로 override됩니다. torch.ones(2, requires_grad=True)처럼 factory function으로 새로 만든 tensor는 예외로 True가 유지됩니다). PyTorch가 forward 과정에서 이를 추적하며 자동으로 설정합니다.
[참고] Grad Functions
Grad function(예: AddBackward0)은 autograd graph를 구성하는 Node 구현이며 dispatcher operator와는 다른 개념입니다. 이 클래스들은 derivatives.yaml에 정의된 operator별 미분 규칙으로부터 자동 생성됩니다.
1단계: derivatives.yaml의 미분 규칙 선언
예를 들어 add, mul, pow 연산은 tools/autograd/derivatives.yaml에 아래처럼 입력별 미분식이 선언되어 있습니다. (PyTorch v2.14.0 기준. 이 세 항목은 1.13 이후로 바뀌지 않았습니다.)
- name: add.Tensor(Tensor self, Tensor other, *, Scalar alpha=1) -> Tensor
  self: handle_r_to_c(self.scalar_type(), grad)
  other: handle_r_to_c(other.scalar_type(), maybe_multiply(grad, alpha.conj()))
  result: self_t + maybe_multiply(other_t, alpha)

- name: mul.Tensor(Tensor self, Tensor other) -> Tensor
  self: mul_tensor_backward(grad, other, self.scalar_type())
  other: mul_tensor_backward(grad, self, other.scalar_type())
  result: other_t * self_p + self_t * other_p

- name: pow.Tensor_Scalar(Tensor self, Scalar exponent) -> Tensor
  self: pow_backward(grad, self, exponent)
  result: auto_element_wise
각 입력(self, other, …)마다 “이 입력에 대한 gradient는 어떻게 계산하는가”를 수식으로 적어 두는 구조입니다.
2단계: Codegen이 만들어주는 backward 클래스
빌드 시 tools/autograd/gen_autograd_functions.py가 위 YAML을 읽어서 torch/csrc/autograd/generated/Functions.h와 Functions.cpp를 생성합니다. AddBackward0의 경우 다음과 같은 코드가 만들어집니다:
// Functions.h
struct TORCH_API AddBackward0 : public TraceableFunction {
  using TraceableFunction::TraceableFunction;
  variable_list apply(variable_list&& grads) override;
  std::string name() const override { return "AddBackward0"; }
  void release_variables() override {
  }

  // compiled autograd(Week 4 후반)가 쓰는 진입점
  void compiled_args(CompiledNodeArgs& args) const override;
  variable_list apply_with_saved(const variable_list& inputs, SwapSavedVariables& saved) override;
  at::Scalar alpha;
  at::ScalarType other_scalar_type;
  at::ScalarType self_scalar_type;
};
// Functions.cpp
static variable_list AddBackward0_apply_functional(
variable_list&& grads,
std::array<bool,2> needs_input_grad, at::Scalar& alpha, at::ScalarType& other_scalar_type, at::ScalarType& self_scalar_type)
{
IndexRangeGenerator gen;
auto self_ix = gen.range(1);
auto other_ix = gen.range(1);
variable_list grad_inputs(gen.size());
const auto& grad = grads[0];
bool any_grad_defined = any_variable_defined(grads);
if (needs_input_grad[/*other*/1]) {
auto grad_result = any_grad_defined ? (handle_r_to_c(other_scalar_type, maybe_multiply(grad, alpha.conj()))) : Tensor();
copy_range(grad_inputs, other_ix, grad_result);
}
if (needs_input_grad[/*self*/0]) {
auto grad_result = any_grad_defined ? (handle_r_to_c(self_scalar_type, grad)) : Tensor();
copy_range(grad_inputs, self_ix, grad_result);
}
return grad_inputs;
}
variable_list AddBackward0::apply(variable_list&& grads) {
IndexRangeGenerator gen;
auto self_ix = gen.range(1);
auto other_ix = gen.range(1);
auto needs_input_grad = std::array<bool, 2>{
task_should_compute_output({ self_ix }),
task_should_compute_output({ other_ix }),
};
return AddBackward0_apply_functional(std::move(grads), needs_input_grad, alpha, other_scalar_type, self_scalar_type);
}YAML의 self: / other: 표현식이 그대로 AddBackward0_apply_functional() 내부의 handle_r_to_c(...) / maybe_multiply(grad, alpha.conj())로 옮겨진 것을 볼 수 있습니다. 클래스 멤버(alpha, self_scalar_type, other_scalar_type)에는 forward 시점에 필요한 값을 저장해 두고, backward에서 그 값을 사용하도록 되어 있습니다. apply()는 어느 입력의 gradient가 필요한지(needs_input_grad)만 계산해서 이 함수에 위임하는데, 미분식을 멤버 변수와 분리된 free function으로 빼 둔 것은 뒤에서 볼 compiled autograd가 같은 함수를 재사용하기 위해서입니다(1.x에서는 apply() 안에 직접 들어 있었습니다).
같은 방식으로 MulBackward0, PowBackward0도 생성됩니다. 예를 들어 앞의 계산 그래프 예제에서 사용된 MulBackward0::apply는 다음과 같습니다:
static variable_list MulBackward0_apply_functional(
  variable_list&& grads,
  std::array<bool,2> needs_input_grad, Tensor& other, at::ScalarType& other_scalar_type, Tensor& self, at::ScalarType& self_scalar_type)
{
  IndexRangeGenerator gen;
  auto self_ix = gen.range(1);
  auto other_ix = gen.range(1);
  variable_list grad_inputs(gen.size());
  const auto& grad = grads[0];
  bool any_grad_defined = any_variable_defined(grads);
  if (needs_input_grad[/*other*/1]) {
    auto grad_result = any_grad_defined ? (mul_tensor_backward(grad, self, other_scalar_type)) : Tensor();
    copy_range(grad_inputs, other_ix, grad_result);
  }
  if (needs_input_grad[/*self*/0]) {
    auto grad_result = any_grad_defined ? (mul_tensor_backward(grad, other, self_scalar_type)) : Tensor();
    copy_range(grad_inputs, self_ix, grad_result);
  }
  return grad_inputs;
}

variable_list MulBackward0::apply(variable_list&& grads) {
  std::lock_guard<std::mutex> lock(mutex_);

  auto other = other_.unpack();   // forward에서 저장해 둔 SavedVariable을 꺼냄
  auto self = self_.unpack();
  IndexRangeGenerator gen;
  auto self_ix = gen.range(1);
  auto other_ix = gen.range(1);
  auto needs_input_grad = std::array<bool, 2>{
    task_should_compute_output({ self_ix }),
    task_should_compute_output({ other_ix }),
  };
  return MulBackward0_apply_functional(std::move(grads), needs_input_grad, other, other_scalar_type, self, self_scalar_type);
}self_.unpack(), other_.unpack()에서 볼 수 있듯 곱셈은 backward에서 원래 입력값이 필요하므로 SavedVariable 멤버로 저장해 두었다가 꺼내 쓰는 구조입니다. (add는 입력값이 필요 없으니 저장하지 않았던 것과 대비됩니다.) derivatives.yaml 항목 하나가 backward 클래스 하나가 됩니다. 개발자는 미분식만 선언하고, grad_fn 클래스와 dispatch 코드는 codegen이 만듭니다.
[참고] backward(): Python → C++
Python에서 backward()를 호출하면 C++ 레벨의 run_backward()로 연결되고, 이것이 Autograd Engine의 Engine::execute()를 호출합니다. execute()는 graph_task를 생성하고 compute_dependencies()로 각 node의 의존성 개수를 셉니다. torch.autograd.grad(inputs=...)처럼 특정 입력의 gradient만 요청한 경우에는 추가로 init_to_execute()로 실행할 node를 골라 두는데, 일반적인 backward()에서는 이 단계가 없습니다. 이후 worker thread의 thread_main()이 evaluate_function()으로 node를 하나씩 실행하고, 그 안의 call_function()에서 실제 grad function이 불립니다.
backward()
  └→ run_backward()
       └→ Engine::execute()
            ├→ compute_dependencies()
            ├→ graph_task->init_to_execute()   ← .grad(inputs=...) 경로에서만
            └→ execute_with_graph_task()
                 └→ thread_main()
                      └→ Engine::evaluate_function()
                           └→ call_function()  ← 실제 grad function이 불리는 곳
Python 레벨에서는 wrapper만 존재하고, 실제 구현은 대부분 C++로 작성되어 있습니다. GPU 환경에서는 CUDA 코드가 실행되지만, 전체 실행 흐름을 관리하는 큰 틀은 C++ 코드입니다. 각 단계에서 grad_fn을 찾아 실행하며, dispatch key를 통해 CPU 커널 또는 CUDA 커널을 선택합니다.
Eager mode에서는 매번 backward() 호출 시 이 준비 과정이 반복 수행되지만, gradient 함수를 찾아 등록하는 과정에 불과하므로 큰 오버헤드를 유발하지는 않습니다. 반면 graph mode에서는 gradient 계산을 포함한 전체 그래프를 미리 생성하여 최적화된 방식으로 실행합니다.
Eager mode Autograd의 구조는 PyTorch 1.0 이후 최신 버전까지 그대로입니다. 내부 구현은 바뀌었지만(예: 앞에서 본 _apply_functional 분리) 동작 방식은 같습니다.
PyTorch 2.0: AOTAutograd
PyTorch 1.0과 2.0의 가장 큰 차이는 실행 모델(execution model) 자체에 있습니다. PyTorch 1.0은 Eager Mode를 기본으로, 연산을 즉시 실행하면서 Autograd가 backward graph를 동시에 구축합니다. PyTorch 2.0은 torch.compile()을 통한 Graph Mode를 도입하여, 연산을 먼저 FX Graph로 캡처한 뒤 backend compiler(예: Inductor)로 최적화된 코드를 생성합니다. 이러한 실행 모델 변화는 automatic differentiation에도 재설계를 요구했고, 그 결과가 AOTAutograd입니다.
| 항목 | PyTorch 1.0 (Eager) | PyTorch 2.0 (Graph) |
|---|---|---|
| 실행 방식 | 연산 즉시 실행 | FX Graph 캡처 후 실행 |
| Forward 추적 | 실제 tensor | Fake tensor로 emulation |
| Backward graph 생성 | Forward 중 incremental 생성 | Forward FX Graph 완성 후 AOT 생성 |
| 미분 엔진 | Autograd | AOTAutograd |
| 최적화 단위 | 단일 op | Forward + backward joint graph |
Eager mode의 Autograd는 모든 연산이 하나씩 dispatcher를 지나며 실제로 실행된다는 전제에서 동작합니다. 연산이 실행될 때마다 출력 텐서에 grad_fn을 붙입니다. Graph mode에서는 이 전제가 성립하지 않습니다:
- 개별 eager operator 실행이 없음: 컴파일된 forward에서는 여러 연산이 하나의 kernel로 fusion될 수 있습니다. 따라서 eager Autograd가 operator 실행마다
grad_fn을 추가하는 방식을 그대로 적용할 수 없습니다. - Compiled region에 대한 미분 함수가 필요함: Captured FX graph 전체는
derivatives.yaml에 미분 규칙이 등록된 단일 operator가 아닙니다. Compiler는 graph 내부의 operator별 미분 규칙을 이용해 compiled region에 대응하는 backward graph를 별도로 생성해야 합니다. - Backward도 최적화 대상: Graph mode의 목적은 forward와 backward를 함께 놓고 최적화하는 것입니다(중간 결과를 저장할지 재계산할지 결정, forward/backward 경계를 넘는 fusion 등). 그러려면 backward graph가 실행 중에 발견되는 것이 아니라 컴파일 시점에 미리(ahead-of-time) 존재해야 합니다.
Eager mode에서는 지금도 Autograd를 그대로 씁니다. torch.compile() 경로에서만 “실행하면서 기록한다”는 전제가 성립하지 않아 별도의 미분 엔진이 필요합니다.
Graph mode에서는 fake tensor로 forward를 trace해 FX Graph를 먼저 만들고, backend compiler가 이 graph를 컴파일한 뒤 실제 계산을 합니다. 이때 backward graph를 얻는 방법은 두 가지가 있습니다:
-
Dynamo trace 중에 Autograd를 실행하여 backward graph 생성: Dynamo가 forward를 tracing하는 동안 기존 eager Autograd를 함께 돌려 backward graph까지 받아 내는 방법입니다. 그러나 Dynamo는 Python bytecode 수준의 tracer라서,
backward()가 실행하는 C++ Autograd engine 내부의 호출은 볼 수 없습니다. 또한 Dynamo trace는 graph break로 여러 구간으로 나뉘므로 backward graph 생성이 복잡해집니다. -
FX Graph를 먼저 만든 후 backward graph를 생성: 캡처된 FX graph를 fake tensor로 실행하면서
torch.autograd.grad까지 호출하고, 그 과정에서 dispatcher를 지나는 op을 기록해 backward graph를 얻습니다. C++ Autograd engine은 그대로 쓰되 실행을 기록 모드에서 하는 것입니다. Runtime에서는 compiled region과 그 backward를 하나의 differentiable operation처럼 Autograd graph에 연결합니다.
이 두 번째 아이디어를 바탕으로 AOTAutograd(Ahead-of-Time Autograd)가 개발되었습니다.
What happens when training with torch.compile()?
먼저 왼쪽의 Python 코드를 예로 들어보겠습니다. model이 어떤 input을 받아 output을 만들고, 이 output을 기대하는 reference와 비교하여 cross entropy로 loss를 계산한 후, loss.backward()를 호출하는 전형적인 학습 루프입니다. 이 코드를 eager mode로 실행할 때와 graph mode(torch.compile() 적용)로 실행할 때 내부에서 어떤 일이 일어나는지 비교해보겠습니다.
| 단계 | Eager Mode | Graph Mode (torch.compile()) |
|---|---|---|
| 사용자 코드 | | |
| 모델 준비 | 별도 준비 없음. model을 그대로 사용 | torch.compile(model)로 compiled 모델 생성. 이 시점의 “compile”은 backend compile이 아니라, Dynamo 등이 tracing할 수 있도록 준비된 모델을 만드는 것 |
| Forward 실행 | model(input) 호출 시 각 연산이 즉시 실행됨. requires_grad=True가 켜진 텐서에 대해 Autograd가 연산 시점마다 incremental하게 backward graph를 등록 | compiled_model(input) 호출 시 Dynamo가 tracing을 수행하며 가속 가능한 부분을 FX Graph로 캡처. 그 후 캡처된 그래프를 실행하여 output 계산 |
| Backward graph 구성 | Forward를 진행하는 동안 각 Op의 grad_fn이 출력 텐서에 붙으며 backward graph가 점진적으로 만들어짐 | FX Graph가 완성된 시점에 AOTAutograd가 개입하여 forward/backward joint graph를 ahead-of-time으로 생성 |
| Loss 계산 | F.cross_entropy(outputs, labels) - Autograd가 loss의 grad_fn을 이어 붙임 | 동일하게 수행. Compiled forward의 grad_fn이 loss의 backward chain에 연결됨 |
| Backward 실행 | loss.backward() 호출 시 Autograd engine이 미리 등록된 backward graph를 따라가며 gradient를 계산. 호출할 때마다 준비 과정이 반복됨 | loss.backward() 호출 시 compiled backward가 하나의 큰 Op으로서 실행됨. 첫 호출 시 backend lowering을 마친 뒤 실행 |
| 사용자 코드 차이 | 기존 방식 그대로 | torch.compile(model) 한 줄 추가 정도 |
사용자는 model 대신 compiled_model을 호출할 뿐이지만, 내부에서는 Dynamo가 forward graph를 capture하고 AOTAutograd가 backward graph 생성과 partitioning을 맡습니다.
아래는 torch.compile()을 적용한 학습 코드의 각 라인에서 실제로 어떤 일이 일어나는지를 번호로 표시한 것입니다. 왼쪽은 사용자가 작성하는 코드, 오른쪽은 AOTAutograd가 partition한 forward/backward graph를 TORCH_LOGS=aot_graphs로 출력한 예시입니다.
사용자 코드
compiled_model = torch.compile(model)

# [1]
outputs = compiled_model(images)
# [2]
loss = F.cross_entropy(outputs, labels)
# [3]
loss.backward()
AOTAutograd가 partition한 forward/backward graph (TORCH_LOGS=aot_graphs)
def forward(self, primals_1):
    _tensor_constant0 = self._tensor_constant0
    maximum_default = torch.ops.aten.maximum.default(
        primals_1, _tensor_constant0)
    mul_tensor = torch.ops.aten.mul.Tensor(maximum_default, 3)
    ge_scalar = torch.ops.aten.ge.Scalar(primals_1, 0)
    return [mul_tensor, ge_scalar]
    # ↑ Partitioner moved backward compute to forwards!

def backward(self, ge_scalar, tangents_1):
    mul_tensor_1 = torch.ops.aten.mul.Tensor(tangents_1, 3)
    scalar_tensor = torch.ops.aten.scalar_tensor.default(
        0.0, dtype=torch.float32, layout=torch.strided,
        device=device(type='cuda', index=0))
    where_self = torch.ops.aten.where.self(
        ge_scalar, mul_tensor_1, scalar_tensor)
    return [where_self]
오른쪽 코드는 partition된 forward/backward 두 FX graph의 Python 코드입니다. AOTAutograd의 runtime wrapper는 이 둘을 CompiledFunction이라는 torch.autograd.Function 안에 넣습니다. torch.autograd.Function은 앞에서 본 custom differentiable function 기능입니다. 그래서 compiled model은 forward와 backward를 모두 가진 하나의 custom Op처럼 동작합니다. 참고로 forward가 ge_scalar를 추가로 반환하는 것은 partitioner4가 backward 계산의 일부(ge 비교)를 forward 쪽으로 옮겼기 때문이며, backward는 이 값을 받아 재계산 없이 그대로 사용합니다.
위 코드가 나온 로그 화면입니다. 초록이 forward, 빨강이 backward이고, 아래에 원래 함수 torch.clamp_min(a, b) * 3과 derivatives.yaml의 clamp_min 미분 규칙이 함께 표시되어 있습니다.
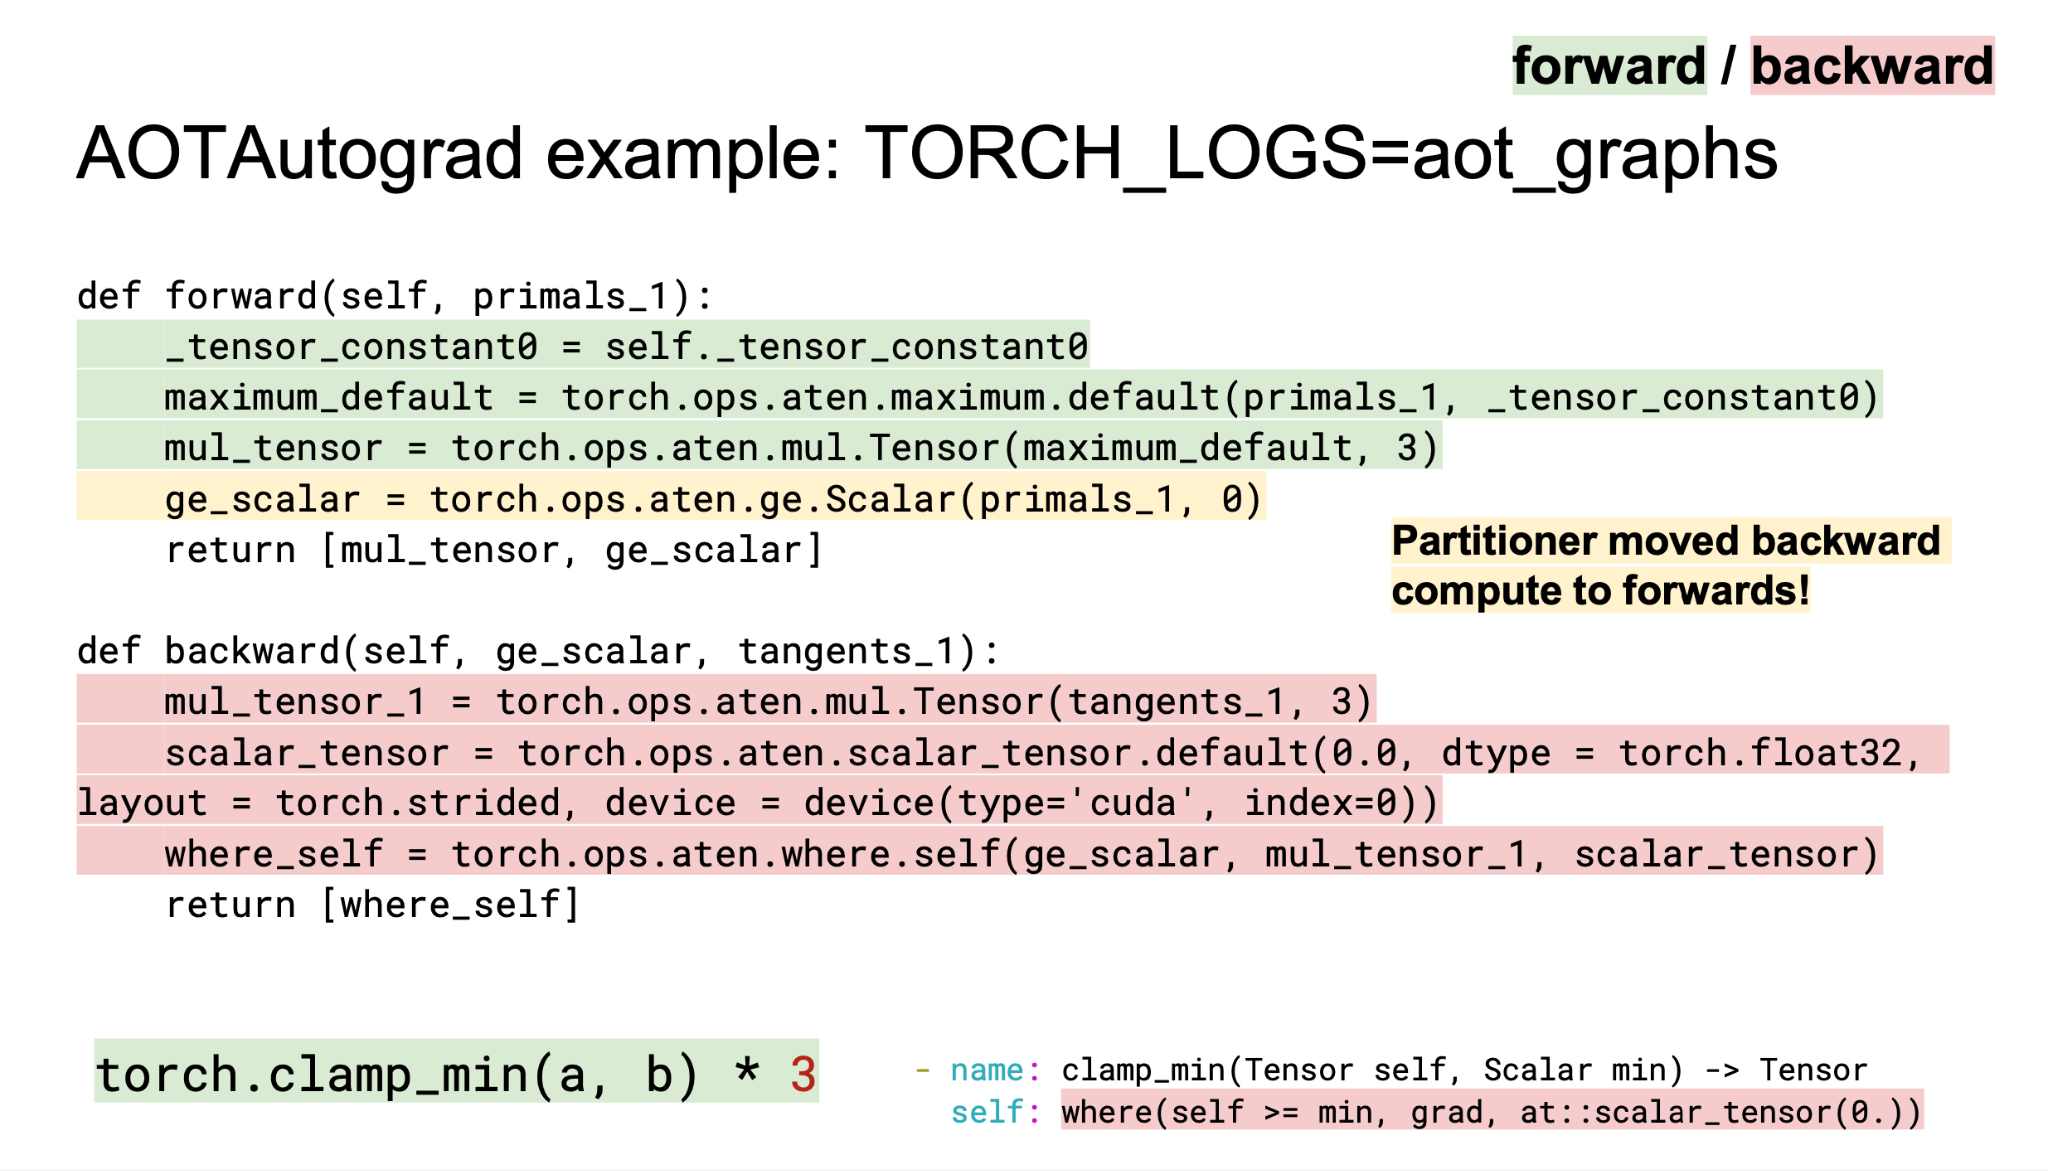
이제 왼쪽 사용자 코드에 주석으로 표시한 [1] → [2] → [3] 순서대로, 각 라인이 실행될 때 어떤 일이 일어나는지 하나씩 짚어 봅니다.
[1] outputs = compiled_model(images)
compiled_model(images)를 처음 호출하는 시점에 Dynamo가 모델을 tracing하여 FX Graph를 생성하고, 이 FX Graph가 AOTAutograd에 의해 compiled forward와 compiled backward를 모두 포함하는 torch.autograd.Function 객체로 변환됩니다 (torch.compile(model) 자체는 앞의 표에서 본 것처럼 준비 단계일 뿐입니다). 이후 이 객체의 forward 부분만 실제로 실행되어 outputs가 계산됩니다. 이와 동시에 outputs의 grad_fn으로 compiled backward가 등록되며, backward 부분 자체는 이 시점에서는 호출되지 않고 나중을 위해 보관됩니다. 다만 backward는 joint trace와 partitioning까지는 이 시점에 끝나 있지만, backend lowering(실제 backend compiler 호출)은 첫 backward() 호출 때까지 미뤄지는 것이 기본값입니다.5
[2] loss = F.cross_entropy(outputs, labels)
outputs에는 실제 계산된 값이 들어 있으므로 cross entropy 등의 loss를 계산할 수 있습니다. 이 계산은 requires_grad가 켜진 상태의 eager mode로 수행되며, 그 과정에서 loss function의 grad_fn이 새로 만들어집니다. outputs에 이미 붙어 있던 grad_fn(compiled backward)은 이 loss function의 grad_fn 뒤에 이어집니다.
[3] loss.backward()
loss.backward()를 호출하면 [2]에서 만들어진 loss function의 backward가 먼저 실행되고, 이어서 그 입력이었던 outputs의 grad_fn, 즉 [1]에서 등록된 compiled backward가 하나의 큰 Op으로서 호출됩니다. 두 backward가 차례로 실행되어 model weight의 gradient가 계산됩니다.
내부 구조를 요약하면, compiled forward+backward를 가진 torch.autograd.Function을 만들고, forward만 실행한 뒤 backward를 grad_fn으로 달아 두었다가 loss.backward() 때 호출합니다.
위 세 단계를 그림으로 요약하면 다음과 같습니다:
AOTAutograd의 joint graph 생성과 partitioning
Training mode에서 torch.compile()이 model의 forward와 backward graph를 compile할 때 중심이 되는 컴포넌트가 AOTAutograd입니다. AOTAutograd는 functorch 프로젝트에서 시작되어 PyTorch 2.0의 torch.compile training path에 통합된 compiler component입니다.6 Functionalization, decomposition, joint graph 생성과 partitioning을 담당합니다.
전체 흐름을 다이어그램으로 정리하면 다음과 같습니다:
Training mode에서는 Dynamo가 생성한 FX Graph가 AOTAutograd로 전달됩니다. AOTAutograd는 forward와 backward를 포함한 joint graph를 생성하고, 이를 compiled forward와 compiled backward로 partition합니다. Inference mode에서는 joint graph 생성과 partitioning을 생략하고 functionalization과 decomposition을 적용한 forward graph를 backend compiler로 전달합니다.
단계별로 일어나는 일:
nn.Module→ Dynamo → FX Graph: 입력된nn.Module을 Dynamo가 tracing하여 가속 가능한 부분을 FX Graph로 캡처합니다. (Week 3에서 다룬 내용입니다.)- FX Graph → AOTAutograd 개입: Training mode에서는 FX Graph가 backend compiler로 바로 넘어가지 않고, AOTAutograd가 먼저 개입합니다. AOTAutograd는 FX Graph를 가지고 forward와 backward 연산을 함께 포함하는 joint graph를 만든 뒤, 이를 forward와 backward로 다시 분리합니다.
- 각각 따로 Backend Compile: 분리된 forward graph와 backward graph를 각각 별도로 backend compiler(예: Inductor)에 넘겨 최적화된 형태로 컴파일합니다. Forward와 backward는 서로 다른 최적화를 받을 수 있습니다. 다만 backward의 backend lowering은 첫
backward()호출 시점까지 지연됩니다.5 torch.autograd.Function으로 wrap: 최적화된 forward와 backward 연산을 모두 포함하는 하나의torch.autograd.Function객체로 묶어 반환합니다.
torch.compile 실행 시 동작 흐름: Autograd가 활성화된 상태(즉 requires_grad=True인 tensor가 포함된 상태)에서 torch.compile을 호출하면 우선 원래 모델을 감싼 wrapper(OptimizedModule)가 반환되고, 첫 호출 때 위의 1~4번 과정이 순차적으로 일어나 forward와 backward를 모두 가진 torch.autograd.Function이 만들어집니다. 이때 forward의 backend lowering은 즉시 이루어지지만, backward의 backend lowering은 첫 backward() 호출 시점까지 지연됩니다.5 이후 training loop에서 이 객체를 호출하면, forward는 이미 컴파일된 형태로, backward는 첫 호출 시점에 lowering을 마친 뒤 그대로 실행되므로 가속된 training이 가능해집니다.
사용자에게 torch.compile()은 model을 compile하는 한 줄로 보이지만, 그 뒤에서는 AOTAutograd가 joint graph 생성 → forward/backward partitioning → 각각의 backend compilation → runtime Autograd 연결을 수행합니다. 다음 절부터 이 과정을 순서대로 살펴봅니다.
Graph Mode Backward의 도전 과제
Graph mode에서 backward를 만들 때 문제는 두 가지이고, AOTAutograd는 각각을 다음과 같이 해결합니다.
| Graph mode backward의 challenges | AOT Autograd의 해결책 |
|---|---|
문제 1. Autograd engine은 C++로 구현되어 있음
| → 해결 1. Backward를 C++ dispatcher 수준에서 tracing
|
문제 2. Dynamo가 생성한 FX Graph의 op들이 꽤 복잡
| → 해결 2. FX Graph를 먼저 functionalization + decomposition으로 단순화한 뒤 tracing
|
AOTAutograd는 이 두 방법으로 graph mode에서도 eager mode와 같은 방식으로 backward를 구성합니다:
- C++ dispatcher 수준의 backward tracing: Python tracer인 Dynamo가 보지 못하는 C++ Autograd engine의 호출을 기록
- Functionalization + decomposition: eager mode의 dispatcher가 암묵적으로 처리하던 mutation·aliasing과 복잡한 op을 graph에 명시
AOTAutograd Architecture
AOTAutograd의 전체 구조입니다.
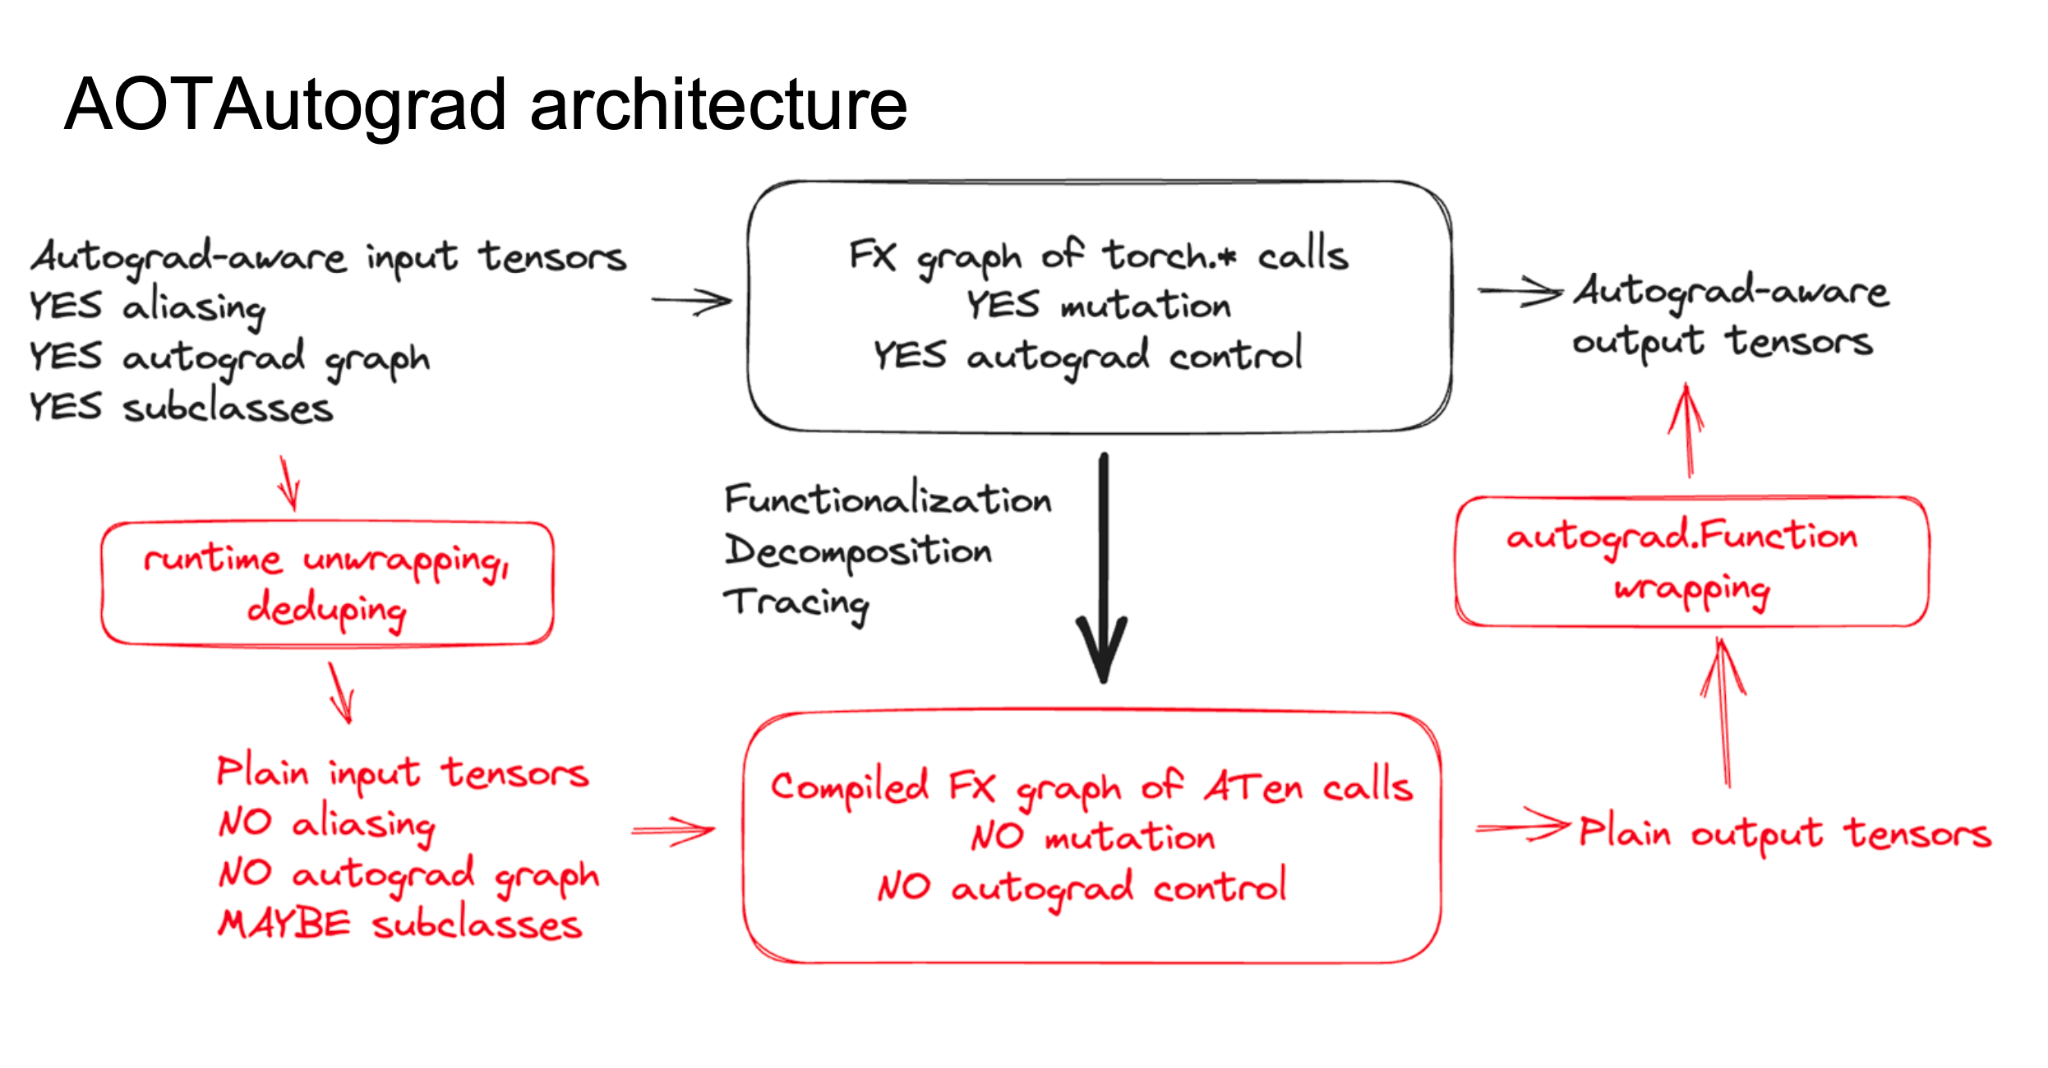
위 그림은 Dynamo가 넘긴 FX graph(위쪽 검은 상자: torch.* 호출, mutation과 autograd control이 남아 있음)가 backend가 다룰 수 있는 graph(아래 빨간 상자: ATen 호출만, mutation·autograd control 없음)로 바뀌고, 그 실행 결과가 다시 autograd에 연결되기까지를 보여줍니다. 세 가지 변환이 있습니다:
- Runtime unwrapping, deduping (왼쪽): autograd graph와 aliasing, subclass를 가진 입력 tensor를 풀어 plain tensor로 만들고, 같은 tensor가 여러 인자로 들어온 경우를 하나로 합칩니다.
- Functionalization, Decomposition, Tracing (가운데 화살표): mutation과 aliasing을 함수형 op으로 바꾸고
torch.*op을 ATen op으로 분해하면서 tracing합니다. 이것이 앞 절의 문제 2에 대한 해결이며, training이면 이 tracing이 backward까지 포함한 joint graph를 만듭니다(문제 1의 해결). - autograd.Function wrapping (오른쪽): compiled graph의 plain 출력을
torch.autograd.Function으로 감싸, 사용자가 보는 출력 tensor가 다시 autograd-aware가 되게 합니다. 이 객체가 앞서 이야기한 “compiled forward와 compiled backward를 모두 가진 custom differentiable function”입니다.
Dynamo와 backend compiler는 이 그림 밖에 있습니다. Dynamo는 위쪽 FX graph를 만들어 넘기고, backend compiler는 아래쪽 ATen graph(training이면 partition된 forward/backward)를 받아 컴파일합니다.
다음 절부터 이 흐름을 수행 순서(A~I), 코드 레벨 구현, 실제 예제 순으로 나누어 봅니다.
AOTAutograd 수행 순서
앞 절의 architecture 그림을 좀 더 잘게 쪼개면, AOTAutograd의 전체 수행 순서는 A부터 I까지 다음과 같이 정리할 수 있습니다:
| 단계 | 과정 |
|---|---|
| A | Dynamo가 생성한 FX Graph를 input으로 받음 |
| B | Forward와 backward를 합친 joint 함수를 생성 (아직 tracing은 일어나지 않음 - “trace할 함수”를 만들어 두는 단계) |
| C | Joint 함수에 functionalization 적용 (mutation·aliasing을 함수형 op으로 바꿔 eager mode 복잡성을 단순화) |
| D | Joint 함수를 호출하면서 실행된 op을 C++ dispatcher 수준에서 trace |
| E | Decomposition 적용 (복잡한 op을 작은 저수준 op으로 분해) |
| F | Joint trace로부터 joint FX Graph 생성 |
| G | Joint FX Graph를 forward/backward로 분리 (단순 슬라이싱이 아니라 Min-Cut 같은 전용 알고리즘 사용) |
| H | Forward/backward를 각각 backend compiler로 컴파일 |
| I | Compiled function들을 묶어 최종 torch.autograd.Function 생성 |
B 단계: “joint 함수를 만들어놓기”: B 단계에서는 아직 tracing이 일어나지 않고, trace할 함수만 준비합니다. 원래의 forward 함수와 C++ 쪽 grad 함수를 연달아 호출하는 Python-level 함수를 하나 만듭니다. 이 joint 함수를 한 번 호출하면 forward와 backward가 함께 trace됩니다.
Joint 함수를 만드는 이유: forward와 backward를 따로 컴파일할 것인데도 먼저 하나로 합치는 이유는 recomputation 때문입니다. Training의 backward는 forward에서 계산한 중간 tensor를 사용합니다. 이 값을 모두 저장하면 메모리를 많이 사용하고, 저장하지 않으면 backward에서 다시 계산해야 합니다. 어느 쪽이 유리한지 판단하려면 “forward에서 만들어진 어떤 tensor가 backward의 어떤 input으로 연결되는가”를 알아야 합니다. Joint graph로 묶으면 이 관계가 graph에 살아 있으므로 partitioner가 save와 recompute 중 하나를 선택할 수 있습니다.
Joint 함수 생성 과정의 구체적 동작: Eager mode에서는 forward operator를 실행할 때 각 tensor에 grad_fn을 추가해 backward graph를 점진적으로 만듭니다. AOTAutograd는 functionalized forward와 Autograd의 backward 계산을 함께 tracing해, forward tensor와 backward input 사이의 dependency가 포함된 joint graph를 생성합니다. 이 단계의 목적은 gradient 값을 즉시 계산하는 것이 아니라 compiler가 분석할 단일 계산 graph를 얻는 것입니다.
Functionalization과 decomposition(C/E 단계)이란? Eager mode에서 암묵적으로 처리되는 aliasing, mutation, view/storage 동작을 graph의 명시적인 operation으로 변환하고, 고수준 operator를 backend가 처리할 수 있는 operator로 분해하는 과정입니다. Functionalization은 mutation과 aliasing을 함수형 표현으로 바꾸고, decomposition은 고수준 operator를 더 작은 operator 조합으로 변환합니다.
H 단계: Backend Compile의 범위: H 단계의 “컴파일”은 backend compiler(예: Inductor)가 kernel 생성 등 backend 고유 최적화를 거쳐 코드를 만드는 과정입니다. 단 E 단계의 분해 규칙과 G 단계의 partition 방식은 그 전에 backend가 미리 넘겨 둡니다(Inductor의 decompositions, partition_fn).
G 단계: Partitioning 방식: Forward/backward를 어디서 쪼갤지는 Min-Cut 계열 알고리즘이 결정합니다. 이는 recomputation과도 연결되는 부분으로, “어디서 자르는 것이 메모리/연산 측면에서 가장 유리한가”를 전체 joint graph의 input-output 관계를 보고 결정하는 문제입니다. 알고리즘은 뒤의 “Min-Cut Algorithm으로 Forward/Backward 분리” 절에서 다룹니다.
AOTAutograd 코드 레벨 동작
위에서 A~I로 정리한 단계들을 실제 코드 레벨(Python과 C++이 섞여 있지만 여기서는 Python 쪽에 초점)에서 다시 한 번 따라가 보겠습니다. 가장 top-level 함수는 aot_dispatch_autograd()이며, 여기서 일어나는 일은 크게 세 덩어리로 볼 수 있습니다:
aot_dispatch_autograd_graph()를 호출하여 joint FX Graph를 만들어내기 (A~F)- 그 joint FX Graph를 G 단계의 partitioning으로 forward/backward로 분리하고 각각 컴파일 (G~H)
- 컴파일된 forward/backward를
torch.autograd.Function으로 wrap해서 return (I)
아래 함수명은 강의가 참조한 버전 기준이며, 최신 PyTorch에서는 aot_stage1_graph_capture / aot_stage2_autograd / _aot_stage2a~c_*로 스테이지가 재분할되었습니다. 단계 구조 자체는 동일합니다.
# A: 최상위 함수
aot_dispatch_autograd(flat_fn)
  # Joint FX Graph 생성
  fx_g = aot_dispatch_autograd_graph(flat_fn, ...)
    # B: Joint 함수 생성. forward와 backward를 붙여서
    #    forward만 실행해도 둘 다 계산되는 함수를 만듦
    joint_fn_to_trace = create_joint(flat_fn, ...)
      def inner_fn(...)
        outs = fn(*primals)                    # Forward 실행
        backward_out = torch.autograd.grad(...)  # Backward 실행
        return outs, backward_out
    # C: Functionalization. eager mode의 mutation/aliasing 제거
    joint_fn_to_trace = create_functionalized_fn(joint_fn_to_trace, ...)
    joint_fn_to_trace = aot_dispatch_subclass(joint_fn_to_trace, ...)
    # D, E, F: 실제 tracing 수행 + Decomposition + FxGraph 생성
    #   D: joint_fn_to_trace에 대한 실제 tracing이 일어남
    #   E: Decomposition (tracing 중 적용, Torch IR → ATen IR)
    #   F: 최종 Joint FX Graph 생성
    fx_g = _create_graph(joint_fn_to_trace, ...)
  # G: Partitioning. Joint FX Graph를 forward/backward로 분리
  fw_module, bw_module = partition_fn(fx_g, ...)
  # H: Compile 수행. 각각 backend compiler로 컴파일
  compiled_fw_func = fw_compiler(fw_module, ...)
  compiled_bw_func = bw_compiler(bw_module, ...)  # lazy: 실제로는 첫 backward() 호출 때 수행
  # I: 최종 결과물. torch.autograd.Function으로 wrap하여 반환
  compiled_fn = AOTDispatchAutograd.post_compile(compiled_fw_func, ...)
이 중 가장 복잡한 부분은 joint FX Graph를 만들어내는 과정(B~F)이고, 그 외 G~I는 상대적으로 기계적인 단계에 가깝습니다.
- B 단계 -
create_joint(flat_fn, ...): Forward 부분과 backward 부분에 해당하는 함수를 하나로 붙여서, “forward 쪽만 호출해도 내부적으로 forward와 backward가 같이 계산되는 함수”를 만들어 둡니다. 위 코드의inner_fn이 그 함수이고,fn(*primals)로 forward를 실행한 뒤 곧바로torch.autograd.grad(...)로 backward까지 실행하도록 묶어 놓은 형태입니다. - C 단계 - Functionalization: B에서 만든 joint 함수를 그대로 trace하면 eager mode의 복잡성(aliasing, mutation 등)이 그대로 따라 들어오기 때문에,
create_functionalized_fn,aot_dispatch_subclass등을 통해 먼저 함수 자체를 함수형으로 바꿔 둡니다. - D~F 단계 -
_create_graph(joint_fn_to_trace, ...): 여기가 실제로 tracing이 일어나는 지점입니다. functionalize된 joint 함수를 C++ dispatcher 수준에서 trace하여 decomposition까지 적용한 뒤, 최종 joint FX Graph를 만들어냅니다.
여기서 C 단계의 functionalization과 E 단계의 decomposition은 목적이 다릅니다. Functionalization은 eager mode가 가지고 있던 복잡한 동작(aliasing, mutation 등)을 명시적으로 풀어내는 과정인 반면, decomposition은 수많은 Torch Op을 backend가 정한 더 작은 ATen Op 집합으로 표현하기 위한 IR 변환 과정(Torch IR → ATen IR)입니다. 두 과정을 거쳐 만들어진 joint FX Graph가 G 단계의 partitioning으로 forward/backward로 다시 쪼개지고, H 단계에서 각각 backend compile된 뒤, I 단계에서 torch.autograd.Function으로 wrap되어 return됩니다.
AOTAutograd 실행 예제
이후 단계별 설명에서 사용할 실행 예제 코드입니다:
@torch.compile()
def func(a, b):
    return torch.clamp_min(a, b) * 3

p = torch.tensor([0.4, -0.2], requires_grad=True, device='cuda')
loss = func(p, 0).sum()
loss.backward()
print(p.grad)
AOTAutograd 단계별 상세 (B~I)
A~I 단계 중 주요 단계를 위 실행 예제로 따라갑니다. B 단계의 joint 함수 생성에서 시작해, joint graph tracing(D), decomposition(E), Min-Cut partitioning(G)을 거쳐 최종적으로 torch.autograd.Function이 만들어지는 I 단계까지 이어집니다.
Joint Graph 생성
B 단계(joint 함수 생성) → D 단계(실제 tracing) → G 단계(partitioning)를 슬라이드의 코드로 확인합니다. Joint graph를 trace하기 전에 Python 수준에서 joint 함수를 먼저 만듭니다.
출처: How does torch.compile work with autograd? - PyTorch Dev Discussions
[B-1] Dynamo가 만들어낸 FX Graph (forward만 있음)
def f(*inputs):
    return outputs
Dynamo가 만들어낸 이 FX Graph는 joint graph의 forward 부분에 해당합니다. 이 자체로는 backward가 없기 때문에, training을 위해서는 여기에 backward를 붙여야 합니다.
[B-2] Forward + Backward를 합친 joint 함수
# In order to get the backwards pass, we trace something like:
def joint_fw_bw(fw_inputs, grad_outs):
    fw_out = f(*fw_inputs)
    grad_inps = torch.autograd.grad(
        fw_out, leaves=fw_inputs, gradOuts=grad_outs)
return fw_out, grad_inpsf()를 수행한 뒤 곧바로 torch.autograd.grad()를 호출하여 backward까지 같이 수행하는 하나의 함수로 묶어 둡니다. (위 코드는 원문 슬라이드의 pseudocode를 그대로 옮긴 것으로, 실제 torch.autograd.grad의 인자 이름은 inputs=, grad_outputs=입니다.) 이 함수를 한 번 호출하면 forward 다음에 backward가 이어서 실행됩니다.
[D] joint 함수를 trace하여 Joint Graph 생성
joint_fw_bw를 (내부의 torch.autograd.grad 호출이 동작하는 상태 그대로) C++ dispatcher 수준에서 trace하면, autograd가 만들어내는 backward 계산 경로까지 함께 기록되어 forward와 backward가 모두 포함된 joint graph가 한 번에 만들어집니다.
Joint Function의 Input 구성
joint_fw_bw의 입력은 두 종류로 구성됩니다:
- Forward Input (
fw_inputs): 원래 모델이 받는 입력값과, 모델의 parameter·buffer. AOTAutograd는 parameter와 buffer도 flat input으로 앞쪽에 넣어 넘기므로(aot_autograd.py의num_params_buffers), 그 gradient가 backward output으로 나옵니다. - Backward Input (
grad_outs): Loss로부터 전달되는 최종 gradient 값.
grad_outs가 필요한 이유는 backward 계산이 위에서 내려오는 gradient(incoming gradients)에 의존하기 때문입니다. Backward에 필요한 재료는 ① 위에서 내려오는 gradient와 ② forward 중간 단계에서 계산된 tensor들인데, 중간 tensor들은 joint graph 안에 forward 부분으로 이미 포함되어 있으므로 별도 input으로 넘길 필요가 없습니다. 반면 위에서 내려오는 gradient는 graph 바깥에서 들어오는 값입니다 — 학습 루프 관점에서 보면 loss function이 이 FX Graph 밖에 있으므로, loss에서 내려오는 grad_outs만큼은 반드시 joint 함수의 input으로 넣어 줘야 최종 gradient를 끝까지 계산할 수 있습니다.
[G] Joint Graph → Forward/Backward 분리
Then, we simply partition this graph into two
to give us the forwards pass and the backwards pass.
이렇게 얻어진 joint graph를 적절한 기준(이후 절에서 다룰 Min-Cut 알고리즘)으로 partition하면 forward pass와 backward pass로 다시 분리할 수 있습니다. 다만 이 분리가 두 그래프를 완전히 겹치지 않게 나누는 것은 아닙니다(not strictly disjoint). 메모리 효율을 위해 backward pass가 forward graph의 일부를 재계산(recomputation)하도록 만들 수 있으며, 어느 중간 결과를 저장하고 어느 것을 재계산할지는 partitioning 단계에서 정합니다. 이 주제는 뒤의 “Activation Checkpointing” 절에서 다시 다룹니다.
[D 단계] Joint Graph Example
앞 절의 joint_fw_bw를 C++ dispatcher 수준에서 trace하면, forward와 backward가 모두 하나의 graph 안에 들어간 joint FX Graph가 만들어집니다. 이것이 수행 순서표의 D 단계 결과물입니다.
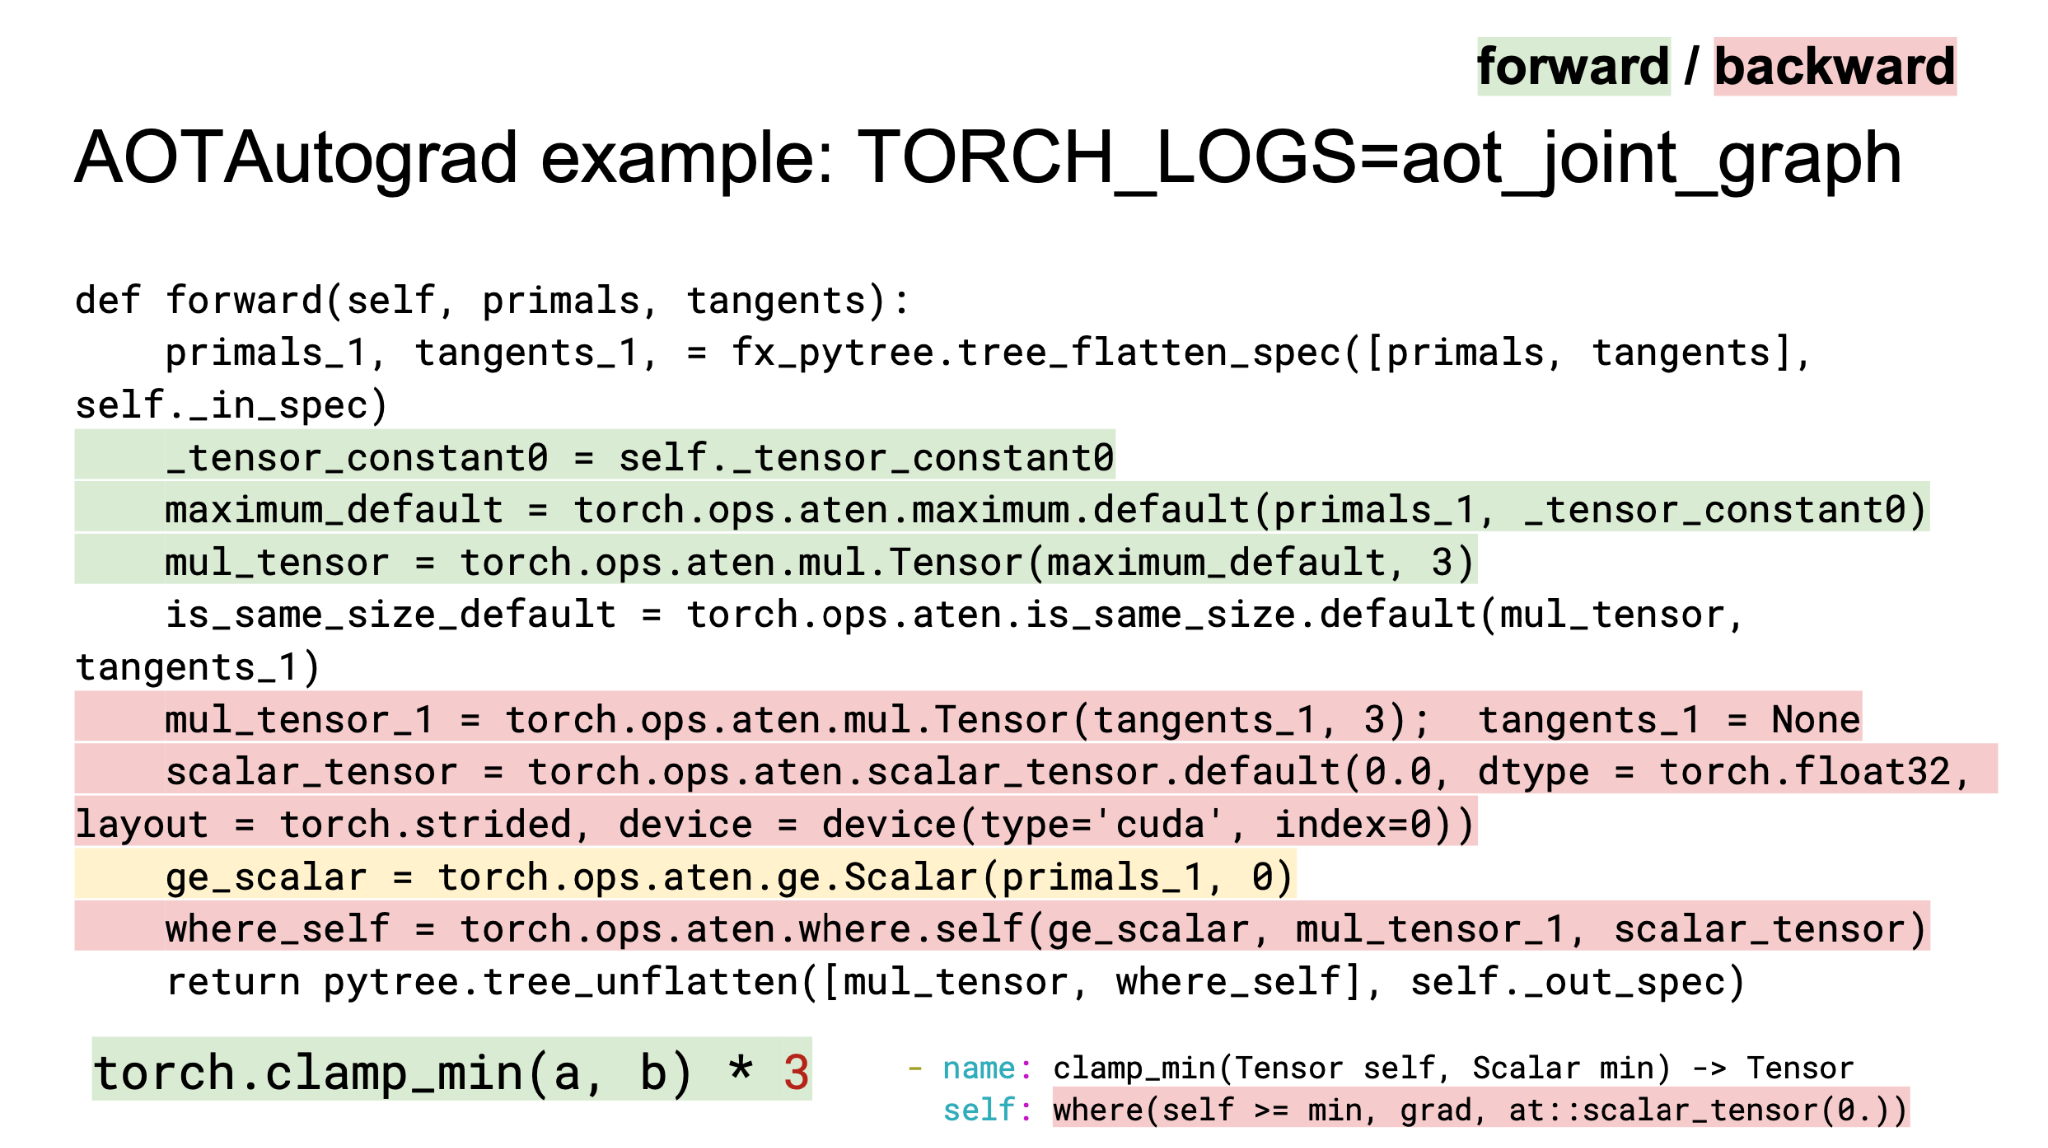
위 graph에는 forward와 backward 연산이 함께 있고, forward에서 만들어진 중간 tensor가 backward node의 input으로 연결되는 관계도 살아 있습니다. G 단계의 partitioner는 이 정보를 이용해 저장할 tensor와 재계산할 tensor를 결정합니다.
[E 단계] Decomposition (+ Functionalization)
Decomposition은 실제로는 D 단계의 tracing 중에 적용됩니다. dispatcher를 지나는 op마다 decomposition table에 등록된 규칙이 있으면 더 작은 ATen op으로 바꿔 기록하므로, 결과 joint graph는 이미 ATen 수준입니다(앞의 joint graph 그림에 clamp_min이 아니라 aten.maximum이 보이는 이유입니다). 여기서는 이해를 위해 E 단계로 따로 떼어 설명합니다.
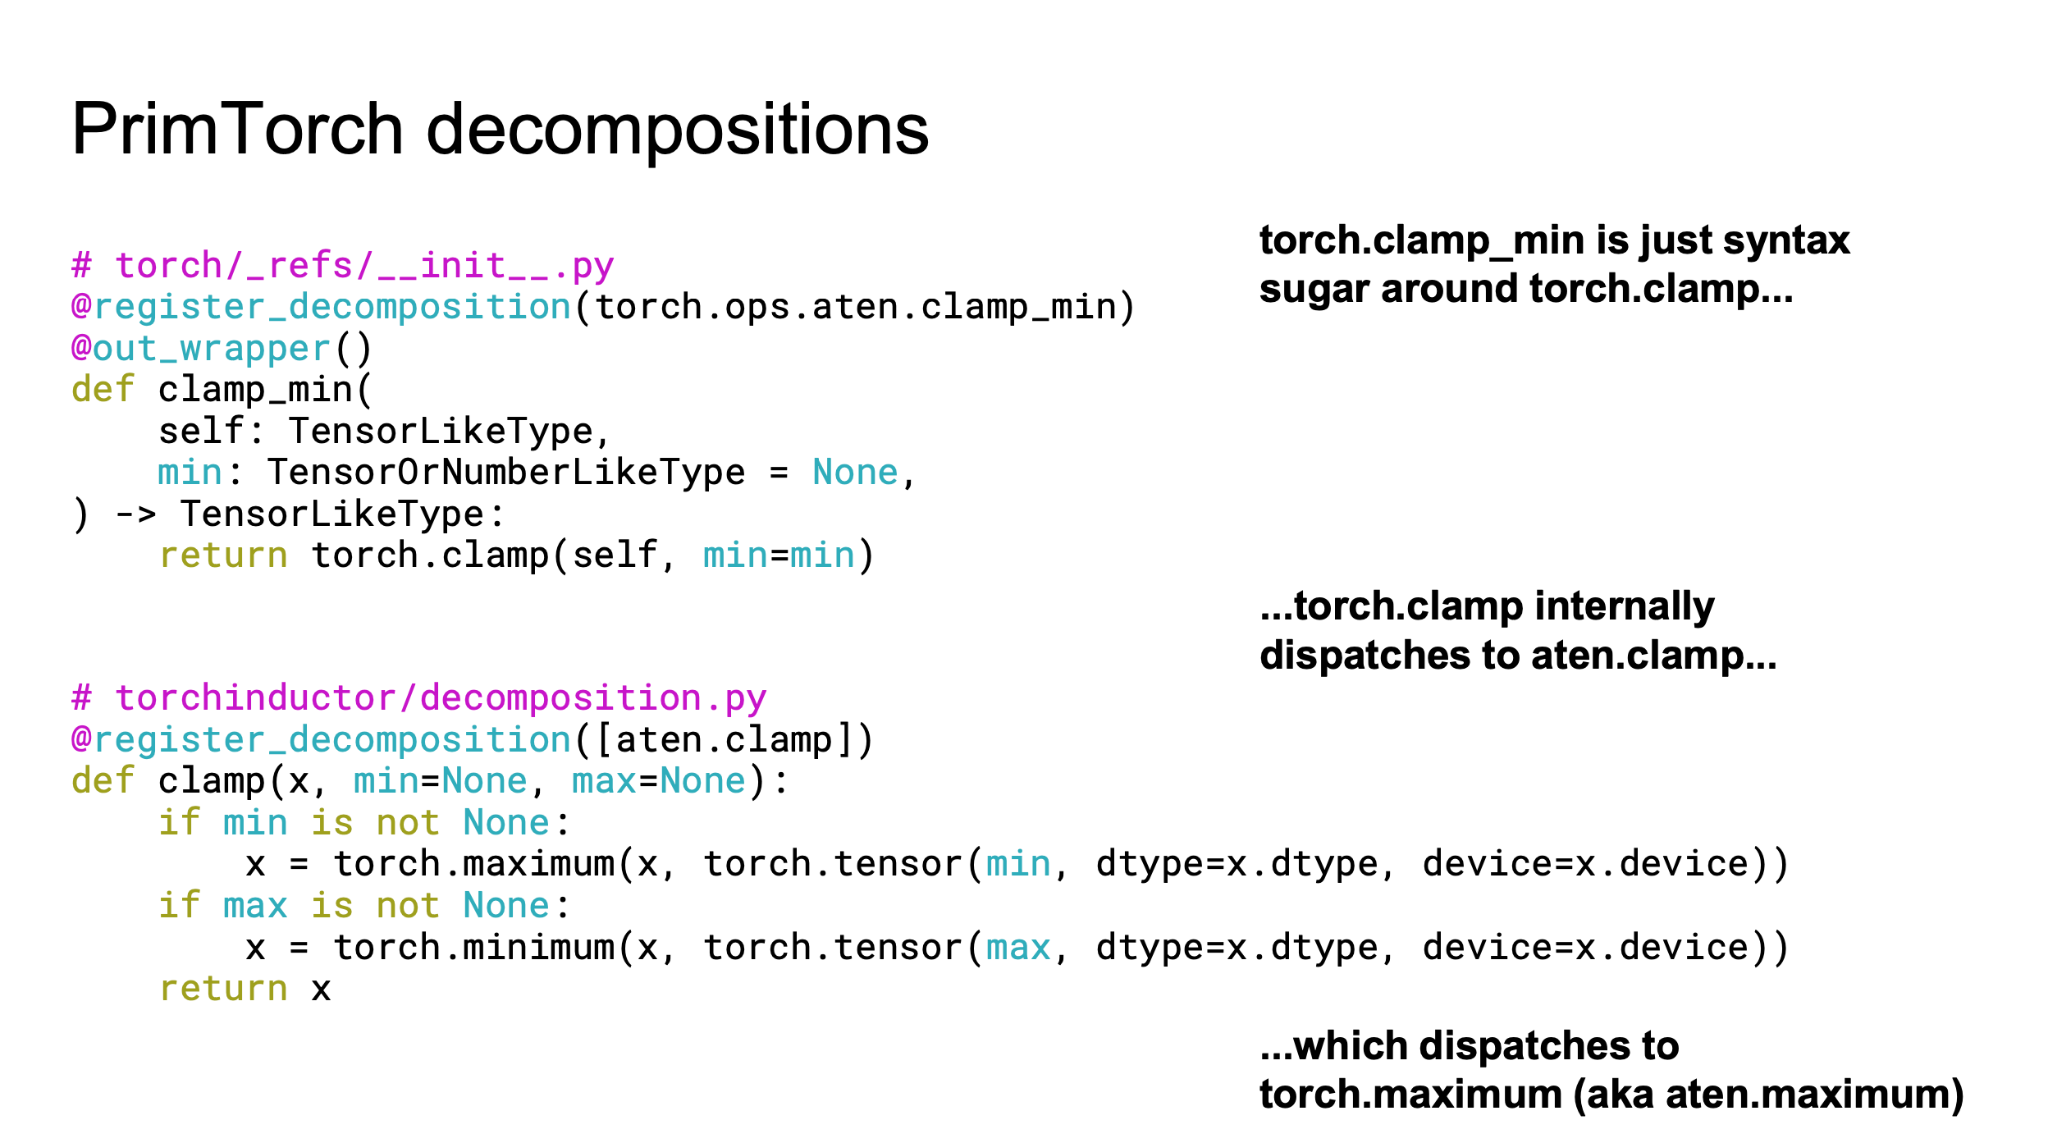
IR 계층은 다음과 같이 내려갑니다:
Torch IR → ATen IR → (backend가 원하면) Core ATen IR
Prims IR까지 완전히 분해하는 것은 별도 경로이며, Inductor는 ATen 수준에서 lowering합니다.
- Functionalization (C 단계 일부): Eager mode가 암묵적으로 허용하던 in-place mutation, aliasing 등을 명시적으로 풀어내 pure function 형태로 변환.
- Decomposition (E 단계): 수천 개에 달하는 Torch op을 backend가 정한 더 작은 ATen op 집합으로 분해 - eager mode 복잡성 제거와는 별개의 목적(op set 축소)으로, backend 최적화가 쉬워집니다.
[G 단계] Min-Cut Algorithm으로 Forward/Backward 분리
Functionalization과 decomposition을 거친 joint FX Graph를 G 단계에서 forward와 backward로 다시 나눕니다. 앞서 말한 Min-Cut 계열 알고리즘이 사용되며, 이 단계의 결정이 곧 “어느 중간 텐서를 저장(save)하고 어느 것을 재계산(recompute)할지”와 직결됩니다.
입력은 [D 단계]의 joint graph입니다. Min-Cut rematerialization partitioner를 사용하는 구성에서는 이 graph를 compiled forward와 compiled backward용 FX Graph로 분리하면서 save와 recompute 대상을 함께 결정합니다.
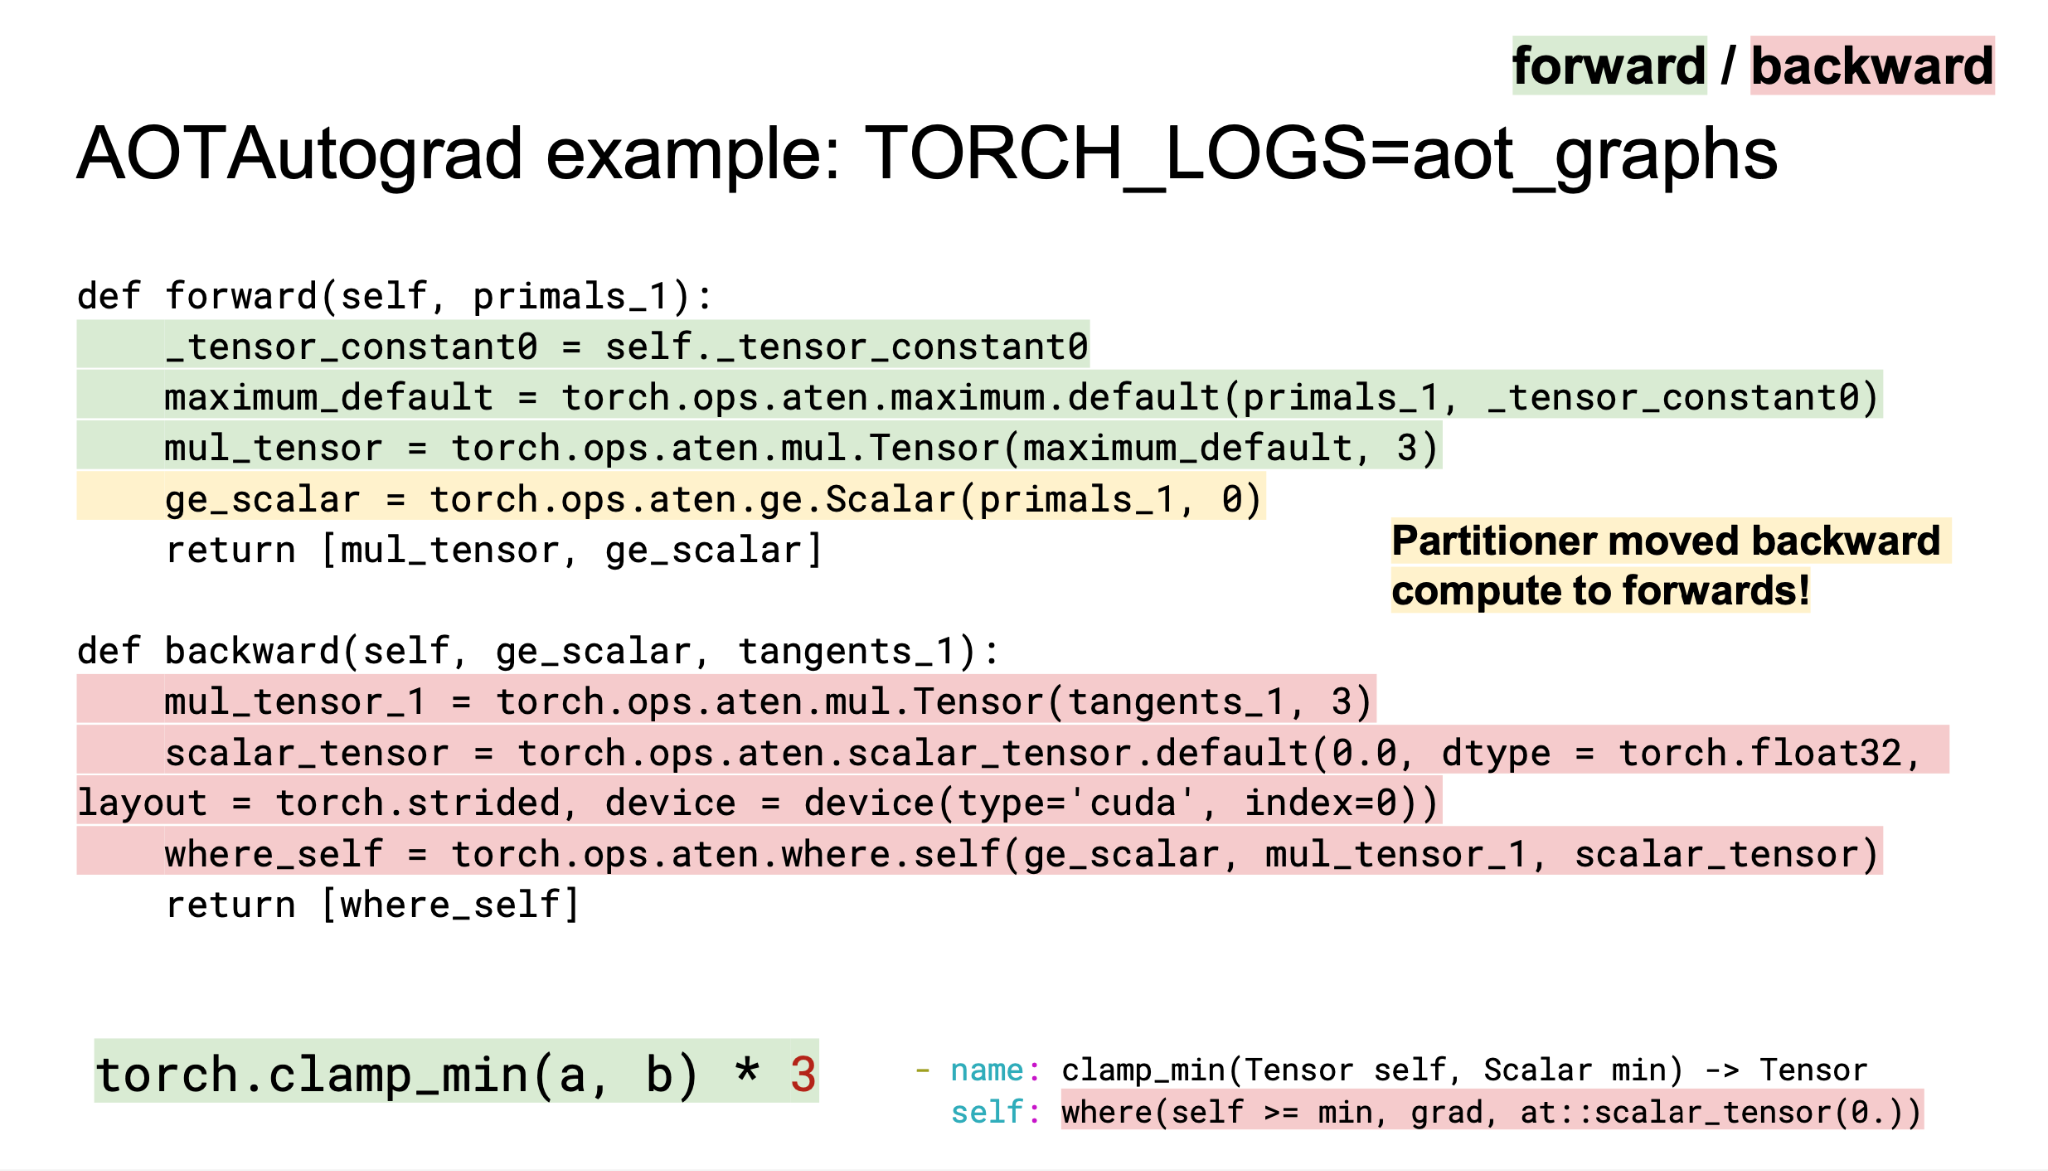
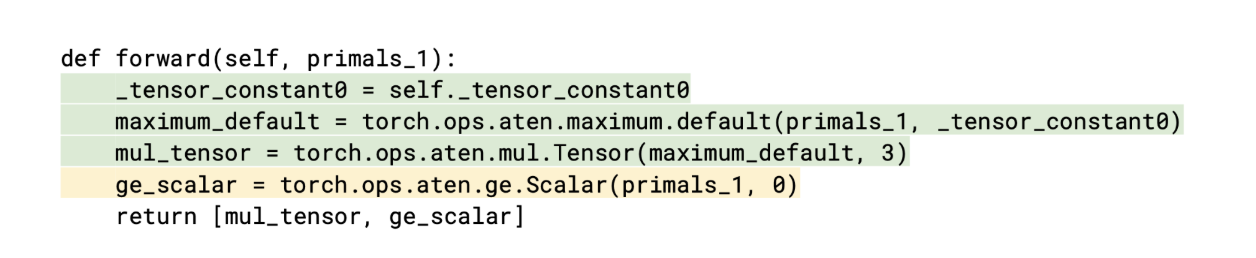
Partitioner는 계산을 어느 graph에 둘지도 정합니다. 앞쪽 “What happens when training with torch.compile()?” 절에서 본 compiled forward/backward 코드를 다시 떠올려 보면, backward에서 쓰일 비교 결과(ge_scalar)가 forward 쪽에서 미리 계산되어 반환되고 있습니다. 이것이 슬라이드의 “Partitioner moved backward compute to forwards!” 주석이 가리키는 부분이며, partitioner가 메모리/연산 trade-off를 고려해 계산 위치를 옮긴 결과입니다.
Partitioning이 끝나면 forward graph와 backward graph 각각이 독립된 FX Graph로 떨어져 나오고, 이후 H 단계에서 backend compiler(예: Inductor)가 forward/backward를 각각 별도로 컴파일하여 최적화된 실행 코드를 생성합니다.
Activation Checkpointing
앞서 joint graph가 필요한 이유를 설명할 때 잠깐 언급했던 recomputation(재계산)은, training 분야에서는 보통 “activation checkpointing” 이라는 이름으로 더 많이 불립니다. (강연자 역시 training 전문가는 아니어서 이 용어가 다소 낯설 수 있다고 언급했습니다.)
Batch size가 커질수록 forward 과정의 중간 activation도 함께 커지며, 이 값들을 전부 저장해 두면 GPU 메모리를 상당히 많이 차지합니다. Checkpointing을 적용하면 일부 activation(checkpoint)만 저장해 두고, backward를 수행할 때 checkpoint에서 forward를 다시 돌려 필요한 중간값을 그때그때 재계산합니다.
Recomputation이란? 모델 학습 과정에서 일부 중간 계산(특히 중간 activation)을 곧바로 저장하지 않고, 나중에 필요할 때 다시 계산함으로써 GPU 메모리를 절약하는 기법입니다. Forward 과정에서 모든 중간 값을 전부 저장해 두면 메모리를 많이 차지하지만, 일정 부분만 저장해 두고 backward 과정에서 필요한 시점에 다시 계산(재계산)하게 되면 메모리 사용량을 크게 줄일 수 있습니다. 다만 필요한 시점에 다시 계산하는 추가 연산이 발생하므로, 메모리를 아끼는 대신 연산량(시간)은 조금 늘어나는 trade-off가 있습니다. 이 방식은 흔히 “activation checkpointing”이라고 부르며, 여러 딥러닝 프레임워크에서 관련 기능을 지원합니다.
용어 정리: 같은 기법이 문서마다 다른 이름으로 불립니다. 저장했다가 재계산하는 대상이 gradient가 아니라 중간 activation이므로, 최근 문서나 논문에서는 Activation Checkpointing 또는 Activation Recomputation이라는 표현이 더 정확한 이름으로 쓰입니다. 프레임워크별 명칭은 다음과 같이 대응됩니다:
- Hugging Face Transformers: 역사적인 이유로 Gradient Checkpointing이라는 이름을 사용합니다 —
model.gradient_checkpointing_enable() - PyTorch:
torch.utils.checkpoint.checkpoint(...)를 activation checkpointing으로 설명합니다
AOTAutograd의 joint graph에는 “forward에서 만들어진 어떤 텐서가 backward의 어떤 입력으로 연결되는가”가 모두 남아 있습니다. 그래서 Min-Cut partitioner가 어느 텐서를 저장하고 어느 텐서를 재계산할지 전체 그래프를 보고 정할 수 있습니다. 다만 partitioner가 스스로 재계산 대상으로 삼는 것은 pointwise 같은 값싼 op에 한정되며(mm, convolution 같은 무거운 op은 제외), torch.utils.checkpoint로 사용자가 지정한 구간은 그 지시(MUST_SAVE/MUST_RECOMPUTE 태그)를 그대로 따릅니다.
[I 단계] Compiled forward/backward의 Autograd 연결
I 단계는 G 단계에서 분리하고 H 단계에서 컴파일한 forward/backward를 하나의 torch.autograd.Function 객체로 묶어 반환합니다. 최종 결과물은 compiled forward()와 compiled backward()가 한 객체 안에 나란히 들어 있는 형태가 됩니다. 아래는 그 형태를 이해하기 위한 공식 문서의 hand-written 예제입니다 (AOTAutograd의 실제 출력물은 앞서 본 partition된 forward/backward 예시를 참고하세요):
class MyCube(torch.autograd.Function):
    @staticmethod
    def forward(x):
        result = x ** 3
        # In regular PyTorch, if we had just run y = x ** 3, then the backward
        # pass computes dx = 3 * x ** 2. In this autograd.Function, we've done
        # that computation here in the forward pass instead.
        dx = 3 * x ** 2
        return result, dx

    @staticmethod
    def setup_context(ctx, inputs, output):
        x, = inputs
        result, dx = output
        ctx.save_for_backward(x, dx)

    @staticmethod
    def backward(ctx, grad_output, grad_dx):
        x, dx = ctx.saved_tensors
        # In order for the autograd.Function to work with higher-order
        # gradients, we must add the gradient contribution of `dx`.
        result = grad_output * dx + grad_dx * 6 * x
        return result
이 예제에서 forward가 backward에 쓸 dx = 3 * x ** 2를 미리 계산해 넘기는 구조는, 앞 절에서 partitioner가 ge_scalar를 forward 쪽으로 옮긴 것(“Partitioner moved backward compute to forwards!”)과 같은 형태입니다. backward의 grad_dx * 6 * x 항은 이 구조에서 고차 미분까지 맞추기 위한 것이라 첫 읽기에서는 건너뛰어도 됩니다.
torch.autograd.Function은 “PyTorch 1.0: Autograd” 절의 세 번째 특징으로 본 custom differentiable function입니다. AOTAutograd는 custom op에 미분 규칙을 붙이는 이 기존 장치를 그대로 씁니다.
Runtime wrapper는 compiled forward의 output에 compiled backward로 연결되는 autograd node를 등록합니다. 따라서 eager Autograd engine은 loss의 backward graph를 순회하다가 이 node에서 compiled backward를 호출할 수 있습니다.
Eager mode에서 보면 Dynamo가 캡처한 FX Graph는 하나의 큰 custom Op이고, 여기에 붙일 미분 함수가 필요합니다. 수많은 op을 포함한 graph의 미분 함수는 손으로 쓰기 어려우므로 AOTAutograd가 graph 내부 operator의 미분 규칙으로 backward graph를 자동 생성합니다.
torch.autograd.Function이 통합하는 두 가지 개념 (PyTorch 공식 문서):
PyTorch combines the following two concepts into
torch.autograd.Function:
- You wish to call code that does not contain PyTorch operations and have it work with function transforms. That is, the
torch.autograd.Function’sforward/backward/etc calls into functions from other systems like C++, CUDA, numpy.- You wish to specify custom gradient rules, like JAX’s
custom_vjp/custom_jvp.
AOTAutograd의 출력은 이 중 두 번째(custom gradient rules)에 해당합니다. 캡처된 코드 덩어리에 compiled backward를 custom gradient rule로 등록하므로 Autograd engine은 이 덩어리를 기본 op처럼 미분합니다.
학습 루프에서 compiled Function이 호출되는 순서
AOTAutograd가 만든 torch.autograd.Function은 학습 루프에서 다음 세 단계로 호출됩니다.
[1] Compile된 forward() 호출
사용자가 compiled model을 호출하면 torch.autograd.Function의 forward() 부분이 실제로 실행됩니다. 이 forward 코드는 등록된 backend가 이미 컴파일해 둔 상태이므로 가속된 형태로 동작합니다.
backend가 forward를 미리 컴파일
[2] Compile된 backward()가 output tensor의 grad function으로 등록
Forward가 실행되는 동안, 함께 묶여 있던 compiled backward()는 곧바로 실행되지는 않고 output tensor의 grad_fn으로 등록됩니다. 이 시점에는 backend lowering이 아직 수행되지 않은 상태입니다.5
[3] loss.backward() 수행 과정에서 compiled backward() 실행
이후 loss 쪽에서 backward()가 호출되면 Autograd engine이 등록된 grad_fn을 따라 내려오다가 [2]에서 걸어 둔 backward에 도달하고, 이때 한 스텝으로 backward 함수가 실행됩니다. 이 시점에 (아직 lowering되지 않았다면) 등록된 backend가 backward 그래프를 lowering한 뒤 실행하므로, 이후로는 가속된 형태로 동작합니다.
backend lowering은 첫 backward() 호출 때
Forward는 즉시, backward는 늦어도 첫 backward() 호출 때 backend compiler로 최적화됩니다. 사용자의 학습 루프는 거의 바뀌지 않습니다.
다만 compiled backward는 eager와 semantics가 완전히 동일하지는 않습니다. autocast 등 backward 시점의 context는 forward 컴파일 시점의 가정으로 고정되며, torch._functorch.config.backward_pass_autocast(기본값 "same_as_forward")로 이 동작을 제어합니다. 가정이 실제 실행 시점의 context와 어긋나면 조용한 수치 오류(silent incorrectness)가 발생할 수 있습니다. 자세한 내용은 PyTorch 2.14 공식 문서를 참고하세요.
Q&A
강연 말미에 오간 Q&A를 정리했습니다. 본문에서 다루지 못한 세부 의도나 한계가 담겨 있습니다.
Q1. [B 단계] inner_fn의 outs와 backward_out은 각각 무엇인가요?
A. outs는 forward를 수행했을 때 나오는 output, 일반적으로 input이 들어왔을 때 나가는 그 output입니다. 반면 backward_out은 backward의 결과물, 즉 weight들의 gradient에 해당합니다.
Q2. 앞 설명에서 B 단계는 joint graph를 만드는 부분이라고 했는데, 코드를 보면 forward와 backward가 분리돼 있는 것처럼 보입니다.
A. 여기서 B 단계는 joint graph 자체를 만드는 것이 아니라, “trace의 입력이 될 함수”를 먼저 준비해 두는 단계입니다. forward와 backward를 붙인 inner_fn이 그 함수이고, 이 함수의 input은 원래 모델의 input + loss로부터 흘러 들어오는 gradient(grad_outs)이며, output은 forward 결과 + weight들의 gradient입니다. 이 함수를 D 단계에서 한 번 trace하면 forward/backward가 모두 연결된 joint graph가 만들어집니다.
Q3. Joint Graph 생성 슬라이드에서, forward를 수행하면서 backward가 되는데 outputs가 또 하나의 input으로 다시 들어가는 건가요?
A. 혼동이 생길 수 있는데, training loop 다이어그램을 떠올리면 이해가 쉽습니다. 실제 forward 흐름(training data input → 모델 → output → loss function → gradient)에서, loss function은 joint graph 바깥에 남아 있고, 그 loss로부터 내려오는 gradient가 backward의 시작점이 됩니다. 따라서 joint graph의 관점에서:
- Input: ① 원래 모델의 input (forward를 시작시키는 값), ② loss function으로부터 흘러 들어오는 gradient (
grad_outs, joint graph에서는tangents_*) - Output: ① 원래 모델의 forward output (바깥에서 loss를 계산하는 데 필요), ② 다음 iteration에서 optimizer가 보정해야 할 weight들의 gradient
슬라이드의 joint_fw_bw에서 fw_inputs가 ①의 input, grad_outs가 ②의 input에 해당하고, fw_out과 grad_inps가 각각의 output에 해당합니다.
Q4. 모델뿐 아니라 loss 계산과 optimizer까지 포함해서 한꺼번에 trace하고 최적화하는 방법도 가능할까요?
A. 좋은 질문입니다. 개념적으로는 “What happens when training with torch.compile()?” 절에서 봤던 전체 학습 루프(왼쪽 코드)를 통째로 하나의 함수로 정의한 뒤 compile하면 되겠지만, 현실적으로는 난점이 있습니다. Loss 계산이나 optimizer 쪽 코드에서 graph break가 발생할 가능성이 커서 하나의 trace로 깔끔하게 묶기 어렵기 때문입니다. 표준 torch.compile 경로에서는 AOTAutograd가 backward를 forward 컴파일 시점에 부분적으로만 캡처하기 때문에, forward의 graph break가 그대로 backward의 graph break로 전파되는 한계도 있습니다. 이를 보완하기 위해 PyTorch 2.4에 Compiled Autograd가 도입되었습니다(torch._dynamo.config.compiled_autograd = True로 활성화). 아직 개발 중인 기능이라 모든 PyTorch 기능과 호환되지는 않습니다. Compiled Autograd는 AOTAutograd처럼 forward trace에 얹혀가는 대신 autograd engine 자체에 직접 통합되어, backward가 실제로 실행되는 시점에 전체 backward graph를 캡처합니다. 다만 backward 시작 시 cache lookup 오버헤드가 있고 recompile에 더 취약하다는 트레이드오프가 있습니다. 또한 loss 계산 자체가 전체 training 시간에서 차지하는 비중이 크지 않기 때문에, “다 합쳐 하나로 trace하면 얼마나 더 빨라질지”는 해봐야 알 수 있는 부분이라고 생각합니다.
Q5. torch.compile 과정에서 Dynamo가 fake tensor로 FX graph만 만들어내는 것인지, 아니면 실제 하드웨어에서 돌아갈 코드까지 생성하는 것인지 헷갈립니다.
A. Dynamo가 하는 일은 FX graph 캡처까지이고, 하드웨어 코드 생성은 그 뒤에 붙는 backend compiler가 맡습니다. Dynamo에 어떤 backend(예: Inductor, TensorRT 등)를 붙이느냐에 따라 결과가 달라지며, backend가 연결되어 있으면 캡처된 FX graph가 그 backend의 input으로 전달되어 실제 하드웨어에서 실행 가능한 코드까지 생성됩니다. 사용자에게 돌아오는 것은 원래 대상을 감싼 wrapper로, nn.Module을 넣었으면 OptimizedModule(역시 nn.Module), 함수를 넣었으면 함수 wrapper입니다. 이를 실행하면 내부에서 적절한 하드웨어로 dispatch되어 실제 연산이 수행됩니다.
Appendix: Grad Function Codegen 재현 방법
본문 “[참고] Grad Functions” 섹션에 등장한 AddBackward0, MulBackward0 등의 C++ 코드는 PyTorch 소스 트리에 커밋되어 있지 않고, 빌드 과정에서 tools/autograd/의 codegen 스크립트가 derivatives.yaml을 읽어 생성합니다. 본 강의 자료는 PyTorch v2.14.0을 기준으로 codegen만 별도로 재현해서 결과물을 인용했으며, 재현 방법은 다음과 같습니다.
1. 환경 준비
PyTorch 2.14.0은 Python 3.10 이상을 요구하며, 이 자료는 Python 3.14 가상환경으로 재현했습니다. 전체 PyTorch 빌드는 필요 없고 codegen만 돌리면 되므로 의존성도 pyyaml, typing_extensions 두 개면 충분합니다.
mkdir -p /tmp/pytorch-codegen-214
cd /tmp/pytorch-codegen-214

# v2.14.0 태그만 shallow clone (전체 히스토리 불필요)
git clone --branch v2.14.0 --depth 1 https://github.com/pytorch/pytorch.git

# uv로 Python 3.14 venv 생성 후 최소 의존성만 설치
uv venv --python 3.14 .venv
source .venv/bin/activate
uv pip install pyyaml typing_extensions
2. Codegen 실행
tools/autograd/gen_autograd.py는 다음 네 가지 인자를 받습니다:
native_functions.yaml경로 - 네이티브 op 목록tags.yaml경로 - op에 붙는 태그 목록- 출력 디렉토리
- autograd 디렉토리(
derivatives.yaml, 템플릿 위치)
cd /tmp/pytorch-codegen-214/pytorch
mkdir -p /tmp/pytorch-codegen-214/generated

PYTHONPATH=. python -m tools.autograd.gen_autograd \
  aten/src/ATen/native/native_functions.yaml \
  aten/src/ATen/native/tags.yaml \
  /tmp/pytorch-codegen-214/generated \
  tools/autograd
정상 종료되면 /tmp/pytorch-codegen-214/generated/ 아래에 다음 파일들이 생성됩니다:
ADInplaceOrViewType_{0,1}.cpp       # inplace/view op dispatch
ADInplaceOrViewTypeEverything.cpp
Functions.h                         # AddBackward0, MulBackward0, ... struct 선언
Functions.cpp                       # 각 backward의 apply() 구현
TraceType_{0..9}.cpp                # JIT tracer용 kernel
TraceTypeEverything.cpp
VariableType.h
VariableType_{0..9}.cpp             # Autograd dispatch key kernel (forward hook)
VariableTypeEverything.cpp
ViewFuncs.h / ViewFuncs.cpp         # view op의 역함수 정보
variable_factories.h(*Everything.cpp는 shard를 하나로 합친 버전이라 실제 빌드에는 shard만 쓰입니다.)
본 강의에서 인용한 코드는 이 중 Functions.h와 Functions.cpp입니다.
3. 관심 있는 backward 클래스 찾기
전체 파일이 수천 라인이므로 class/함수명으로 찾는 것이 편합니다.
# 헤더에서 struct 선언 위치 (Windows용 #ifdef 분기가 있어 두 줄이 잡힘)
grep -n "struct.*AddBackward0 " \
  /tmp/pytorch-codegen-214/generated/Functions.h

# 구현부에서 미분식이 들어 있는 함수와 apply() 위치
grep -n "^static variable_list AddBackward0_apply_functional\|^variable_list AddBackward0::apply" \
  /tmp/pytorch-codegen-214/generated/Functions.cpp
4. YAML ↔ 생성 코드 대응관계 확인
derivatives.yaml의 원본 항목과 codegen 결과를 같이 읽으면 어떤 식이 어디로 박히는지 확인할 수 있습니다.
# derivatives.yaml 원본
grep -n -A 3 "^- name: add\.Tensor" \
  /tmp/pytorch-codegen-214/pytorch/tools/autograd/derivatives.yaml

# 생성된 미분 함수 본문 (v2.14.0 기준 200행부터)
sed -n '200,219p' /tmp/pytorch-codegen-214/generated/Functions.cpp
self: / other: 항목에 적힌 표현식(handle_r_to_c(...), mul_tensor_backward(...) 등)이 apply() 내부의 grad_result = any_grad_defined ? (...) : Tensor(); 위치에 그대로 치환되는 것을 눈으로 확인할 수 있습니다.
5. 다른 PyTorch 버전으로 재현하고 싶을 때
동일한 절차를 다른 태그(예: v2.13.0)로 바꿔 실행하면 됩니다. 단, 주의점은 다음과 같습니다.
- PyTorch 2.14의 소스 빌드와 codegen은 Python 3.10 이상이 필요합니다. 1.x 계열은 반대로 3.10 이하만 지원하므로 오래된 태그를 볼 때는 venv의 Python 버전을 맞춰야 합니다.
gen_autograd.py의 인자 구성이 바뀌기도 하니 해당 버전의 파일 상단 docstring을 먼저 읽는 편이 안전합니다.- codegen은 Autograd 쪽 뿐 아니라
torchgen/gen.py(ATen 전체)도 있으며, 이쪽 결과물(예:RegisterCPU.cpp,RegisterCompositeImplicitAutograd.cpp)을 보면 dispatch 테이블이 어떻게 구성되는지 확인할 수 있습니다.
Footnotes
-
Autograd 자체는 PyTorch 0.1부터 있던 기능입니다. 이 강의에서 “1.0의 Autograd”는 eager mode 시대의 미분 엔진이라는 뜻으로, 2.0의 AOTAutograd와 대비해 부르는 이름입니다. ↩
-
PyTorch 2.0의 graph capture 프론트엔드.
torch.compile()이 적용된 함수가 호출되면 CPython의 frame 실행에 개입하여 Python bytecode를 분석하고, tensor 연산들을 FX Graph로 수집합니다. 자세한 동작 원리는 Week 3에서 다뤘습니다. ↩ -
torch.fx모듈이 제공하는 그래프 형태의 IR(intermediate representation). Tensor 연산 하나하나를 node로, 연산 간의 입출력 관계를 edge로 표현한 자료구조로, Dynamo가 캡처한 trace가 이 형태로 저장되어 이후 컴파일 단계에 전달됩니다 (Week 3 참고). ↩ -
AOTAutograd가 forward와 backward를 합쳐 만든 joint graph를 다시 forward/backward 두 개의 그래프로 잘라내는 컴포넌트. 어느 중간 값을 저장(save)하고 어느 것을 재계산(recompute)할지를 Min-Cut 계열 알고리즘으로 결정합니다. 뒤의 “[G 단계] Min-Cut Algorithm으로 Forward/Backward 분리” 절에서 자세히 다룹니다. ↩
-
Backward lowering의 지연(lazy)은 AOTAutograd 도입(2.0)부터의 기본 동작입니다. 2.1부터는 backward에 SymInt 같은 dynamic shape 정보가 들어가는 경우 forward 컴파일 시점에 즉시 lowering하는 예외가 생겼고, 2.8에서는 이 규칙이 “Backward graph lazy lowering” Note로 정식화되면서 lowering이
bw_module의 deepcopy 위에서 수행되도록 바뀌었습니다. ↩ ↩2 ↩3 ↩4 -
공식 문서 일부(예:
torch.compiler_backward)는 이 컴포넌트를 AOTDispatcher라고 부르며 “sometimes known as AOTAutograd”라고 병기합니다. 문서 대부분과 소스 코드는 AOTAutograd를 쓰므로 이 강의에서도 이 이름을 사용합니다. ↩