Week 3: PyTorch Graph Mode
PyTorch + NPU 온라인 모임 #3 | 2024-12-18
오늘 다룰 주제들
이번 강의는 “graph mode는 왜, 그리고 어떻게 필요해졌는가”라는 질문에서 출발해, tracing의 배경 개념에서 PyTorch 2.x의 compilation pipeline까지 따라갑니다.
- PyTorch의 역사와 2.0의 변화 - eager mode 중심이던 PyTorch에 graph mode가 더해지기까지의 배경, 그리고 2.0 전체 아키텍처에서 이번 강의가 다루는 범위
- Graph capturing - graph mode의 근간이 되는 tracing
- Tracing 개념과 관련 사례 - trace cache, partial evaluation, 그리고 동적 최적화와의 비교
- PyTorch 1.0의 시도와 한계 -
jit.trace(입력 의존성 검증 부재),jit.script(Python subset 처리 범위의 한계) - PyTorch 2.0의 해법 TorchDynamo - 이번 강의의 중심. CPython bytecode를 분석해 FX graph를 capture하고, guard로 입력 조건을 검증하며, graph break에서 graph를 나눔
- IR lowering - 컴파일러 구조에 가까워진 2.0에서 정립된 IR 개념과, Dynamo가 만든 FxGraph가 Torch IR → Aten IR → Inductor Loop-Level IR로 낮아지는 과정
- Device backend 통합 -
torch.compile컴파일 파이프라인에 사용자 정의 device backend를 연결하는 방법
PyTorch의 역사와 2.0의 변화
PyTorch 2.0의 큰 변화 중 하나는 torch.compile을 중심으로 한 graph capture와 compilation stack입니다. 그 배경으로 PyTorch 1.x의 eager execution과 TorchScript부터 살펴봅니다.
Lua Torch 시대
PyTorch는 Torch에서 출발했습니다. Torch는 C/C++ 라이브러리였고, 이를 편하게 쓰려고 스크립트 언어를 올렸습니다. 처음 고른 언어가 Lua였고, 이 조합을 Lua Torch라고 부릅니다.
PyTorch의 탄생
Lua보다 Python이 훨씬 더 인기 있는 언어였기 때문에, Meta(당시 Facebook)에서 Python 기반의 PyTorch 프로젝트를 시작했습니다. 당시에는 TensorFlow가 대세였고, PyTorch는 지금처럼 큰 프로젝트가 될 것이라 기대하지 않았습니다. 연구자들이 TensorFlow의 복잡한 사용성에 어려움을 겪고 있었기 때문에, 그 문제를 해결하고자 eager mode1 철학을 중심으로 개발을 시작했습니다.
이 접근 방식은 특히 연구 커뮤니티에서 호응을 얻어 PyTorch가 빠르게 성장하는 계기가 되었습니다. 다만 이 시기의 PyTorch는 주로 연구자들이 사용하는 도구였으며, production 환경에서 사용하기에는 부족한 점이 있었습니다:
- Python runtime 의존: Eager mode는 모델 실행이 Python 코드 자체에 묶여 있어, 배포 시 Python interpreter까지 함께 가져가야 합니다. Python이 없는 C++ 서버나 모바일 환경으로 모델을 내보내기 어렵고, interpreter 오버헤드와 GIL 때문에 고성능 serving에도 불리합니다.
- Graph 수준 최적화 불가: 연산이 한 줄씩 즉시 실행되므로 전체 계산 흐름(graph)이 실행 전에 드러나지 않고, kernel fusion 같은 graph 수준의 최적화를 적용할 수 없습니다.
PyTorch 1.0: Production 지원
PyTorch의 인기가 높아지면서, production 환경에서도 사용할 수 있는 형태로 발전할 필요가 생겼습니다. PyTorch 1.0에서는 TorchScript2 (jit.trace, jit.script)가 추가되어 graph capture가 도입되었습니다.
PyTorch 2.0: torch.compile 도입
PyTorch 2.0에서 1.0 대비 가장 크게 바뀐 부분은 graph mode입니다. 전체 구조는 frontend → backend → codegen backend로, 일반적인 컴파일러 아키텍처와 비슷합니다. 다만 다음이 다릅니다:
- Dynamo: graph를 capture하는 새 모듈이 frontend에 추가
- AOTAutograd: 머신러닝 컴파일러이므로 자동 미분이 frontend에 포함되어, backend에 넘기기 전에 backward graph까지 만들어 둠
- Inductor 및 다양한 backend 지원: 대표 backend는 Inductor3이며, 그 아래에 Triton4 등의 codegen backend가 연결
이 시기에 PyTorch가 Linux Foundation에 기부되며 PyTorch Foundation이 설립되었습니다.
PyTorch 2.0 이후로 eager mode의 유연성과 graph mode의 컴파일러 최적화를 결합한 형태로 발전하면서, 연구뿐만 아니라 production에서도 널리 쓰이게 되었습니다.
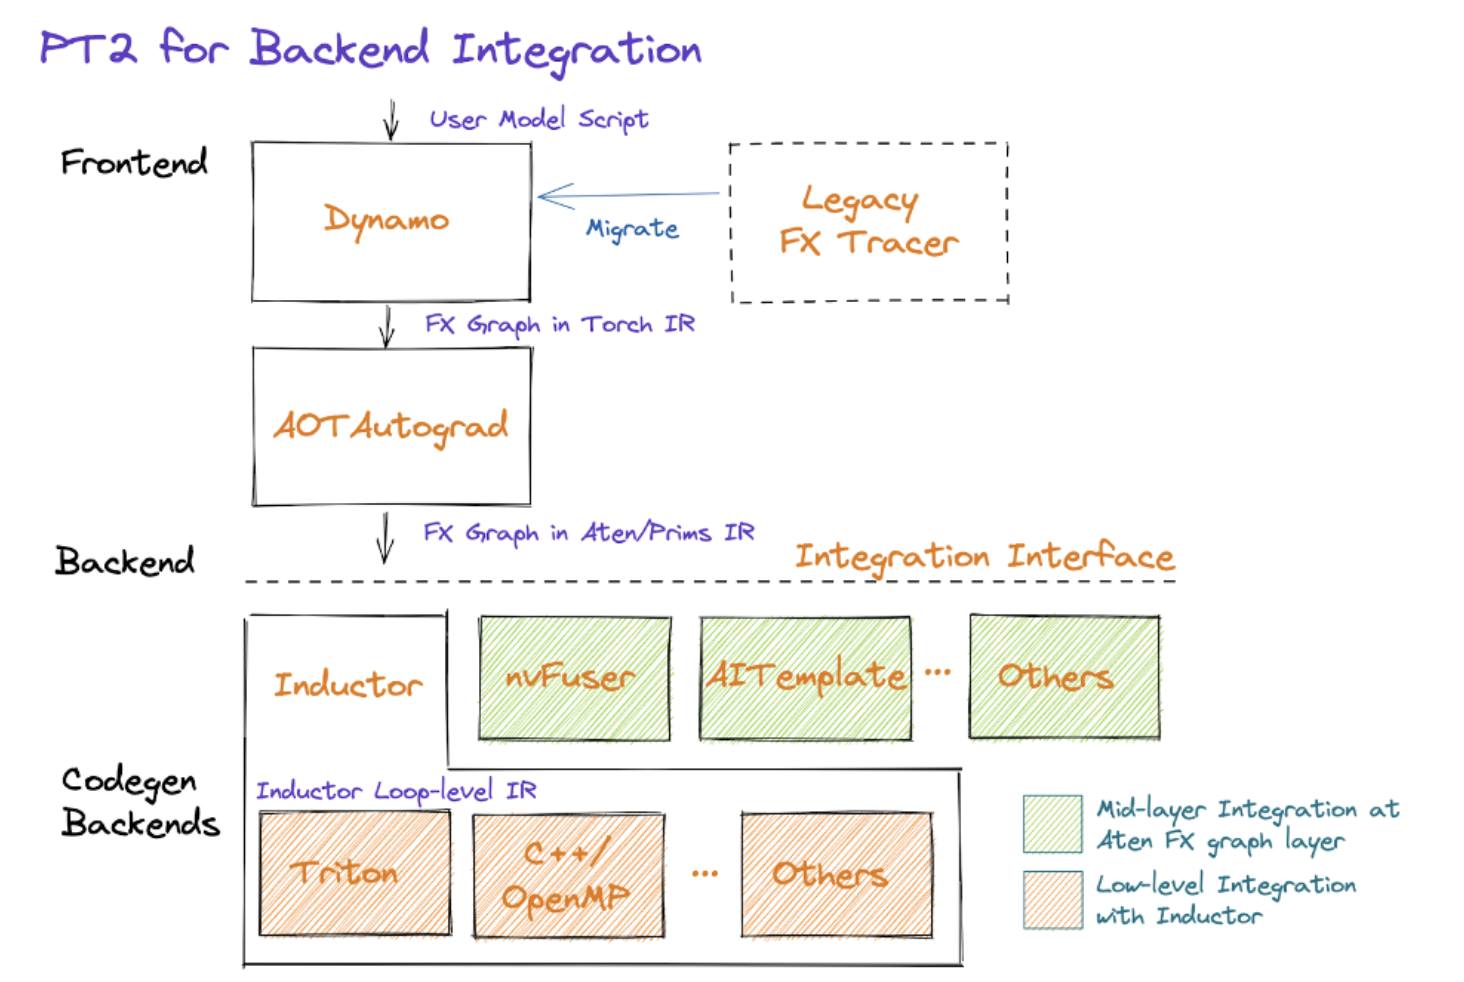
https://pytorch.org/get-started/pytorch-2.0/
이번 강의의 범위
위 그림에서 보이는 PyTorch 2.0의 전체 아키텍처 중, 다음 내용은 이번 강의에서 다루지 않습니다:
- Legacy FX Tracer - 레거시 기능이므로 생략
- AOTAutograd - 다음 주(Week #4)에서 다루는 것이 더 적절
- Codegen backends - NVIDIA GPU 관련 이야기를 할 때 함께 다루는 것이 더 적절
이번 강의는 나머지 부분인 tracing 개념, Dynamo 중심의 graph capturing, IR lowering, device backend 통합을 다룹니다. 시간 대부분은 Dynamo의 동작 원리에 씁니다.
Graph Capturing
Graph capture를 세 단계로 살펴봅니다. 먼저 tracing과 고전적 최적화 기법을 설명하고, PyTorch 1.x의 jit.trace·jit.script가 가진 한계를 검토한 뒤, PyTorch 2.0이 선택한 해법인 TorchDynamo의 bytecode analysis와 guard 동작을 설명합니다.
Tracing과 고전적 최적화 기법
Tracing은 프로그램을 실제로 실행하면서, 어떤 코드가 어떤 순서로 실행되었는지를 기록하는 기법입니다. 그 바탕이 되는 Control Flow Graph(CFG)와 Trace의 개념부터 정리하겠습니다.
소스 코드 (Pseudo Code)
일반적인 C 프로그램과 비슷한 형태의 pseudo code입니다. 변수의 조건에 따라 특정 부분이 실행되거나 실행되지 않을 수 있는 구조입니다.
L1:  input(a, b, c);
L2:  d ← b * b - 4 * a * c;
L3:  if (d > 0) then
L4:    r ← 2
L5:  else_if (d = 0) then
L6:    r ← 1
L7:  else_if (d < 0) then
L8:    r ← 0;
L9:  output(r);
Control Flow Graph (CFG)
위 소스 코드를 그래프 형태로 표현한 것이 control flow graph (CFG) 입니다.
- 노드(Node): 분기점이 없는 연속적인 코드 블록(시퀀스)입니다. 한 노드 내의 코드는 순차적으로 실행됨이 보장됩니다. 이 예제에서도 분기 없이 이어지는 L1-2를 한 노드로 묶었고, 실제 컴파일러에서는 이렇게 여러 instruction의 시퀀스가 하나의 노드를 이룹니다.
- 엣지(Edge): 노드 간의 연결로, 프로그램의 실행 흐름(branch, jump)을 나타냅니다. 한 블록에서 다른 블록으로 이동 가능한 모든 경로가 화살표로 표시됩니다.
Trace
프로그램을 실제로 실행했을 때, CFG 상에서 어떤 노드들을 거쳤는지를 순서대로 기록한 것이 Trace입니다. Trace는 결과적으로 linear list 형태가 됩니다. 반복문이 있으면 동일한 노드가 여러 번 나타날 수 있지만, 여전히 linear list로 기록됩니다.
예를 들어 d = 0일 때의 Trace는 다음과 같습니다:
이때 프로그램과 입력을 받아 종료될 때까지 실행하면서 trace만 만들어내는 가상의 실행 엔진을 생각해 볼 수 있습니다.
Tracing의 특징과 한계


이론적으로 프로그램 전체를 trace로 만들 수 있지만, 두 가지 한계가 있습니다:
- 전체 Trace 생성은 비효율적: 1GHz CPU는 1초에 10억 clock cycle을 수행하고, superscalar CPU는 한 cycle에 여러 instruction을 처리할 수도 있습니다. 이를 모두 기록하면 일반적인 프로그램에서는 매우 긴 trace가 생성되고 기록 자체의 overhead도 발생합니다. 머신러닝처럼 동일한 연산 구조를 반복하는 프로그램은 상대적으로 graph capture에 유리할 수 있습니다.
- Trace는 입력 의존적: 같은 프로그램이라도 입력이 다르면 trace가 달라지므로, 하나의 trace만으로 모든 실행을 일반화할 수 없습니다.
Trace 기반 최적화
그래도 trace를 잘 추출하면 여러 최적화에 쓸 수 있습니다. 기본 아이디어는 다음과 같습니다:
- 반복 수행되는 구간을 찾아 trace로 추출하고, 최적화를 적용
- 프로그램 실행 중 해당 trace에 진입했다고 판단되면, 실제 코드 대신 미리 최적화된 trace를 불러와 실행
- 만약 trace misprediction이 발생하면 trace에서 빠져나와 상황을 복구
Out-of-Order Execution과 동적 최적화
Super-scalar processor의 Out-of-Order Execution은 instruction window 안에서 dependency가 해결된 instruction을 동적으로 선택해 Instruction-Level Parallelism(ILP) 을 높입니다. Hot path를 기록해 재사용하는 tracing JIT와는 다른 기법입니다. 다만 runtime에 관찰한 결과와 추측으로 실행 순서를 최적화한다는 점에서 비교해 볼 수 있습니다.
일반적인 프로그램에는 branch가 잦습니다(대략 instruction 대여섯 개마다 하나꼴로 알려져 있으나 workload에 따라 다릅니다). Branch가 어느 방향으로 뛸지 모르면 그 뒤의 instruction을 미리 스케줄링하기 어렵습니다. 그러면 branch 사이의 5~6개 instruction 안에서만 ILP를 찾아야 하므로 효율이 낮아집니다.
Processor는 Branch Prediction을 이용해 아직 결과가 확정되지 않은 branch 뒤의 instruction도 instruction window에 공급합니다:
- Branch predictor가 다음 instruction address를 예측
- 예측 경로의 instruction을 fetch하고 dependency가 해결된 instruction부터 실행
- Prediction이 틀리면 잘못 실행한 결과를 폐기하고 올바른 경로에서 다시 실행
TorchDynamo도 runtime 조건을 검사한 뒤 이전 compilation 결과를 재사용하지만, branch prediction이나 Reorder Buffer를 사용하지는 않습니다. Dynamo는 Python bytecode를 symbolic execution으로 분석하고, 입력 조건을 guard로 표현하며, tensor 연산을 FX graph로 생성합니다.
이 외에도 trace 기반 최적화의 대표적인 사례로 다음을 다룹니다:
- Trace cache: 반복 실행되는 경로(hot trace)를 따라 decoded micro-op sequence를 저장해 instruction fetch 및 decode 비용을 줄이는 하드웨어 구조
- Partial evaluation: 사전에 실행 가능한 계산을 미리 처리하여 연산을 제거. PyTorch 2.0의 Dynamo가 수행하는 최적화의 바탕이 되는 개념
- ML compiler의 graph mode: Trace로 실행할 연산자를 식별하고, trace에 partial evaluation을 적용해 Python 코드를 제거
Trace Cache (Pentium 4에 적용된 사례)
Trace Cache는 Instruction Cache와 Branch Prediction을 한 단계 더 최적화한 구조입니다. 분기가 결정되기 전에 instruction을 미리 fetch하려면 branch prediction이 필요합니다. 예측을 하더라도 점프가 많으면 Instruction Cache의 fetch 효율은 떨어집니다. Instruction cache는 한 번에 연속된 주소 한 덩어리만 읽으므로, 점프가 잦으면 그중 실제로 실행할 명령은 몇 개뿐이고 점프한 곳의 명령은 다음 fetch에서 따로 읽어야 합니다.
Trace Cache는 예측된 제어 흐름을 따라 decoded micro-op을 연속적으로 저장해 fetch와 decode를 최적화합니다. Pentium 4가 이를 상용 x86 processor에 적용한 대표 사례입니다. 아래 동작 방식과 장치 구성은 Rotenberg 등의 연구 구조를 따른 것이고, Pentium 4 구현에서는 trace cache miss 시 L2 cache에서 명령어를 가져와 decode하면서 새 trace를 채웁니다.


Trace Cache의 동작 방식은 다음과 같습니다:
- 반복되는 구간을 trace로 식별하고, 비연속적인 코드 블록들을 연속적인 메모리 블록으로 변환하여 저장
- Trace의 시작점이 수행될 때 저장된 trace를 한꺼번에 fetch
- Trace miss가 발생하면 trace에서 빠져나와 instruction cache에서 하나씩 fetch
이를 위해 세 가지 하드웨어 장치가 필요합니다:
- Trace Cache: 최적화된 Trace를 저장하는 저장소
- Trace Predictor: Branch predictor와 유사하게, 어떤 Trace가 실행될지 예측하여 선택
- Trace Buffer (outstanding trace buffers): 구성 중이거나 실행 중인 trace를 관리하는 버퍼. Trace cache miss 시 명령어를 모아 새 trace를 조립하며, cache hit 여부와 관계없이 실제 분기 결과를 추적하여 예측이 틀린 trace를 수정
아래 그림은 (a) 기존 Instruction Cache와 (b) Trace Cache의 구조적 차이를 비교하여 보여줍니다:
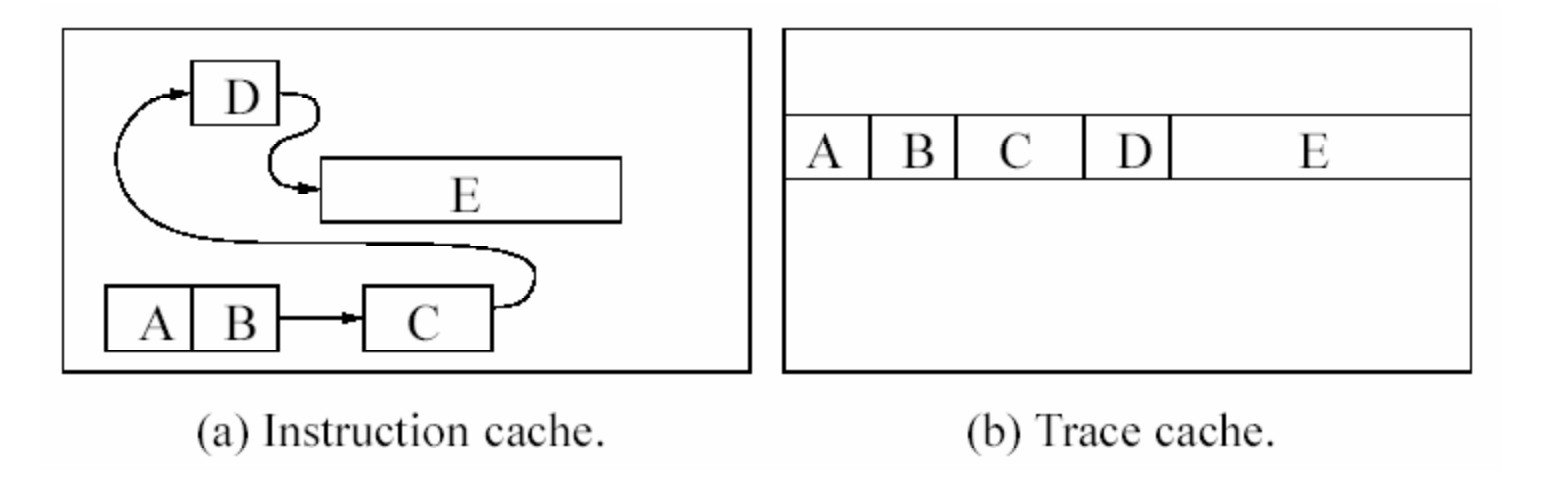
- (a) Instruction Cache: 블록 A, B → C → D → E가 메모리 상에 비연속적으로 배치되어 있어, 점프할 때마다 다른 위치에서 fetch해야 합니다. 한 번에 한 덩어리만 읽을 수 있으므로 블록마다 fetch를 반복하게 되어 효율이 떨어집니다.
- (b) Trace Cache: 동일한 블록들을 A, B, C, D, E 순서로 하나의 연속적인 trace로 묶어 저장합니다. 한 번에 fetch가 가능하여 성능이 향상됩니다.
이 세 장치가 연결되어 동작하는 흐름은 다음과 같습니다:
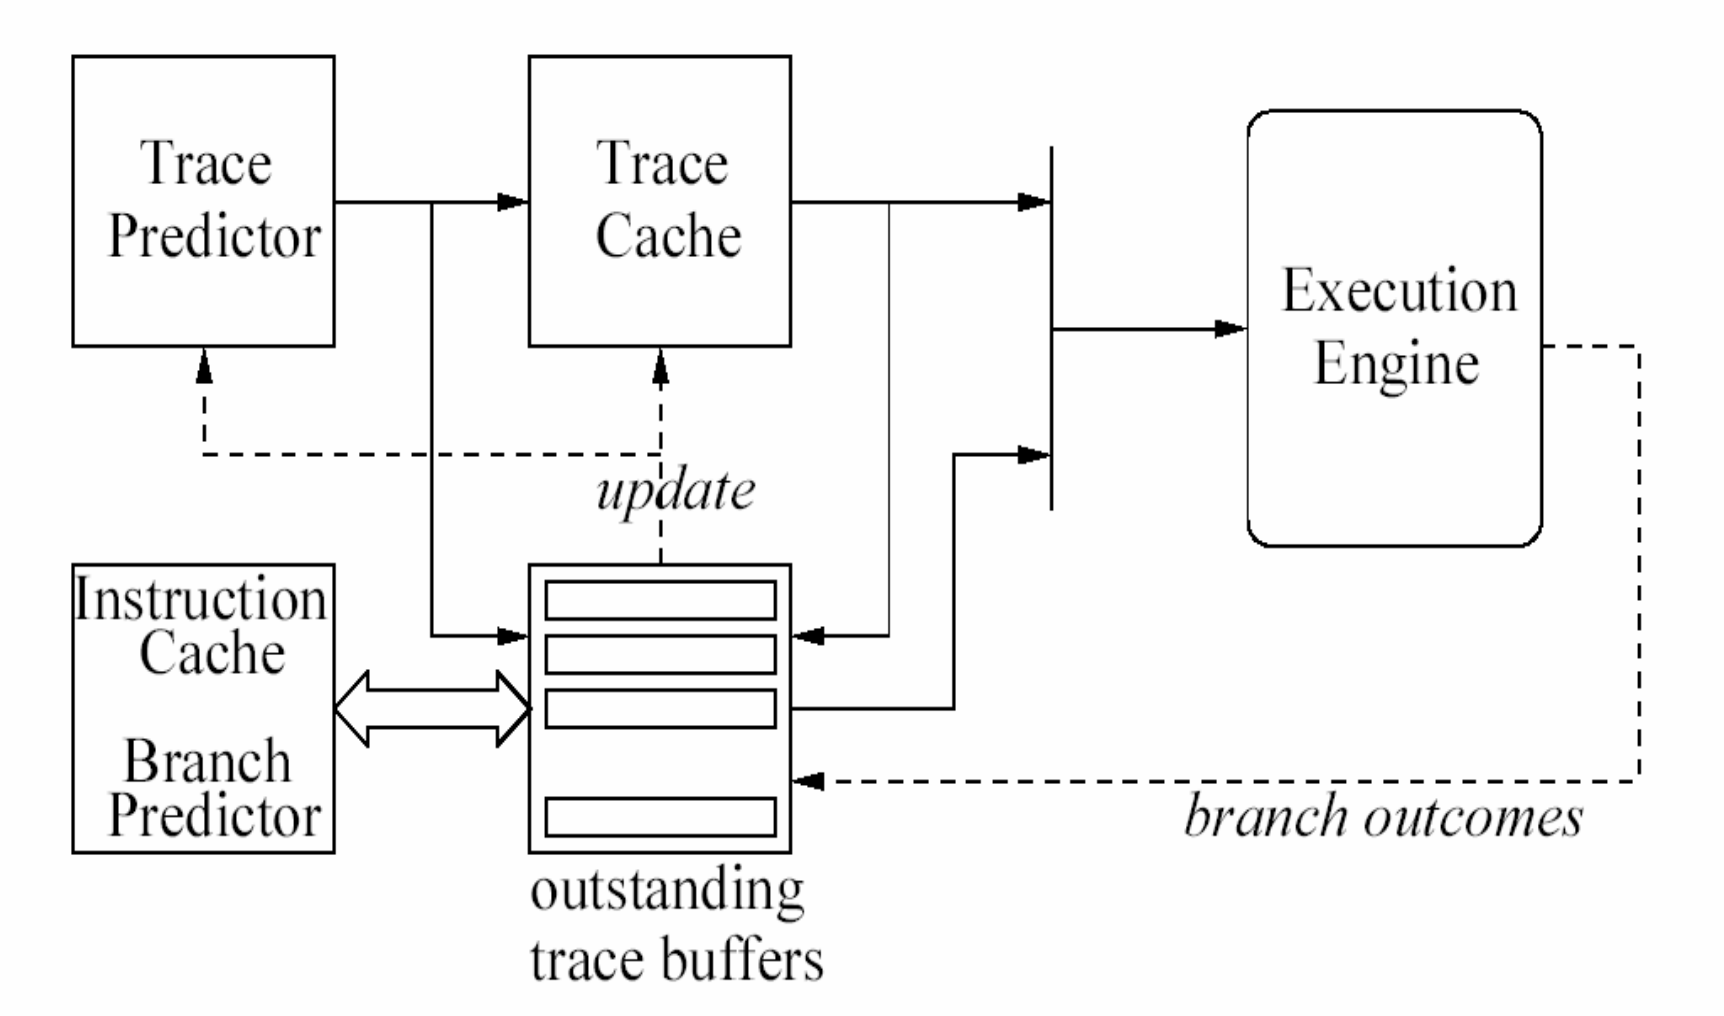
- Trace Predictor가 다음에 실행될 trace를 예측하여 Trace Cache에서 해당 trace를 fetch → Execution Engine에 전달
- Trace Cache에 원하는 trace가 없으면(trace miss), Instruction Cache + Branch Predictor를 통해 instruction을 하나씩 fetch하면서 새로운 trace 후보를 outstanding trace buffers에 수집
- Execution Engine의 branch 결과(branch outcomes)는 outstanding trace buffers로 돌아오고, 버퍼는 이를 예측과 대조해 오예측된 trace를 수정
- 새로 조립되거나 수정된 trace가 완성되면 버퍼가 Trace Cache와 Trace Predictor를 update
Trace Cache는 분기로 끊기던 fetch를 연속된 trace 단위로 바꿔 fetch 효율과 실행 성능을 높입니다.
Rotenberg, Eric, Steve Bennett, and James E. Smith. “A trace cache microarchitecture and evaluation.” IEEE Transactions on Computers 48.2 (1999): 111-120. https://ieeexplore.ieee.org/abstract/document/752652
Partial Evaluation
Partial evaluation은 프로그램을 최적화하는 기법으로, 입력을 두 종류로 구분합니다:
- Static Input: 변하지 않는 상수처럼 취급될 입력 (자주 사용되는 고정 값)
- Dynamic Input: 실행 시마다 변할 수 있는 입력
프로그램 p에 고정된 입력 in1(static input)을 주어 부분 평가(partial-evaluate)한 뒤, 동적 입력 in2(dynamic input)에 의해 영향을 받는 나머지 계산만 수행하는 특화된 프로그램(specialized program) 을 생성합니다. 이렇게 생성된 특화 프로그램은 원래 프로그램 p보다 더 빠르게 실행됩니다.
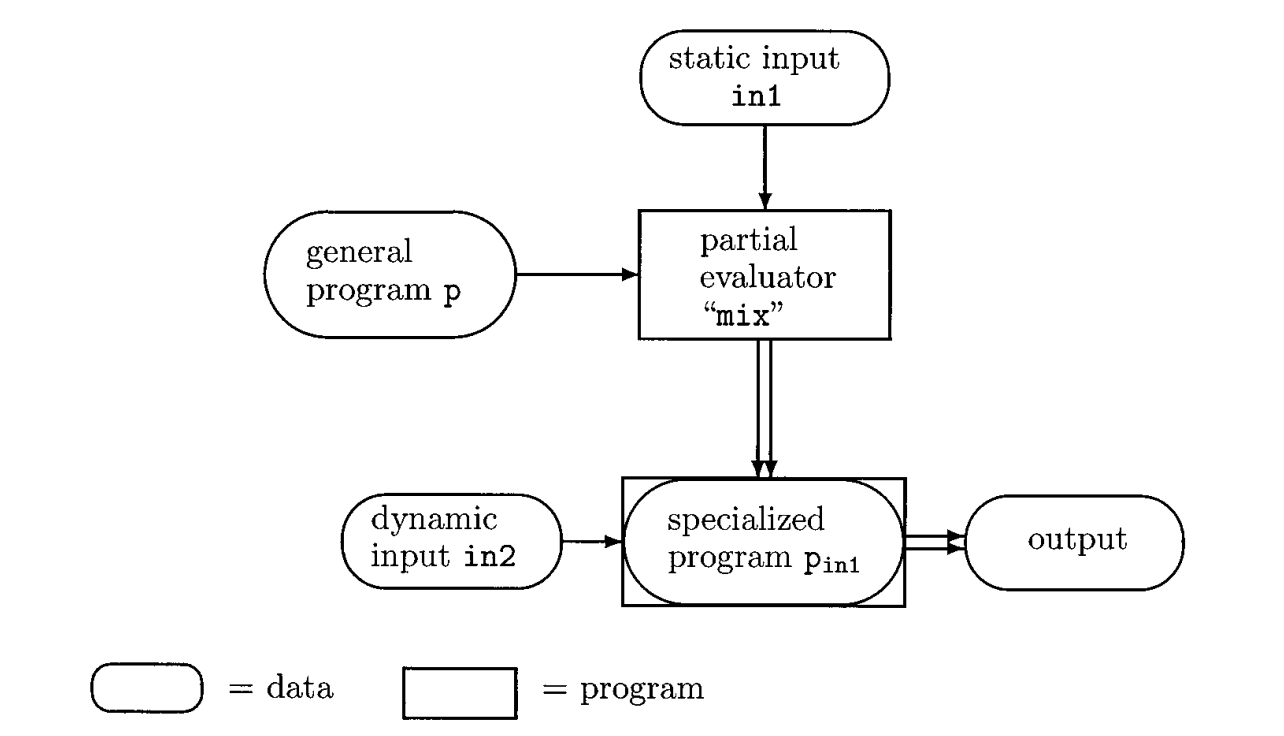
Jones, Neil D. “An introduction to partial evaluation.” ACM Computing Surveys (CSUR) 28.3 (1996): 480-503. https://dl.acm.org/doi/10.1145/243439.243447
예를 들어 x가 항상 고정된 static input이라면:
def compute(x, y):
    return (x + 10) * y

# x = 5가 항상 고정이라면, 미리 계산하여 최적화된 함수 생성
def optimized_compute(y):
    return 15 * y
Static input에만 의존하는 계산을 한 번 해 두면 호출할 때마다 반복하지 않아도 됩니다.


Partial Evaluation은 static input에만 의존하는 계산을 미리 평가하고, 그 결과를 상수로 반영한 나머지 계산만 남깁니다.
예를 들어 원래 Trace가 [A, A, B, C, D, D, E, E, E]이고 static input과 dynamic input이 모두 필요한 상태에서, static input에만 영향받는 부분을 한 번 계산해두면, 최적화된 Trace에서는 dynamic input만 필요하게 됩니다:
- ① Static input에만 의존하는 계산(주황 칸)은 다시 계산할 필요가 없음 - 결과가 특화 프로그램에 미리 반영됨
- ② 남은 trace에는 static 효과가 상수로 들어가 있음 -
15 * y의15처럼 static 값을 쓰는 연산은 남되, 계산은 한 번만 됨 - ③ Static input 자체는 더 이상 필요 없음 - 특화 프로그램은 dynamic input만 받음
모든 입력 집합이 {i1, i2, ..., in}이라면, 이를 static input과 dynamic input으로 나누는 과정이 필요합니다. 단, 임의로 나눌 수는 없고 실제 실행 중 바뀌지 않는 값만 static input으로 설정해야 효과적입니다. Static input이 바뀌면 최적화된 Trace도 달라져야 하므로 새로운 partial evaluation이 필요하고, 잘못된 static input을 적용하면 예상과 다른 결과가 나올 수 있습니다.
PyTorch 2.0과의 연관성: Dynamo는 Partial Evaluation과 유사한 방식으로 동작합니다. 변하지 않는 연산(Python 코드, tensor shape 등)을 미리 계산하여 최적화된 Graph를 생성하고, 변하는 부분(실제 tensor 데이터)만 실행 시 처리합니다.
ML 모델에서의 Tracing
Python으로 작성된 ML 모델에 tracing을 적용하면 여러 이점이 있습니다.
Device 실행 분리: Python으로 작성된 일반 코드는 GPU/NPU에서 직접 가속하기가 거의 불가능합니다. 그래서 device에서 실행할 부분을 따로 떼어내야 하고, tracing이 그 방법입니다. 정적 분석도 생각해 볼 수 있지만 너무 복잡해서 실용적이지 않습니다. Python 코드를 걷어내고 device 연산만 남긴다는 점에서 앞의 partial evaluation과 같은 발상입니다.
Tensor shape 판별: tracing 중에 연산에 필요한 tensor shape도 알아낼 수 있습니다. Shape 정보는 다음에 쓰입니다:
- NPU/GPU의 메모리 레이아웃 최적화에 필수적
- 계산 크기에 따른 스케줄링 결정에 중요
- 컴파일 시 메모리 사용량과 실제 계산 수행 방식을 예측 가능
Graph 최적화: 전체 계산 흐름이 드러나므로, Python 레벨에서는 어려운 graph 단위 최적화를 trace 레벨에서 할 수 있습니다. 대표적인 기법은 Op Fusion, Constant propagation, Common subexpression elimination입니다.
PyTorch 1.0의 시도와 한계
앞서 살펴본 것처럼, 프로그램 실행 전체를 그대로 trace로 기록하는 것은 비효율적이고, trace는 입력에 의존합니다. PyTorch는 이보다 더 효율적인 tracing 방식을 여러 차례 시도해 왔으며, 1.0과 2.0의 주요 기술을 차례로 따라가 보겠습니다.
| 버전 | 방식 | 핵심 접근 | 장점 | 단점 |
|---|---|---|---|---|
| 1.0 | jit.trace | Dispatcher에 trace collect kernel 부착 | 구현이 간단, 한때 실무에서 널리 사용 | 특정 입력에 의존, dynamic branch 미지원 |
| 1.0 | jit.script | Python subset을 AST에서 TorchScript IR로 컴파일 | 제어 흐름을 IR에 보존 | subset 외 코드 처리 불가, 포기하는 경우 빈번 |
| 2.0 | Dynamo | CPython의 frame evaluation hook(PEP 523)으로 bytecode 수준 tracing | capture 가능한 구간은 컴파일하고 나머지는 Python 실행과 연결, guard로 입력 의존성 검증 | graph break/재컴파일 및 guard 검사 오버헤드 |
jit.trace: Dispatcher를 활용한 간단한 Tracing
Eager Mode에서 배운 Dispatcher를 활용한 방식입니다. Dispatcher의 dispatch key에 따라 다른 kernel을 실행할 수 있다는 점을 이용하여, 실제 Op을 수행하는 대신 trace만 collect하는 kernel을 붙여놓은 것이 jit.trace입니다.
- 프로그램이 실행되면 Python 세계에서 일어난 모든 일은 무시
- Device에서 실행될 Op들만 모아서 trace를 생성
- Partial Evaluation 관점에서, tensor 값은 dynamic input이고 Python 제어 흐름(과 그 분기를 결정한 값)은 static input이라고 가정
jit.script: Python subset을 TorchScript IR로 컴파일
jit.trace의 한계를 보완하기 위해 도입된 기술입니다. Python 소스의 AST를 읽어 TorchScript IR로 컴파일하며, if·for 같은 제어 흐름을 IR에 그대로 보존합니다. 입력에 특화하지 않으므로 partial evaluation은 아니고, Python 전체가 아닌 subset만 컴파일할 수 있습니다. 하지만 “popular할 것 같은 subset”을 넘어가는 프로그램이 실제로는 매우 많아, 처리하지 못하고 포기하는 경우가 빈번했습니다.
실무에서는 오히려 jit.trace가 더 널리 사용되었습니다. 프로그래머가 코드를 작성할 때 static/dynamic input을 잘 구분하여 설계하면, jit.trace로도 안전하게 tracing할 수 있기 때문입니다.
TorchScript(
jit.trace,jit.script)는 PyTorch 2.10에서 deprecated되었으며, 현재는torch.compile과torch.export가 그 역할을 대체합니다. 아래 내용은 2.0 이전 시점의 접근 방식을 이해하기 위한 역사적 맥락으로 읽어주세요.
jit.trace의 한계
jit.trace는 “tensor 연산은 dynamic input, Python 제어 흐름은 static input”이라고 가정하고, 이 가정을 검증하지 않습니다.
아래 코드에서 dynamic input인 x의 평균값에 따라 if문의 분기가 달라집니다. cos().cos()의 값은 항상 [0.54, 1] 범위이므로, 예를 들어 x = zeros(평균 0.54)와 x = full(π/2)(평균 1.0)는 서로 다른 경로를 탑니다. 한쪽 입력으로 trace를 생성하면 다른 입력에서는 잘못된 경로를 실행하게 됩니다.
def function(inputs):
    x = inputs["x"]
    y = inputs["y"]
    x = x.cos().cos()
    if x.mean() > 0.8:
        x = x / 1.1
return x * y- Trace 안전성 없음: dynamic input(
x)의 값에 따라 조건문의 실행 경로가 달라지므로, 한 입력에서 생성한 trace를 다른 입력에 재사용할 수 없음 - 근본 원인:
jit.trace는 input이 static한지 dynamic한지를 분석하지 않고, 단순히 가정만 함. 연산 자체는 문제가 없으며, input이 static했는지 아닌지에 따라 trace의 안전성이 결정됨 - 앞서 다룬 “입력에 따라 trace가 달라지는” 문제와 같음
Q:
jit.trace나jit.script로 직접 최적화할 부분을 지정해서 kernel fusion을 했는데, PyTorch 버전 업그레이드로 Dynamo를 지원하면서 학습 throughput이 크게 올랐습니다. Dynamo가 최적화까지 직접 수행한다고 이해해도 될까요?A: Dynamo 자체는 graph capture를 담당하고, fusion·codegen 같은 최적화는 Inductor 등 backend가 수행합니다. TorchScript에도 자체 JIT 최적화 경로가 있으므로 “TorchScript는 최적화가 없다”는 뜻은 아닙니다. Throughput 향상은 Dynamo가 tracing할 수 있는 범위가 더 넓어서 추가 최적화가 가능했거나, trace에 적용되는 최적화 수준 자체가 더 높았기 때문일 수 있습니다.
Q: Dynamo가 CPython과 통합됐다는 것이 CPython의 플러그인 형태로 동작하는 건가요?
A: Dynamo는 CPython에 내장된 plugin이 아니라 CPython이 제공하는 frame evaluation API(PEP 523)를 사용하는 C extension입니다. Compile된 함수가 실행되는 동안 frame evaluation 함수를 교체해 bytecode를 분석하고 변환합니다.
PyTorch 2.0의 해법: TorchDynamo
jit.trace와 jit.script 모두 한계가 있었고, PyTorch 2.0은 그 대안으로 Dynamo를 도입했습니다.
Dynamo는 별도의 Python subset interpreter를 만들지 않고 CPython의 frame evaluation API를 사용해 bytecode를 분석합니다. 이를 통해:
- TorchScript subset으로 코드를 다시 쓸 필요가 없음. capture 가능한 구간은 컴파일하고 나머지는 graph break·skip으로 Python 실행에 넘김
- Guard로 입력 의존성을 검증하고, 조건이 달라지면 재컴파일하는 안전한 tracing (
jit.trace의 검증 없는 입력 의존 문제 해결) - Trace 불가능한 구간을 자동으로 식별하고 분할하여 안전성 확보 (단, 항상 분할·재개가 가능한 것은 아니며 이 경우 해당 함수는 컴파일을 포기하고 eager로 실행됩니다 — 뒤의 “Resume이 불가능한 graph break: skipped functions” 참고)
Python 기초: CPython 동작 방식
Dynamo가 frame 단위에서 bytecode를 분석하므로, 먼저 CPython이 코드를 실행하는 방식을 이해할 필요가 있습니다.
Python 코드가 실행되면 CPython이 소스 코드를 bytecode로 변환하고 VM의 evaluation loop에서 실행합니다. Dynamo는 이 실행을 그대로 기록하지 않습니다. 대신 bytecode instruction을 순서대로 symbolic execution(실제 값 대신 값을 나타내는 기호를 두고 명령을 따라가며 그 효과만 기록하는 방식)하면서 Python 값과 tensor 연산을 추적하고, 컴파일 가능한 tensor 연산을 FX graph에 추가합니다.
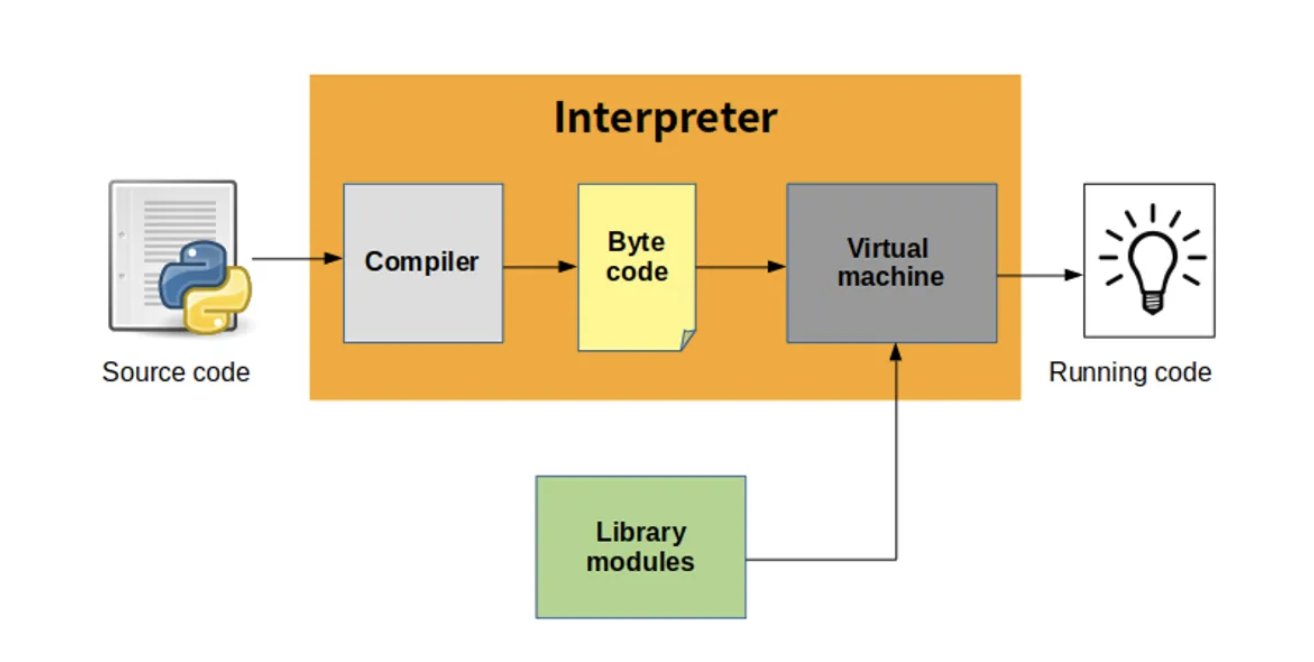
CPython의 기본 동작은 다음과 같습니다:
- CPython을 초기화
- 소스 코드를 code object로 컴파일 (compiler)
- Code object 내의 bytecode를 실행 (virtual machine)
Dynamo는 이 code object를 frame에서 받아 별도의 bytecode analysis와 transformation을 수행합니다.
Python VM 구조
Dynamo는 CPython frame evaluation API로 frame 단위에 개입합니다. Python VM은 다음 계층으로 나눠 볼 수 있습니다:
- Evaluation loop - code object에 들어 있는 bytecode를 스트리밍 방식으로 하나씩 읽어 실행하는 루프
- Frame - 함수 단위로 관리되는 데이터 구조(per-function data structure). 각 함수 호출 시 새로운 frame이 생성되며, frame은 code object 참조·local 변수·value stack을 담음. Evaluation loop(
_PyEval_EvalFrameDefault)은 frame 안에 있는 것이 아니라 frame을 인자로 받아 실행하는 함수 - Call Stack - 여러 개의 frame이 쌓여 함수 호출 관계를 관리. 함수 호출 시 새로운 frame이 추가되고, 종료 시 제거됨
- Thread - 각 thread는 독립적인 call stack을 가짐. 단 기본 빌드에서는 GIL 때문에 한 시점에 한 thread만 evaluation loop을 실행하며, C extension(PyTorch kernel 등)이 GIL을 놓는 동안에만 다른 thread가 실행됨. GIL 없는 free-threaded 빌드(
python3.14t)는 3.14에서 공식 지원되지만 별도 빌드이며, 이 강의는 기본 빌드를 전제로 함 - Interpreter - 여러 thread가 모여 하나의 Python interpreter를 구성. 공유 데이터(예: imported modules)를 관리
- Runtime - VM의 global state
구현 세부는 버전에 따라 다릅니다. CPython 3.10까지는 frame이 PyFrameObject로 heap에 하나씩 할당되어 f_back으로 연결됐고, 3.11부터는 _PyInterpreterFrame이 thread별 연속 메모리에 놓이며 PyFrameObject는 필요할 때만 만들어집니다(3.14 기준 Include/internal/pycore_interpframe_structs.h). 위 그림은 두 버전에 공통인 개념만 담았습니다.
Dynamo의 동작 원리
Dynamo는 bytecode를 분석하면서 tensor 연산을 FX graph로 수집합니다. Python 동작을 graph에 포함할 수 없는 지점에서는 graph break를 만들고, 앞에서 수집한 graph를 compiler backend로 전달한 뒤 Python 실행을 재개합니다.


위 다이어그램에서 색칠된 부분이 trace 불가능한 graph break 지점이고, 나머지 구간이 각각 하나의 trace가 됩니다. 분할된 trace들은 다음과 같은 방식으로 실행됩니다:
- Trace 진입 전, 현재 상태가 해당 trace를 수행할 수 있는 조건을 만족하는지 Guard로 검사
- 조건이 만족되면, 해당 trace에 대해 최적화된 compiled function을 호출
- Trace가 끝나면 (graph break 지점까지만 실행), tracing 불가능한 구간을 원래 방식으로 실행
- 이후 다음 trace 진입 시, 다시 Guard로 조건을 확인하고 최적화된 trace를 활용
이 trace를 찾아가는 과정 자체가 recursive합니다. Graph break 지점까지 trace를 수행하고, 최적화된 코드를 생성한 뒤, 다시 시작할 수 있는 지점을 찾아 새로운 trace 탐색을 시작합니다.
CPython과의 통합
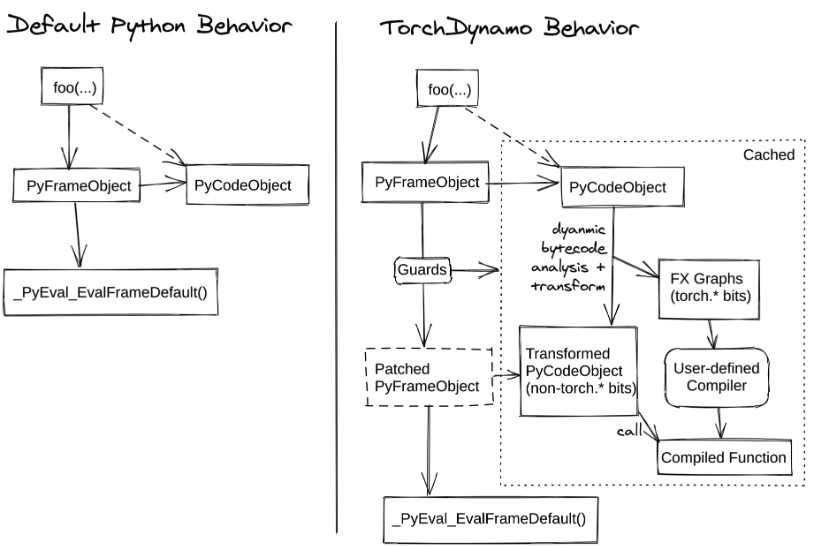
Dynamo는 CPython의 frame evaluation API를 이용해 frame 실행에 개입합니다. 아래 그림의 왼쪽은 Python의 기본 동작, 오른쪽은 Dynamo가 frame evaluation을 교체한 모습입니다:
참고 1: https://docs.pytorch.org/docs/2.14/user_guide/torch_compiler/torch.compiler_dynamo_overview.html
Python의 기본 동작 (왼쪽):
- 함수가 호출되면 새로운 frame object가 생성
- Frame 내부의 code object는 이미 컴파일되어 있으므로 바로 실행 가능
- Evaluation loop이 code object의 bytecode를 해석하며 함수 실행
Dynamo의 동작 (오른쪽):
- 함수
foo를 만나면 frame object를 만드는 것까지는 동일 - 해당 함수가 이전에 tracing된 적이 없으면, frame에 붙어 있는 code object의 bytecode를 분석하여 tracing을 시도
- Function call과 return을 따라가면서 graph break가 나올 때까지 추적한 뒤, 최적화된 코드를 생성
Dynamo는 CPython 소스를 수정하지 않습니다. CPython이 제공하는 frame evaluation API(PEP 523) 로 C 확장에서 frame 실행 함수를 교체하고, frame 단위로 개입해 bytecode를 분석하고 변환합니다.
이때 frame 실행 함수가 항상 교체되어 있는 것은 아닙니다. torch.compile로 감싼 함수가 호출되는 순간에 교체되고 그 호출이 끝나면 원래대로 복원되므로, Dynamo는 compile된 함수의 호출 범위 안에서 만들어지는 frame에만 개입합니다. 그 밖의 일반 Python 코드는 영향을 받지 않습니다.
개입한 frame이라고 해서 모두 tracing을 시도하는 것도 아닙니다. Frame마다 다음과 같이 판별합니다:
- 이미 tracing되어 cache된 code object → guard 검사 후 transformed bytecode를 재사용
- Tracing할 이득이 없거나 불가능한 코드(내장 함수, stdlib, torch 내부 구현 등) → skip 목록(
torch/_dynamo/trace_rules.py)에 따라 원래 방식으로 실행 - 그 외 → tracing 시도. 이때 trace 중에 만나는 함수 호출은 가능하면 부모 trace에 inline되며, graph break로 생긴 resumed function처럼 별도 frame 단위 컴파일이 필요한 경우에만 새로운 tracing이 시작됩니다.
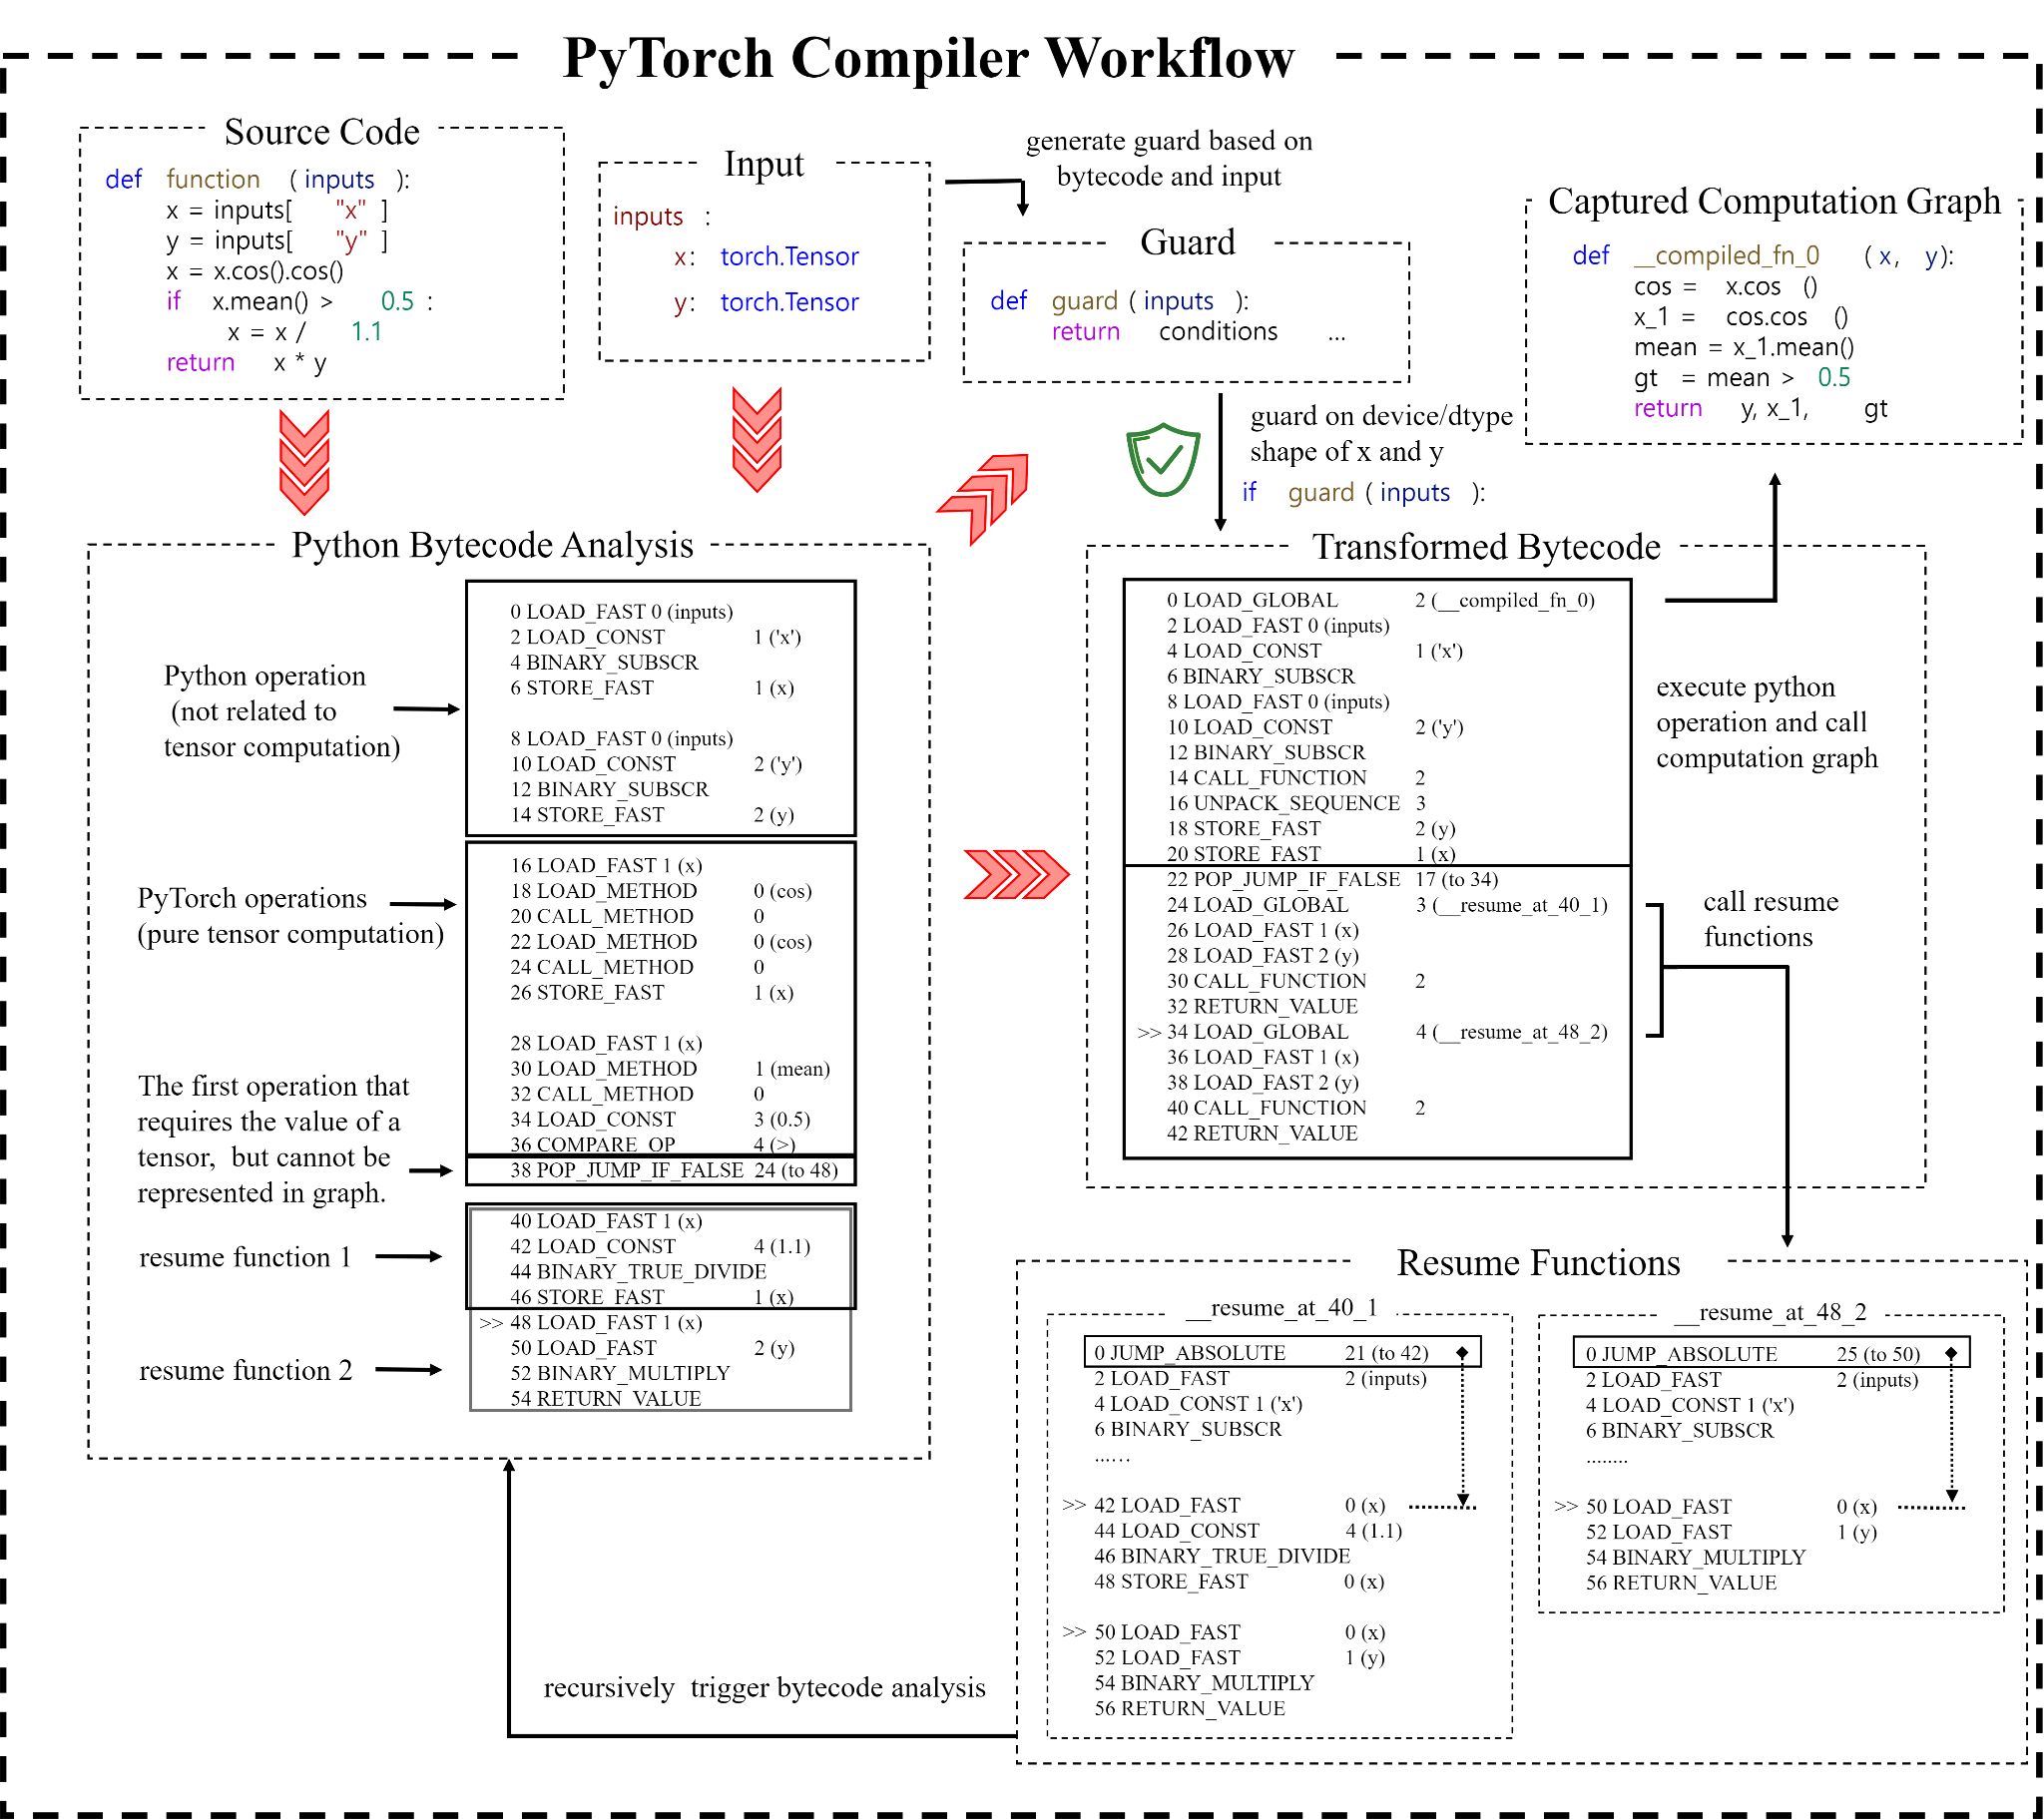
참고: https://depyf.readthedocs.io/en/latest/walk_through.html
위 다이어그램이 Dynamo의 내부 흐름입니다. 그림의 순서대로 Python bytecode 분석 → guard 생성 → computation graph(FX graph) 캡처 → transformed bytecode와 resume function 생성의 과정을 거칩니다. 캡처된 graph를 backend가 컴파일하는 단계는 뒤의 Device Backend 통합 절에서 다룹니다.
여기서 처음 등장하는 FX Graph는 torch.fx 모듈이 제공하는 그래프 형태의 IR(intermediate representation)입니다. 모델의 tensor 연산을 node로, 연산 사이의 입출력 관계를 edge로 표현합니다. Dynamo는 bytecode를 분석하면서 발견한 tensor 연산을 torch.fx.GraphModule에 추가하고, 이후 compiler backend는 이 graph module을 입력으로 받습니다.
Trace 생성 과정
Trace 생성의 입력과 결과물은 다음과 같습니다.
입력: 실행할 bytecode와 처리할 input. Tensor의 데이터 값은 dynamic input으로, tensor의 메타데이터(Python class, dtype, device, requires_grad, dispatch key, ndim, shape/strides 등)와 그 외 Python 값은 static input으로 가정합니다. 즉 기본적으로 그래프는 입력 tensor의 shape에 대해 specialize됩니다.
생성: Dynamo는 bytecode와 example input을 symbolic execution으로 분석해 graph break 전까지 FX graph를 만들고, 이 graph를 호출하도록 bytecode를 변환합니다. Guard, transformed bytecode, compilation 결과는 cache entry에 저장됩니다.
Caching된 최적화 코드의 구성 요소:
- Guard (static input 검증 로직 - tensor 메타데이터와 그 외 Python 값이 이전과 동일한지 확인) - 이전에 기록된 trace를 재사용할 수 있는지 확인
- Captured FX Graph - 실행할 최적화된 연산 그래프
- Transformed bytecode - FX Graph를 호출하는 bytecode와, 다음 코드로 넘어가기 위한 부분 포함
- Resumed functions - graph break 이후 실행을 재개할 함수. Branch에서 break가 발생한 경우, 분기에 따라 여러 개의 continuation이 존재할 수 있음
Resume이 불가능한 graph break: skipped functions
지금까지의 설명은 graph break 지점에서 graph를 분할하고 resumed function으로 실행을 이어갈 수 있는 경우를 다뤘습니다. torch.compile(fullgraph=True)는 graph break가 생기면 에러를 내고, 기본값 fullgraph=False는 graph break 지점에서 분할해 계속 진행합니다. 그런데 fullgraph=False라도 항상 resume bytecode를 만들 수 있는 것은 아닙니다. 다음과 같은 경우에는 해당 frame의 compilation을 중단하고 이후 호출을 eager mode로 실행할 수 있습니다:
- 반복문(loop) 내부에서 발생한 graph break
- 대부분의 context manager 내부에서 발생한 graph break
try블록 내부에서 발생한 graph break- 앞서 다룬 recompile limit(
recompile_limit)에 도달한 경우 - 일부 컴파일러 내부 에러
이렇게 “skip”되는 범위는 기본적으로 해당 frame(함수) 하나로 한정됩니다. 즉 skip된 함수 안에서 다른 함수를 호출하면, 그 안쪽 함수는 별도로 컴파일이 시도됩니다. 단, recompile limit 초과는 예외로, 이 경우 해당 frame과 그 안에서 호출되는 함수들 모두 새 컴파일이 중단됩니다(FrameAction.RUN_ONLY). 이미 만들어진 cache entry는 guard를 통과하면 계속 재사용되고, 맞는 entry가 없을 때만 eager로 실행됩니다.
Dynamo 원리 정리
지금까지의 내용을 함수 frame 하나의 관점에서, 일반적인 Python 실행과 비교해 정리하면 다음과 같습니다. 아래 그림은 frame 하나가 호출됐을 때 cache entry의 guard 검사부터 resumed function으로 이어지는 흐름입니다.


일반적인 Python 실행 (Dynamo 없음):
- 함수가 호출되면 새로운 frame object가 생성
- Frame의 code object는 이미 bytecode로 컴파일되어 있으므로 바로 실행 가능
- Evaluation loop이 bytecode를 하나씩 해석하며 실행 — CPython 3.11부터는 adaptive specialization 같은 자체 최적화가 있지만, tensor graph capture나 backend compilation은 하지 않음
처음 실행될 때 (trace 생성):
- 함수가 호출되어 frame이 만들어지면, Dynamo가 frame evaluation API(PEP 523)를 통해 개입
- Frame의 bytecode를 분석하여 graph break가 나올 때까지 tensor 연산을 FX Graph로 수집
- Guard(static input 검증 조건), transformed bytecode, resumed function을 함께 cache
- Graph break 이후의 코드는 resumed function의 frame에서 같은 과정을 재귀적으로 반복
다시 실행될 때 (trace 재사용):
- 등록된 cache entry들을 순서대로 돌며 Guard를 검사하여, 이전 trace의 전제(static input)가 여전히 유효한 entry가 있는지 확인
- 통과하는 entry가 있으면 그 cache된 최적화 코드를 그대로 실행 — 추가 컴파일 없음
- 모든 entry가 실패하면 recompile하여 새로운 cache entry를 추가. 단
recompile_limit(기본 8)을 넘으면 이후 컴파일은 중단되고 eager로 skip 실행
이 guard 검사를 의사코드로 쓰면 다음과 같습니다. 하나의 compiled code object가 여러 cache entry를 가질 수 있고, 호출될 때마다 순서대로 검사합니다:
for guard, code in get_cache_entries():
    if guard(L):
        return code(a, b)
recompile_and_add_another_cache_entry()
재컴파일은 무제한으로 반복되지 않습니다. torch._dynamo.config.recompile_limit(기본값 8, 과거 cache_size_limit이라는 이름으로도 여전히 alias됨)은 같은 ID_MATCH 객체(예: 같은 nn.Module 인스턴스)에 대한 cache entry 개수 상한이고, torch._dynamo.config.accumulated_recompile_limit(기본값 256)은 하나의 code object에 쌓인 전체 cache entry 개수 상한입니다(torch/_dynamo/cache_size.py). 프로세스 전체 상한은 아닙니다. 상한을 넘으면 그 이후의 컴파일 시도만 중단되고 해당 함수는 eager로 skip 실행되며, 이미 만들어진 cache entry들은 여전히 guard를 통과하는 한 재사용됩니다.
Automatic dynamic shapes: torch.compile의 기본값(dynamic=None)은 처음에는 shape을 static으로 가정하고 컴파일합니다. 이후 shape이 달라져 guard 실패로 재컴파일이 발생하면, 단순히 새 shape에 다시 specialize하는 대신 dynamic shape을 지원하는 그래프로 전환을 시도합니다(PyTorch 2.1부터 기본 동작). dynamic=True는 첫 컴파일부터 가능한 한 dynamic한 kernel을 만들려 시도하고(일부 연산은 어차피 specialize됨), dynamic=False는 dynamic kernel을 만들지 않고 항상 specialize합니다. 자동 전환은 기본값 None에서만 일어납니다.
Dynamo는 bytecode analysis로 FX graph와 guard를 생성하고, guard가 유효한 동안 compilation 결과를 재사용합니다. Static하게 결정할 수 있는 Python 값은 graph capture 중 평가하고, runtime tensor 계산은 FX graph에 남깁니다. 앞에서 본 out-of-order execution과 trace cache는 runtime 정보를 쓴다는 점만 Dynamo와 같고, 구현 방식은 다릅니다.
IR Lowering
PyTorch 2.x compiler stack은 graph를 backend가 처리할 수 있는 operator 집합과 내부 IR로 변환합니다. 아래 그림은 Inductor를 사용하는 대표적인 경로이며, 실제 decomposition 단계와 사용되는 IR은 backend 및 graph에 따라 달라질 수 있습니다:
1. Dynamo → FxGraph (Torch IR)
Dynamo가 생성하는 FX Graph는 Torch IR로 표현되며, 비교적 상위 레벨의 추상화로 되어 있습니다. Lowering이 많이 이루어지지 않은 상태입니다.
2. AOT Autograd → FxGraph (Aten IR)
Gradient 계산이 필요할 경우 이 단계에서 forward와 backward를 한 graph에 담은 joint graph를 만들고, 이를 forward/backward 두 graph로 나누는 partitioning을 수행합니다. inference처럼 gradient가 필요 없으면 joint graph 생성과 partitioning만 생략하고, functionalization(in-place 연산을 out-of-place로 바꿔 부수효과 제거)과 decomposition(복합 op을 더 작은 ATen op으로 분해)은 그대로 거칩니다. 이 과정은 Week 4에서 자세히 다룹니다. Inductor 경로에서 이 단계의 출력은 decomposition이 적용된 Aten IR이며, 더 낮은 Prims IR로 내리는 것은 별도 경로입니다.
3. Inductor → Loop-Level IR → kernel 소스
Lowering된 IR을 받아 Inductor 내부의 Loop-level IR로 변환하고, 이 단계에서 fusion 같은 최적화를 수행합니다. Loop-level IR은 Inductor 밖으로 나가지 않으며, 마지막에 codegen이 GPU용 Triton kernel 소스(torch/_inductor/codegen/triton.py)나 CPU용 C++/OpenMP 소스(cpp.py)를 생성합니다.
4. Triton (Backend)
Triton compiler가 생성된 kernel 소스를 PTX/cubin으로 컴파일하고, Inductor의 wrapper 코드가 이를 실행합니다.
Torch IR, Aten, Core Aten, and Prims IR
PyTorch compiler 문서에서는 backend가 받을 수 있는 operator 집합을 다음과 같이 구분합니다. 모든 graph가 아래 집합을 순서대로 전부 거치는 것은 아닙니다:
- Torch IR - Python 코드 수준에서 보이는 모든 연산자(operators)가 포함된 가장 상위 레벨의 IR. PyTorch이 지원하는 2,000개가 넘는 연산자에 해당 (PyTorch 2.0 발표 시점 기준 수치)
- Aten IR - Torch IR을 약 750개의 canonical한 연산자로 정리한 IR (PyTorch 2.0 발표 시점 기준 수치). 기존에 이미 PyTorch를 지원하고 있는 backend가 사용 (Intel CPU, NVIDIA GPU 등)
- Core Aten IR - Aten에서 더 작고 표현이 간결한 subset으로 정리한 193개의 operations(PyTorch 2.14
torch.compiler_ir문서 기준). 반드시 저수준의 ops를 의미하는 것은 아니며, avgpool2d, convolution 등의 high-level ops도 포함 - Prims IR - Core Aten과 비슷하지만, 타입 정보와 broadcasting을 명시적으로 표현하여 backend 구현을 단순화할 수 있는 primitive 집합. 내부 operation 수는 PyTorch 버전에 따라 달라집니다.
아래 코드는 이 lowering에 사용되는 decomposition table을 구성하는 예시입니다:
decomp_table = torch._decomp.get_decompositions([
    torch.ops.aten.hardtanh,
    torch.ops.aten.clamp,
    torch.ops.aten.isnan,
    torch.ops.aten.ge,
    torch.ops.aten.bitwise_or,
    torch.ops.aten.scalar_tensor,
    torch.ops.aten.where,
    torch.ops.aten.le,
])
AOTAutograd와 backend compiler는 decomposition table을 사용해 상위 연산을 더 작은 연산으로 변환할 수 있습니다. 어떤 decomposition을 적용할지는 compilation 경로와 backend 설정에 따라 달라집니다.
참고: https://docs.pytorch.org/docs/2.14/user_guide/torch_compiler/torch.compiler_ir.html (본문의 op 개수는 이 2.14 문서 기준)
Device Backend 통합
사용자 관점
모델을 만든 뒤 torch.compile(model)을 호출하면 컴파일 설정이 붙은 모델이 반환됩니다. 이 시점에는 컴파일하지 않고, 실제 컴파일은 모델을 처음 실행할 때 일어납니다.
import torch

class MyModule(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.linear = torch.nn.Linear(100, 10)

    def forward(self, x):
        return torch.nn.functional.relu(self.linear(x))

my_model = MyModule()

# 이 줄만 추가하면 graph mode로 동작
# -> additive feature라 eager mode 동작에 영향을 주지 않음
my_model = torch.compile(my_model)

my_input = torch.randn(10, 100)

# 실제 컴파일은 첫 번째 실행에서 이루어진다
forward_output = my_model(my_input)
모델을 실행하면 Dynamo가 동작하여 trace를 생성하고, 등록된 backend가 호출되면서 컴파일이 수행됩니다. 첫 번째 실행 시에는 tracing과 compilation이 함께 진행되어 오버헤드가 있습니다. 이후 실행에서는 guard를 통과하는 cache entry가 있으면 그것을 재사용하고, shape 등 조건이 달라지면 새 entry를 추가로 컴파일합니다.
Custom Backend 추가
Custom backend를 등록하려면 Backend Object를 생성하고 function을 구현하여 등록합니다. FX Graph가 생성되면 해당 backend가 호출되어 컴파일을 수행하고, 결과를 runtime에서 실행하도록 설정합니다.
# 의사코드: my_compiler와 MyRuntime은 사용자가 구현하는 부분
# graph_module: torch.fx.GraphModule
# example_inputs: List[torch.Tensor]
def my_backend(graph_module, example_inputs):
    # graph_module은 FX graph
    my_compiled_model = my_compiler(graph_module)
    my_runtime_callable = MyRuntime()
    my_runtime_callable.set_model(my_compiled_model)
    return my_runtime_callable

my_compiled = torch.compile(my_model, backend=my_backend)

# 첫 실행 시 backend가 호출되어 실제 컴파일 수행
forward_output = my_compiled(my_input)
위 예제는 Inductor 대신 사용자 정의 backend를 Dynamo의 backend로 등록합니다. Inductor나 다른 backend를 지정할 수도 있습니다.
AOTAutograd 이후에 붙는 backend
위 my_backend처럼 Dynamo가 직접 호출하는 backend는 Torch IR(전체 torch/aten opset)로 표현된 FxGraph를 그대로 전달받습니다. 하지만 AOTAutograd를 거치고 나면 backend가 처리해야 할 opset이 줄어듭니다. AOTAutograd는 functionalization을 거친 ATen op graph를 만들고, decomposition table을 넘겨주면 그 표에 따라 더 작은 opset으로 분해합니다. Core Aten opset만 받으려면 torch._decomp.core_aten_decompositions()를 decompositions로 넘겨야 하며, 넘기지 않으면 분해 없이 functional ATen graph가 그대로 전달됩니다(aot_module_simplified의 기본값 decompositions=None).
Training(backward)까지 지원하면서 Core Aten만 구현하고 싶다면, backend를 torch._dynamo.backends.common.aot_autograd(fw_compiler=..., bw_compiler=...)로 감싸면 됩니다. 이때 각 compiler가 반환하는 함수는 functorch.compile.make_boxed_func로 boxed 처리해야 합니다:
from torch._decomp import core_aten_decompositions
from torch._dynamo.backends.common import aot_autograd
from functorch.compile import make_boxed_func

def my_compiler(gm, example_inputs):
    return make_boxed_func(gm.forward)

my_backend = aot_autograd(
    fw_compiler=my_compiler,
    bw_compiler=my_compiler,
    decompositions=core_aten_decompositions(),  # 없으면 functional ATen 그대로
)
Backend를 이름으로 등록해두고 싶다면(예: minifier에서 문자열로 backend를 지정하는 경우) torch._dynamo 의 register_backend 데코레이터를 사용합니다. 등록된 backend 목록은 torch._dynamo.list_backends()로 확인할 수 있습니다.
Q&A
IR Lowering 관련
Q: 상위와 하위 IR을 구분하는 이유는 무엇인가요?
A: 컴파일러에서 일반적으로 사용하는 접근 방식입니다. 상위 레벨에서 다양한 기능을 제공하는 Op들을 제한된 Op들의 조합으로 표현하는 것이 lowering입니다. 예를 들어 Torch IR의 수천 개 Op이 Prims까지 내려가면 123개(2.14 문서 기준)로 추려집니다. Op의 총 개수는 많을 수 있지만 구성하는 set 자체는 줄어들고, 개별 Op도 구체적이고 단순해집니다. 결과적으로 backend compiler는 제한된 수의 단순한 Op만 구현하면 됩니다.
Q: ATen IR과 Core ATen IR의 관계는?
A: 둘 다 device-independent한 공통 IR입니다. ATen IR 자체가 약 750개(PyTorch 2.0 발표 시점 기준)로 수가 많기 때문에, 그 아래로 더 내려가기 위해 Core ATen이라는 추가 lowering 단계를 거칩니다.
Q: IR들은 모두 device-dependent한가요?
A: 아닙니다. Prims 단계까지는 device-independent합니다. 이후 특정 디바이스(NPU, CUDA 등)에 맞춰 변환됩니다.
Q: Op을 줄이는 과정이 CISC → RISC 과정과 유사한가요?
A: Intel이 CISC를 구현할 때 내부적으로 RISC에 해당하는 micro-ops로 명시적으로 쪼갠 뒤 수행했던 방식과 상당히 유사합니다.
Dynamo 및 실행 관련
Q: 모델 실행 시 최적화는 어떻게 이루어지나요?
A: 첫 번째 실행 시에는 tracing과 compilation이 함께 진행되어 오버헤드가 있습니다. 이후에는 guard를 통과하는 cache entry가 있으면 그대로 재사용하고, 새로운 조건(예: 다른 shape)이 들어오면 그때만 추가로 컴파일합니다.
Q: MyRuntime은 어떤 용도인가요?
A: CUDA, NPU 등 특정 디바이스에서 코드를 실행하기 위한 환경을 셋업하고 제공하는 런타임입니다.
Q: Bytecode static analysis와 tracing의 구분은?
A: Tracing은 전체 과정을 추상적으로 표현한 것이고, bytecode static analysis는 tracing의 일부 과정에 해당합니다.
Q: TorchDynamo는 Python에서만 사용되나요?
A: 네. Dynamo는 CPython의 frame evaluation hook으로 동작하므로 Python으로 실행되는 모델에만 개입하고, libtorch(C++)에서 직접 실행하는 모델에는 관여하지 않습니다. Python 없이 배포하려면
torch.export로 graph를 뽑아 AOTInductor 등으로 컴파일하는데, 2.14의torch.export는 기본값strict=False에서 Dynamo 없이 Python interpreter로 tracing하고strict=True일 때만 Dynamo(torch._dynamo.export)를 사용합니다. 구현 자체는 대부분 Python이고 frame hook 같은 일부만 C로 되어 있습니다.
Q: 예제의 backend는 Inductor의 backend인가요?
A: 아닙니다. 이 예제에서는 Inductor를 사용하지 않고, 직접 구현한 function이 Dynamo의 backend 역할을 합니다. Inductor를 backend로 선택하거나, 별도의 backend를 붙이는 것도 가능합니다.
Footnotes
-
연산을 코드에 작성된 순서대로 즉시 실행하는 define-by-run 방식의 실행 모델. Week 1의 “Eager vs. Graph Mode”에서 개념을, Week 2에서 dispatcher를 중심으로 한 내부 동작을 다뤘습니다. ↩
-
PyTorch 1.0에서 도입된 그래프 캡처·배포용 서브시스템으로, 모델을 Python runtime 없이 실행 가능한 형태로 변환하는 것이 목표였습니다. 현재 TorchScript는 deprecated 상태이며 새 export 용도에는
torch.export가 권장됩니다. 이 절에서는 역사적 배경으로jit.trace와jit.script를 다룹니다. ↩ -
PyTorch 2.0의 기본 backend compiler. 캡처된 그래프를 받아 최적화된 kernel 코드를 생성하며, Week 1에서 Dynamo·Triton과 함께 PyTorch 2.0의 주요 ML 컴파일러 컴포넌트로 소개했습니다. ↩
-
OpenAI가 개발한 GPU kernel 작성용 언어이자 컴파일러. Week 1 Q&A의 “CUDA와 Triton의 차이점”에서 소개했습니다. ↩